
推荐系统相关
新闻的推荐系统是为了给信息流的用户推荐资讯 feed。接口返回的信息不一定会被外显曝光。
在瀑布流式的外显曝光场景下,重排能够减少用户的疲劳度。
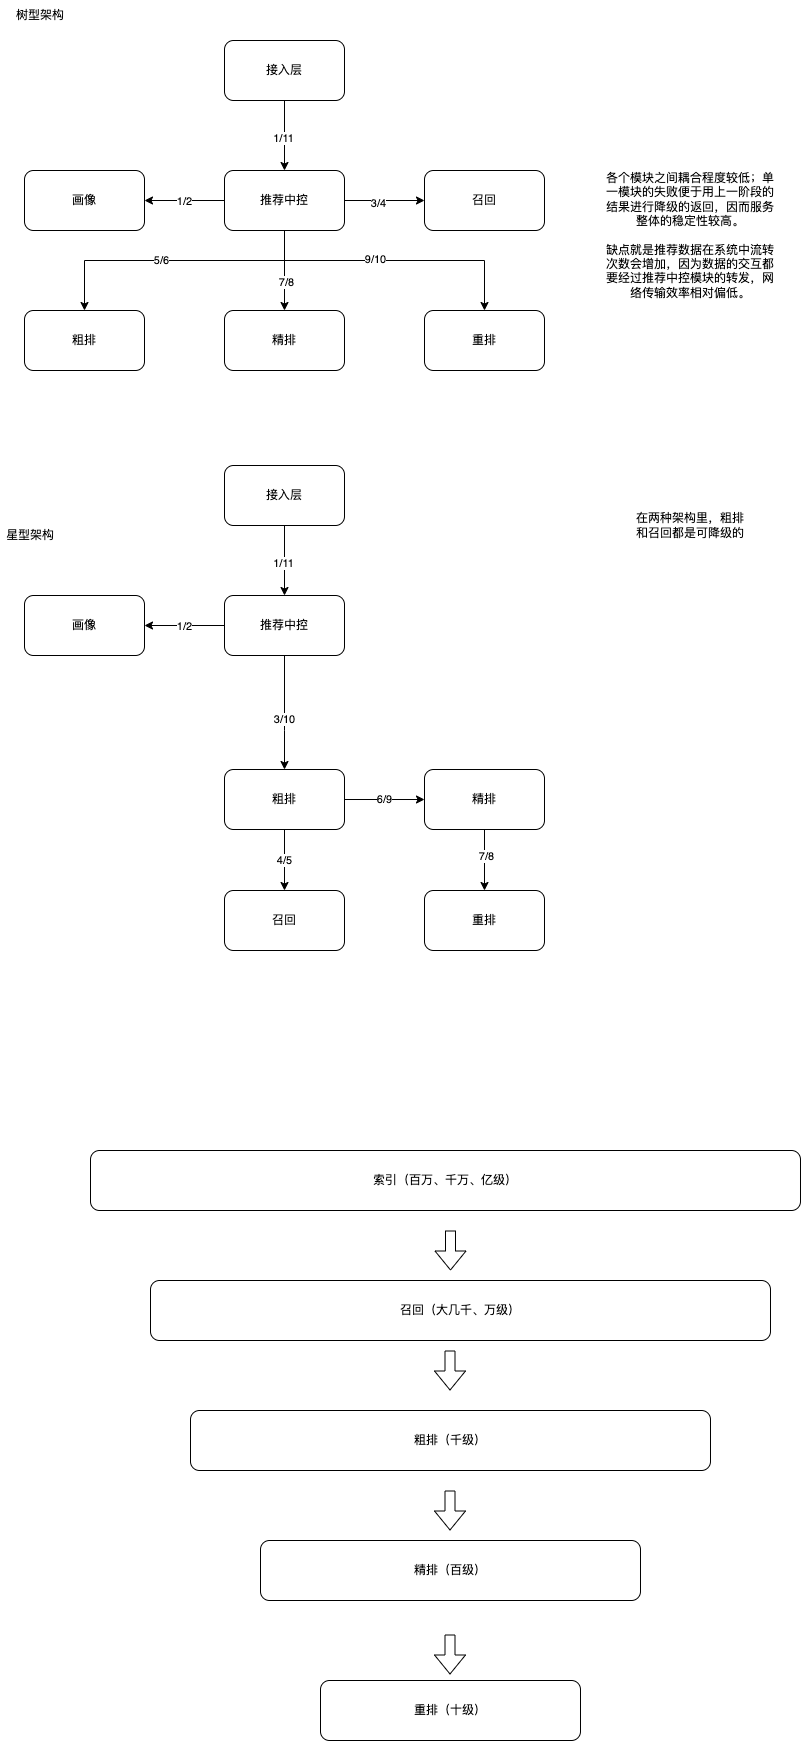
这就涉及到推荐系统的设计,流量要经过什么样的链路呢?
接入层、推荐中控、画像、召回、粗排、精排、重排。这些系统会形成星型架构和树形架构。
不同的架构之间有一个典型的优缺点需要取舍:链路长度会影响网络传输的最终效率,也会影响推荐系统的性能。
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles
2022-01-19
演进式架构
如果读一本书,没有附带正确的复盘(提出反馈并总结反馈),则浪费了这次读书的完整机会。 复盘需要经过痛苦的思索,把一些之前自己没有办法充分接受的观点,充分接受。 本书是一本讲战略的书。 这本书告诉我们很多概念,一旦加上“架构”前缀,突然就有了特殊的含义:架构特征(architectural characteristic)、架构量子(architectural quantum)、架构维度(architectural dimension)、架构模式(architectural pattern)。 新时代的架构愿景-怎样用敏捷的方式来拥抱变化? 架构难以被修改是由架构本身的不变性决定的,架构天然就是难以修改的。 有些人可能认为,就好像建筑业的实践那样,应该先完成这类架构设计,再开始开发。但需求是快速变动的这一事实告诉我们,我们可能要经常修改我们架构,以拥抱需求变化。 “需求总是在动态变化的”,比“架构应该是被预先确定”,更加像是一个事实(后者更加像是一个观点)。 当代的架构是: 不断努力的结果 【能够响应不断变化的需求和外部人员的反馈】 实施这种架构以替代传统架构,是需要决策者(技术...
2025-09-13
分布式事务
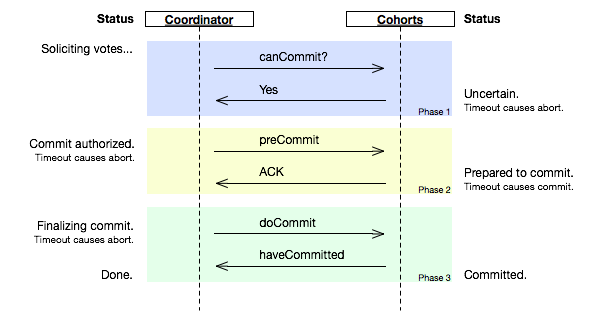
问题定义 对经典的电商场景而言:下单是个插入操作,扣减金额和库存是个更新操作,操作的模型不同,如果进行分布式的服务拆分,则可能无法在一个本地事务里操作几个模型,涉及跨库事务。 CAP 定义 根据 Eric Brewer 提出的 CAP 理论: Consistency:All Nodes see the same data at the same time。所有节点看到同一份最新数据。Brewer 论文里的 C 严格定义是 linearizability,工程语境下常被泛化为 strong consistency。 Availability:Reads and writes always succeed。非故障节点必须在合理时间内响应。 Partition tolerance:System continues to operate despite arbitrary message loss or failure of part of the system。网络分区时系统继续运行。在云原生环境(K8s 跨可用区、跨 region)这是默认前提,不是可选项。 由此诞生三种设计约束...
2025-07-15
系统的弹性
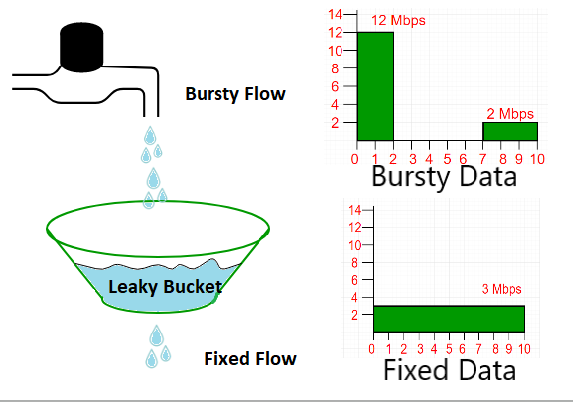
背景介绍 1999年,Dan Kegel 在互联网上发表了一篇文章,首次将 C10K 问题带入软件工程师的视野。在那个互联网勃兴的年代,计算机的运算处理能力,ISP 能够提供的带宽和网速都还十分有限,用户的数量也很少(那时候一个网站几百个人是很正常的事)。Dan Kegel 却已经敏锐地注意到极端的场景下资源紧张的问题。按照他的观察,某些大型的网络站点需要面对高达10000个客户端的并行请求。以当时的通行系统架构,单机服务器并不足以处理这个这个问题(当时绝大部分系统也没有那么大的流量,所以大部分人也没意识到这个问题)。因此,系统设计者必须为 C10K 问题做好准备。在那篇文章之中, Dan Kegel 提出了使用非阻塞异步 IO 模型,和使用各种内核系统调用黑魔法来提高系统 IO 性能的方式,来提高单机的并行处理能力。不得不说,这篇文章在当时很有先驱意义,它使得大规模网络系统的流量问题浮上了水面,也让人们意识到了系统容量建模和扩容提升性能的重要性。在它的启发下,C10K 问题出现了很多变种,从并发 C10K clients,到并发 C10K connections,到 C10K ...

2018-01-30
几种共识算法
达成共识的英文原文是 come to consensus。达成共识以后,也未必代表数据是完全一致的(Raft 算法中 leader 发出 append log 的 commit 命令即算达成共识?但如果中途数据丢失,则还是会有子节点数据不一致)。 在分布式环境下,多个系统协同工作的效率,受制于系统交叉点的性能。在需要达成分布式共识的场景下,分布式共识算法在保证系统安全性的同时,限制了全系统横向扩展的性能提升。 根据环境的不同,可以应用不同的共识算法。 在完全互信的环境下-私有链、私有的分布式数据库,节点之间可以使用 Paxos 或者 Raft 这种 leader 相对固定的算法。 在有限互信的环境下-联盟链,可以使用 PBFT。PBFT 算法是依据确定性的投票(可能是漫长的投票,也可能进入死循环)达到确定性一致的算法。 在没有互信的情况下-公有链,可以使用 POW/POS/DPOS/POA。这类算法是基于概率得到正确的最终一致性,性能比 PBFT 要稍微好点。 最好的共识算法应该模块化,例如 Corda 中的 notary,Hyperledger fabric 中的 solo/k...

2018-04-02
一个滚动重启的状态保存问题
很多时候滚动重启,都会导致状态丢失。比较好的设计方法是把服务本身设计成无状态的,然后在上游的服务上做好 failover,然后增加 standby server,让 sticky 数据 transmit 到 standby 机器上,让 request 失败以后可以自己由上游重传到 standby server。然后就可以滚动重启了。 这大部分场景下还要考虑幂等的问题。 这就看得出热配置热替换的重要性了。在大多数情况下,除了发布新的 feature 升级以外,都应该尽量用热配置来避免重启。

2022-01-19
Gergely Orosz 文章翻译-软件架构被高估,简明设计被低估
原文链接:《Software Architecture is Overrated, Clear and Simple Design is Underrated》