计算机图形学 33:同一场景的三种观察方式
一个盒子用软件光栅器画出来,用 CPU 射线求交画出来,再交给 GPU 显示,三幅图相近是否就足以证明三个程序处理了同一个场景?盒子的位置、相机的近远平面、点光源衰减、显示编码,只要有一项不同,比较就可能混入另外一个问题。
本篇把前面的几何、光栅、BVH、照明和固定步模拟接到一份场景数据上。先冻结三个确定时刻,对照共同的直接照明;再单独打开 CPU 阴影,解释画面变化;最后在真实 WebGPU 页面中播放同一条运动轨迹并编辑参数。每种观察方式都有明确的比较范围。
场景数据怎样成为共同输入
场景包含一块地面和两个轴向盒子,共 26 个三角形。图像为 128×128,正交相机的位置是 (5,4,7),观察目标是 (0,0.7,0),半高 3.2,近、远距离为 1 和 20。世界坐标沿用右手系,Y 向上;图像数组原点位于左上角。
地面对象编号为 1,两盒编号为 2、3;材质编号在这个小场景中与对象编号相同。对象 2 沿 X 运动,对象 3 静止。各面使用向外的单位几何法线,没有插入另一套平滑法线或纹理。
可编辑的源文件是 examples/computer-graphics/project33-scene.txt。它用带版本号的定长记录描述相机、光源、地面、运动和盒子:
1 | |
motion 的第一个整数是从零开始的盒子索引;JSON 中对应对象编号是 2。后面的字段依次是质量、刚度、初始位移、初始速度和场景位移系数。这个区别写进格式约定,避免把数组索引直接当作对象编号。
解析器拒绝错误版本、缺失记录、额外尾部字段、非有限数值、非法尺寸和退化相机。当前 CPU 入口支持 128²、160²及有界盒子数量;本篇 GPU 对照严格接受已验收的 128²双盒布局,不把任意配置文件解释成已验证的 GPU 场景。
配置变更后重新运行 CPU 程序,就会重建几何、参考图和 JSON。实验另外保存了几何、材质、光源、运动四份编辑后的配置;每份都重新解析再渲染,以检查编辑确实影响了共同输入。
先固定几何和模拟时刻
运动复用第 32 篇的 FixedSpringClock:m=1 kg、k=4 N/m、初态 x=1 m、v=0,固定步长 h=1/120 秒。盒子中心的 X 坐标在静止中心上增加 0.45x。这里是把一维弹簧位移映射到盒子的位置,没有计算盒子之间的碰撞或刚体动力学。
冻结时刻选择 tick=0、120、240,即 0、1、2 秒。每个 tick 表示已经完成的积分步数。相同终点在构造的 30、60、144 Hz 调度下得到逐位相同的状态;这里总共检查九个“调度—冻结时刻”组合。
冻结比较使用 current 状态。第 32 篇用于平滑显示的 previous/current 插值具有一个步长的延迟,若把插值位置与 current 参考混在一起,就已经不是同一模拟时刻。本篇浏览器播放采用预先计算的整数 tick 表,也没有在浏览器中另写一套弹簧积分。
几何也需要统一数值表示。CPU 先将静止世界顶点、反射率和 VP 矩阵量化为 float32;移动顶点再执行一次相同的 float32 位移量化。JSON 同时保留静止顶点、241 项运动记录和三份冻结 VBO。GPU 按静止顶点与 tick 位移重建上传数据,再与冻结 VBO 逐分量比较,三个时刻的几何误差都是零。
CPU 数学层的矩阵按行存储,WGSL 的 mat4x4f 按列解释上传数据。vp_columns 显式按列序列化。转置错误即使仍画出一个盒子,也会破坏后面的世界位置和深度检查。
相机相同,主射线也要有相同的裁剪范围
正交相机的主射线方向相同,像素中心改变的是起点。对于像素 (i,j),本篇先计算 NDC 坐标:
然后从权威 float32 VP 反投影 (u,v,0) 和 (u,v,1),得到近、远端 a、b。射线起于 a,方向为 (b−a)/‖b−a‖,有效距离上限取严格小于 ‖b−a‖的浮点数。近端可命中,远端排除,与清深度为 1、比较方式为 less 的光栅规则相配。
若 CPU 改用未量化的相机参数单独生成光学射线,会引入另一份投影数值;若射线无限延伸,还会命中光栅器已经裁掉的物体。本篇分别检查近面以前、范围内部、远面以后的三角形,避免只靠当前两个盒子的位置碰巧看不出差异。
CPU 主射线命中的世界位置再投影回屏幕,全部样本的最大偏差约 5.68×10⁻¹⁴ 像素。软件光栅沿用 1/256 像素固定格,世界位置插值回投影的最大偏差约 0.001822 像素,落在半格 1/512 像素以内。两者的采样位置存在数值差异,不能要求所有浮点颜色逐位相等。
共同照明先不含阴影
点光源位于 (−3,6,4),强度参数 I=45,人工填充项 A=0.06。对位置 p、单位法线 n、线性 RGB 反射率 ρ,共同基线计算:
Lambert BRDF 提供 ρ/π,点光源提供反平方项,法线与入射方向提供余弦。RGB 强度是本实验一致使用的线性渲染参数,没有进行显示器亮度标定。A 是人工填充,不能把它解释为已经求得的环境间接光。
一个可以手算的检查是 p=(0,0,0)、n=(0,1,0)、光源 (0,2,0)、I=4π、A=0.05、ρ=(0.2,0.4,0.6)。距离平方为 4、余弦为 1,因此 L=(0.21,0.42,0.63)。程序在生成图像以前先验证这项数值。
CPU 光栅从三角形插值得到 p;CPU 光追通过 BVH 得到最近主射线命中;GPU 光栅通过片元插值得到 p。三者随后使用同一个直接照明公式。此处“CPU 光追”指三角形主射线求交与后面的有限阴影射线,没有执行第 21 篇的多跳随机路径追踪。
以下两图分别为 tick=120 的 CPU 光追和软件光栅结果。每张源图只有 128²;显示时放大样本不会提高原始分辨率。


边界、颜色和覆盖分别检查
不同光栅实现的边界覆盖规则、内部精度及三角形边量化不一定相同。本篇预先生成保守边界掩码:像素中心到任何投影三角形边的距离不超过一个像素就排除出内部浮点误差统计,包括面内对角线和被遮挡面的投影边。它不是只沿可见轮廓生成的掩码。

排除边界不会隐藏整幅图的覆盖情况。对象编号和前景覆盖在全部 16,384 像素上另行比较;内部位置、深度、RGB 才使用排除边界后的有效前景样本。当前三个时刻,CPU 光栅与主射线的全图对象差异和覆盖差异都是零。
| tick | 内部前景样本 | CPU 光栅最大线性 RGB 差 | GPU 最大线性 RGB 差 | GPU 内部线性 MSE |
|---|---|---|---|---|
| 0 | 4157 | 3.8674×10⁻⁶ | 3.6427×10⁻⁶ | 4.8121×10⁻¹³ |
| 120 | 4206 | 1.0790×10⁻⁵ | 1.0763×10⁻⁵ | 6.2376×10⁻¹³ |
| 240 | 4218 | 7.3071×10⁻⁶ | 7.3059×10⁻⁶ | 5.5393×10⁻¹³ |
GPU 全图对象和覆盖差异也均为零。三个时刻分别排除 1778、1766、1775 个边界像素;剩余背景不计入内部前景 RGB 的分母。MSE 用每个有效前景像素的三个线性通道求平均,包含明暗面,不在 sRGB 截图上计算。
GPU 位置误差使用最大坐标分量差,三个时刻的最大值约 2.163×10⁻⁴;CPU 位置误差使用三维欧氏距离,最大约 2.363×10⁻⁴。这两个定义不同,不用它们直接比较“哪个更准”。GPU NDC 深度最大差约 1.138×10⁻⁵。
GPU 的内部验收界为线性通道差 2×10⁻⁵、位置分量差 10⁻³、NDC 深度差 2×10⁻⁵,并要求至少 1000 个有效样本、内部对象无差异。误差图也保留:下图是 CPU 光栅与主射线的逐通道绝对差乘 1000 后,经过同一高光压缩和 sRGB 编码显示。图像较暗对应当前差值较小;是否通过仍由原始浮点统计决定。

这些结果只覆盖当前相机、几何和三个冻结时刻,不能证明任意近面相交、退化三角形或全部 GPU 实现都具有相同误差界。
打开阴影后,差异来自可见性
共同基线把点光源可见性设为 1。CPU 阴影版本从命中点沿几何法线偏移 10⁻⁵,再向点光源发送有限射线。距离上限严格小于光源距离,光源后面的物体不应遮挡这个连接;偏移用来减轻当前尺度的自相交,并不是通用误差界算法。
如果这段连线有遮挡,公式中的直接光项归零,人工填充 A 保留。0、1、2 秒分别有 429、533、541 个像素的线性颜色因可见性而变化。独立验证用轴向盒子的 slab 求交和地面解析求交复核,共检查 1503 个变暗样本。
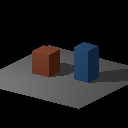
地面的硬边阴影来自理想点光源,盒子的背光面仍保留人工填充。这里没有软阴影采样、间接反弹、IBL 或反射材质。GPU 页面仍显示共同的无阴影基线,因此不能把这张 CPU 阴影图与 GPU 的亮地面当作同模型误差。
本篇没有随机数、采样种子或统计收敛判断。每个像素只有一个中心样本;锯齿不会因使用 BVH 或 GPU 自动消失。共同显示链路为 c/(1+c) 高光压缩,再编码 sRGB;所有比较发生在这两步之前。
GPU 怎样留下可复核的结果
GPU 将线性颜色与对象编号写入第一个 rgba32float 附件,将世界位置与 NDC 深度写入第二个附件。两者都不混合、不多重采样,通过 COPY_SRC 复制到 MAP_READ | COPY_DST staging buffer。每行 128×16=2048 字节,满足编码纹理复制的 256 字节行对齐要求。
mapAsync 完成后才读取数据,随后销毁临时纹理和 buffer。参考数组、回读通道和最终统计量都必须有限;否则立即失败。若只写 NaN > threshold,JavaScript 会得到 false,损坏数据可能被误判为通过。这个反例已加入独立验证。
真实执行使用 Chrome 154,适配器报告 vendor=apple、architecture=metal-3,device/description 为空字符串。记录保持这些实际字段,没有推断具体 GPU 型号。两份完整回读分别保存在 evidence/33-gpu-readback.json 与 33-gpu-negative.json,包含每个像素的两个附件。
负对照只把光强乘 1.25,几何、相机、时刻和反射率保持相同。三组最大线性差约为 0.04940、0.05381、0.05380,明显越过默认参考的容差;对象覆盖保持一致。这说明颜色检查能够检出此项输入不一致,不能把负对照的差值归因于 float32 舍入。
浏览器中已实际点击播放和暂停:tick 从 120 推进,暂停时停在另一个整数 tick。尺寸滑块改为 1.5、反射率系数改为 0.2、光强改为 2 后,盒子尺寸和明暗改变;恢复参数后回到共同基线。滑块修改后的画面不继续宣称与原始 CPU 参考相符。
也可以单独打开实验。GPU 负责三角形绘制,JavaScript 从 CPU 表中选择运动状态;这不是 GPU 动力学实现。播放按整数 tick 查表,在两秒窗口后循环,没有声称测得稳定帧率或 GPU 执行时间。
两个反例区分输入错误与模型扩展
把 tick=0 的 CPU 图与 tick=120 的 CPU 图错配,906 个像素的颜色或对象发生变化,最大线性差约 0.2679。这个错误只改变比较时刻,已经足以破坏验收,不能用“运动中的截图大致相似”替代冻结协议。
配置编辑测试在 tick=0 比较四份重新解析的源文件:几何改动影响 590 个像素,材质改动 769 个,光源改动 5043 个,运动系数改动 357 个。这里“影响”指对象不同或最大线性通道差超过 10⁻⁴;CSV 保留精确定义和数值。
这些输入错误与阴影扩展不同。前者违反共同输入,应被参考检出;后者明确改变可见性模型,应解释新增的阴影。只比较最终编码图片无法自动区分两种情况,因而回执同时保留几何、对象、位置、深度、颜色和配置。
练习与自检
练习 1:为什么不用无限长正交射线? 在当前相机的远面之后放置一个可见于无限射线的三角形,预测 GPU 光栅和两种 CPU 主射线的结果。
自检要点:无限射线可能命中它,GPU 裁剪和本篇有限主射线排除它。应先统一 near/far 有效范围,再比较对象和颜色。仅让相机方向相同不足以证明两种渲染器观察了同一场景。
练习 2:为什么 MSE 的分母不是 128×128×3? 假设只增加黑色背景面积,前景误差保持不变,分别说明全图 MSE 与内部前景 MSE 的变化。
自检要点:若背景完全匹配,全图 MSE 的分母变大、误差被稀释;内部前景 MSE 保持不变。当前算法另报全图覆盖/对象差异,再对掩码外有效前景求三个通道的平均,不能删除背景检查。
练习 3:光强增加 25%,颜色为何不整体增加 25%? 用共同公式计算新旧颜色比例,并判断被遮挡像素的情况。
自检要点:令 D=I max(0,n·ℓ)/(πr²),基线比例为 (A+1.25D)/(A+D)。A 保持不变,因此通常小于 1.25;阴影版本若直接项为零,则颜色只有 ρA,光强变化不改变它。显示高光压缩还会进一步改变截图上的比例,所以应在线性数据中核对。
复跑入口与资料
1 | |
从仓库根打开 http://127.0.0.1:8773/examples/computer-graphics/gpu33.html?data=build/project33.json,点击核对按钮;查看回读并操作播放、参数和负对照。修改配置后需要先重新生成 CPU JSON,不能仅替换图片。
附件保存三组参考/光栅/阴影/差值/掩码 PNG、四份编辑配置、三份 CSV 与默认 JSON。累计实现为 project33.hpp、project33_check.cpp、gpu33.mjs,实际 CPU 与 GPU 回执位于 writing-plans/computer-graphics/evidence/。本篇没有性能比较。
- PBRT 4 §5.2.1:OrthographicCamera,平行主射线和像素位置。
- PBRT 4 §9.2:Diffuse Reflection 与 §12.2:Point Lights,Lambert 与反平方项;§13.2讨论光源连线可见性。
- WGSL §13.3.1.4:Interpolation 与 矩阵构造,插值与列布局。
- WebGPU §11.2.2 与 §26.1.1,编码复制行布局和浮点附件能力。