计算机图形学 26:软件管线怎样映射为着色器
第 11 篇的软件光栅器已经能把网格变成颜色图,第 16 篇又把局部变换串成世界变换。到了 WebGPU,顶点变换、属性插值、深度测试和纹理采样由固定功能与着色器共同完成。迁移的难点在于让两条管线对同一批字节、坐标和颜色作出同一种解释。
本篇固定一个 128×128 场景:两个有重叠的倾斜四边形,共享一张 8×8 纹理,使用同一组 float32 MVP 矩阵。CPU 生成参考缓冲与诊断图,浏览器在真实 WebGPU 设备上渲染并读回颜色、辅助数据和深度附件。内部像素要求数值一致;几何边界单独统计,不把两种光栅器不同的覆盖规则伪装成错误。
先运行同场景实验
打开 CPU 与 WebGPU 对照实验。点击“运行 GPU 并核对 CPU”,再依次查看纹理颜色、UV、原始深度和差异位置。页面显示的是 GPU 附件读回值,不是 CPU 图片或预存截图。
实际验证日期为 2026-09-22。Codex 内嵌浏览器报告 Chrome/153.0.0.0,安全上下文为 true,适配器 vendor 为 apple、architecture 为 metal-3;device 与 description 字段为空,因此不据此猜测具体 GPU 型号。
正常深度测试下,5,170 个内部像素的对象编号全部相同。UV 最大绝对差为 ,颜色检查的 5,134 个样本全部在每通道 1 个码值的容差内,读回深度附件与 CPU 参考的最大差为 。另有 1,757 个边界带像素单列统计:对象编号和颜色没有不一致,UV 与深度最大差仍约为 与 。这些数字只描述本次固定场景与设备,不外推为跨 GPU 的逐位保证。
把两个物体的绘制顺序反过来后,颜色、辅助数据和深度三组读回缓冲逐字节不变。将深度比较故意改为 always 后,1,553 个像素的可见对象发生变化,其中 1,372 个内部像素对象号错误;页面明确拒绝该结果。正例说明共享约定成立,负例说明检查确实能发现遮挡错误。
一份场景,两种执行方式
CPU 程序继续复用累计的 scene.hpp、surface.hpp、math.hpp 和 color.hpp。场景树给出两个节点的世界矩阵,相机仍采用右手坐标、朝相机负 方向观察,投影后的 WebGPU 深度位于 。每个物体的矩阵计算完成后先量化为 float32,再同时写入 JSON 和 CPU 参考计算,避免把 CPU 的 double 输入优势算进对照结果。
两条路径的职责如下:
| 阶段 | CPU 参考 | WebGPU |
|---|---|---|
| 顶点变换 | C++ 矩阵乘法 | WGSL 顶点着色器 |
| 裁剪与覆盖 | 软件裁剪、1/256 固定点边函数 | 实现定义的硬件光栅化规则 |
| UV 插值 | 透视校正插值 | 默认 perspective, center 插值 |
| 深度 | 屏幕重心插值、strict less | depth32float、depthCompare:'less' |
| 纹理 | nearest 与 clamp-to-edge | nearest sampler 与 clamp-to-edge |
| 输出 | 线性 RGB 手动编码到 sRGB 码值 | WGSL 手动编码后写入 rgba8unorm |
跨实现对照应先固定输入语义,再比较可比的中间量。只比较最终彩色图时,矩阵转置、UV 翻转、深度错误和颜色空间错误可能互相抵消,画面“差不多”并不能定位原因。
坐标约定要写到每一道边界
场景与相机沿用前文的列向量记法:
WGSL 的 mat4x4f * vec4f 也按列向量使用。CPU 内存里的矩阵按行保存,不能直接交给 JavaScript 上传。导出的 16 个数改按四列排列,着色器读到的矩阵才与上式一致。平移量因此位于上传数组的第 12、13、14 个元素,而不是第 3、7、11 个元素。
裁剪空间经过透视除法后,WebGPU 的 NDC 中 ,。framebuffer 原点位于左上, 向下。本实验只在视口映射处翻转一次 ;纹理坐标另定义为
所以纹理上传的第一行对应图像顶部。坐标系、图片行序和 UV 方向是三项独立约定,不能用一句“WebGPU 是左手系”代替。
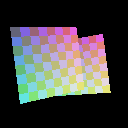
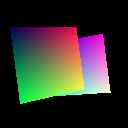
颜色图显示最终纹理结果;UV 图以红、绿通道编码 ,蓝通道区分两个对象。两张图中的几何轮廓一致,说明诊断量使用了同一覆盖结果。
布局错误通常仍是合法字节
每个顶点由三个 float32 位置分量和两个 float32 UV 分量组成,步长为 20 字节:
1 | |
顶点 fetch 的步长和偏移属于 vertex buffer layout。uniform 的布局是另一套规则。WGSL 中 mat4x4f 大小为 64 字节、对齐为 16 字节,后接一个 vec4f 对象编号,共 80 字节。本例为两个物体分别创建 uniform buffer,不使用动态偏移,也就没有把动态 uniform offset 的 256 字节限制误套到结构本身。
布局出错常常不会越界。把矩阵按行上传,16 个数仍然齐全;把 UV 偏移写成 8,buffer 也可能足够大。API 能验证字节范围,却无法知道这些合法字节是否表达了预期的数学量。参考实现因此直接读回 UV、深度和对象编号,而不是只等一张彩色图。
深度值需要同时检查着色器输出和附件
片元辅助附件保存 (u,v,position.z,object)。片元阶段的 position.z 已是 framebuffer 深度;独立的 depth32float 附件则保存深度测试实际写入的值。正常运行中,两者都与 CPU 参考比较,最大绝对差分别约为 。
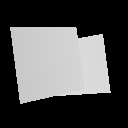
图中灰度只是把 映射到 0–255 便于观察,验证使用原始浮点数。两个表面深度接近,肉眼难以判断谁应遮挡谁;对象编号和浮点深度能直接回答这个问题。
故意将 depthCompare 改为 always 后,后画的物体覆盖先画物体,与相机距离无关。负对照造成 3,637 个颜色字节、18,871 个辅助附件字节和 4,651 个深度字节变化。该结果说明“反向绘制仍相同”不是偶然,因为错误深度状态会立刻破坏这项不变量。
边界差异为什么单独处理
CPU 光栅器把屏幕坐标量化到 1/256 像素并采用既定边规则。WebGPU 规范规定非 MSAA 时样本位于像素中心,但恰落在多边形边上的覆盖结果不承诺与这份软件实现逐位相同。浮点舍入还可能把几何边界推到样本中心的另一侧。
因此,CPU 先把对象轮廓周围半径两个像素标成边界带。内部像素执行严格数值断言,边界像素报告差异而不混入内部误差统计:
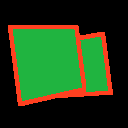
绿色是内部区域,红色是边界带。边界带不是免责区。对象、颜色、UV 和深度仍全部记录,只是不因允许的覆盖规则差异直接宣称实现错误。本次运行恰好连边界对象与颜色也一致,但文章不把这次观察升级成规范保证。
纹理边界还要再排除一层。nearest 采样在纹素分界线两侧会选择不同 texel;极小 UV 舍入即可改变离散颜色,而连续 UV 本身仍正确。本次有 36 个内部像素距离纹素分界不足 0.002 texel,不参与颜色断言,但继续参与 UV、深度和对象编号检查。
颜色转换只做一次
8×8 纹理存放线性 RGBA8 值,GPU 纹理格式为 rgba8unorm。采样得到的数值仍按线性 RGB 解释,片元着色器执行一次分段 sRGB 编码,再写入非 sRGB 的 rgba8unorm 颜色附件。CPU 使用同一分段函数生成参考码值。
若输入改成普通图片文件,其码值通常已经是 sRGB 编码,上传和采样策略就要随之改变。若输出附件改用 sRGB 格式,也不应保留当前手动编码。颜色空间错误的典型特征不是位置错,而是中间亮度系统性偏离,所以颜色断言与 UV、深度断言必须分开。
复跑方法
CPU 参考生成器没有随机数,也不测性能。运行:
1 | |
成功时输出固定场景的覆盖计数、边界带计数、矩阵布局和纹理模式。--help 返回用法;缺少输出目录、目录不存在或参数过多均返回失败。
浏览器实验可在仓库根目录启动本地静态服务:
1 | |
打开 http://127.0.0.1:8772/gpu26.html。正常运行、反向绘制、关闭深度负对照、再次正常运行分别验证正例、不变量、可检出的错误和恢复能力。验证页面会等待 GPU 读回,这属于实验开销,不代表实时应用应逐帧映射三个附件。
练习与答案
练习一:若一个列向量矩阵的平移为 ,上传给 WGSL mat4x4f 时三个值位于 16 个 float 的哪些索引?若误放到 3、7、11,会出现什么性质的错误?
答案:列布局下位于 12、13、14。放到 3、7、11 相当于把平移写进最后一行,矩阵不再执行普通仿射平移,还会改变裁剪坐标 ;透视除法后产生随位置变化的非线性畸变。
练习二:为什么不能要求 CPU 与 GPU 在三角形边界逐像素完全相同?怎样避免把真正的 UV 错误藏在“边界容差”中?
答案:两者的坐标量化、舍入和边界包含规则不同,恰在边上的样本可能归属不同。应先把小范围边界带单独标记,内部像素继续执行严格 UV 断言;边界带仍报告对象、UV、深度和颜色差异。容差按区域与量分类,不能整张图一概忽略。
练习三:把输出附件从 rgba8unorm 换成带 sRGB 转换的格式时,当前片元着色器中的手动 sRGB 编码应怎样处理?
答案:应去掉手动编码,让线性着色结果由 sRGB 附件写入转换编码一次。两者都保留会重复编码,使中间亮度偏亮;两者都没有则会把线性值直接当显示码值,通常显得偏暗。
模式速查表
| 问题 | 先固定什么 | 读取什么证据 |
|---|---|---|
| 几何位置不一致 | 矩阵方向、NDC、视口原点 | 对象编号与轮廓 |
| 纹理翻转或错格 | UV 定义、行序、sampler | 连续 UV 与离散颜色 |
| 遮挡错误 | 深度范围、比较函数、清除值 | 片元深度与深度附件 |
| 亮度不一致 | 输入与附件的颜色编码 | 线性值和最终码值 |
| 只有轮廓差异 | 样本位置与边界规则 | 内部区和边界带分开统计 |
参考资料与导航
- WebGPU 规范:Coordinate Systems,核对 NDC、深度范围和 framebuffer 方向。
- WebGPU 规范:Texture Formats与Polygon Rasterization,核对 sRGB 转换、样本中心、覆盖与深度插值。
- WGSL 2026-09-21 草案:Alignment and Size与Interpolation,核对 uniform 布局和默认浮点插值。
系列目录 · 上一篇:一次绘制怎样交给 GPU · 下一篇:为什么更多物体会变慢(待完成)。