JUnit4/JUnit5 注解
| junit4 | junit5 | 特点 |
|---|---|---|
| @BeforeClass | @BeforeAll | 在当前类的所有测试方法之前执行。注解在【静态方法】上。 |
| @AfterClass | @AfterAll | 在当前类中的所有测试方法之后执行。注解在【静态方法】上。 |
| @Before | @BeforeEach | 在每个测试方法之前执行。注解在【非静态方法】上。 |
| @After | @AfterEach | 在每个测试方法之后执行。注解在【非静态方法】上。 |
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles
2026-07-14
为什么叫"测试夹具":Fixture 的词源与跨领域漫游
测试夹具这个中文词带着工业感,让第一次听到它的开发者往往去搜索"是不是翻译错了"。词源确实如此:fixture 来自机械加工,后来进入电子测试领域,再由 Kent Beck 引入软件测试框架里。这个词在软件工程里覆盖的范围,也远比"单元测试"要宽。 从车间到代码 fixture 这个词在机械加工里有精确含义:在 CNC 车床或焊接台上,fixture 是一种工装,把工件固定在已知位置,让每次加工操作都从相同的起点开始。与 jig(引导刀具路径的夹具)不同,fixture 的职责只有一件事——把工件钳牢,消除定位误差。 词源上,fixture 来自拉丁语 figere(刺入、固定),经 fixura(固定物)演变为英语词汇,约在 16 世纪末进入法律语言,最初指"永久附着于不动产的动产"——嵌入墙体的管道、固定在地板上的书架,那些不能随意拆走的东西。 电子测试领域用法相似:一块 PCB 插入测试夹具后被固定在已知电气状态,探针才能重复施加相同的激励、在相同节点读取信号,排除接触不稳定的干扰。 三种用法的共同语义:将某个对象...

2018-06-19
如何做性能测试的问题下的答案
试着回答一下这个问题。 首先要划分系统类型:有状态还是无状态,业务系统还是存储系统。根据不同的业务场景,设立性能测试的目标:是要测 QPS,还是 TPS 还是 TPS,还是任何其他【性能】-从广义来讲,一个存储系统到底能够以多高的平均时延来管理大多的存储空间,可能也是性能的一种。 有了性能测试的目标,接下来就是拆解用例。如果把性能测试归为测试的话,测试就需要测试用例,测试用例只是用例的形式化表达。把用户的使用场景勾勒出来,把每一步拆解成的流程图或者时序图–我们已经得到了一个纸上的集成测试计划,只是没有跟性能挂上钩。 接下来就进入真正写测试用例的环节了。 我们的测试报告如果要涵盖足够立体的信息,则既要了解每一个环节/接口/API 的性能指标,又要了解整体的性能指标。 这个时候测试工具的覆盖面就很重要了。如果我们选择偏黑盒的测试工具,apache ab /JMeter,则我们的测试用例就要围绕着对外交互的 API写,也只能测到外围接口的性能。这样的测试用例写起来最简单,无需侵入任何内部代码中。 如果我们使用了 JMH 一类的工具,则可以自由编写对任何方法的测试用例。但需要对系统有非常...

2025-07-29
Java 浮点数精度问题深度解析——从 IEEE 754 到 BigDecimal
0.1 + 0.2 != 0.3——这可能是编程世界中最令人困惑的"Bug"之一。但它不是 Bug,而是 IEEE 754 浮点数标准的必然结果。本文将从二进制表示的底层原理出发,深入剖析浮点数精度丢失的根本原因,并给出 Java 中精确计算的完整解决方案。 Part 1: IEEE 754 标准详解 历史背景 在 IEEE 754 标准(1985 年首版,2008 年修订为 IEEE 754-2008)出现之前,不同的计算机厂商使用不同的浮点数格式,导致同一个程序在不同机器上运行结果不同。IEEE 754 统一了浮点数的表示和运算规则,成为几乎所有现代处理器和编程语言的基础。 浮点数的三个组成部分 IEEE 754 浮点数由三部分组成: 12345(-1)^S × 1.M × 2^(E - bias)S: 符号位(Sign) —— 0 正,1 负E: 指数位(Exponent) —— 偏移后的指数M: 尾数位(Mantissa) —— 小数部分(隐含前导 1) float 与 double 的内存布局 类型 总位数 符号位 指数位 尾数位...
2025-07-29
Java 集合框架完全指南
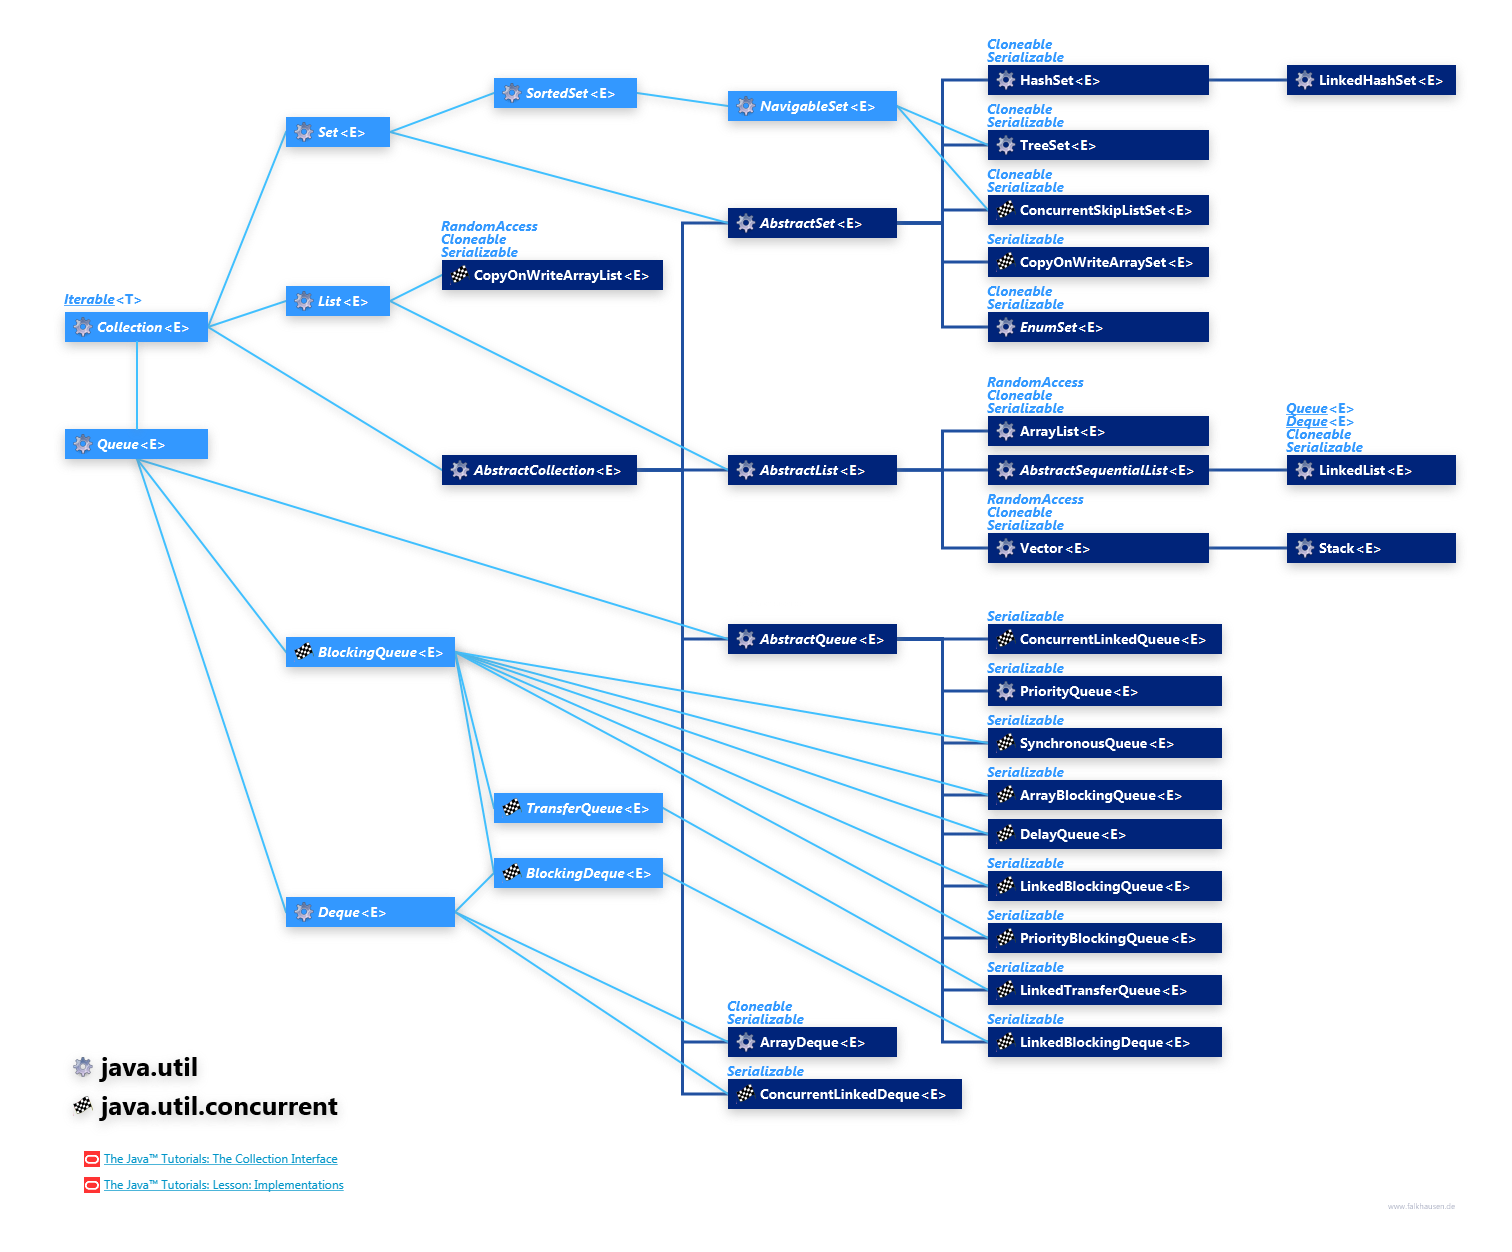
Java 集合框架完全指南 本文系统性地介绍 Java 集合框架的核心概念、实现原理和设计模式。内容涵盖集合框架体系结构、列表与队列机制、哈希表家族的扩缩容策略、缓存淘汰算法实现以及系统级扩缩容设计。通过深入分析源码实现和性能特征,帮助理解各集合类的适用场景和最佳实践。 第一章:全景导图 文章结构 模式总览 模式名 口诀 覆盖场景 扩容因子1.5倍 扩容1.5倍,平衡空间时间 ArrayList扩容、StringBuilder扩容 队列六操作 add/offer/put,peek,poll/take 所有队列实现的标准操作 优先级堆 小顶堆TopK,大顶堆调度 PriorityQueue、任务调度 延迟队列 getDelay负值出队,compareTo排序 DelayQueue、缓存过期、订单超时 扰动函数 高16异或低16,分散哈希冲突 HashMap哈希优化 2的幂容量 位运算取余,快速计算索引 HashMap、ConcurrentHashMap 树化阈值8 泊松分布概率,红黑树优化 HashMap性能优化 反树化阈值6 低于阈值退...
2025-07-29
Java 字符编码与 Unicode 完全指南——从 BMP 到增补平面,从代码单元到字形簇
“一个 char 就是一个字符”——这个直觉在 Java 中是错误的。一个 emoji 👨👩👧👦 在 Java 中占 11 个 char,但在用户眼中只是一个字符。本文将从 Unicode 的基础概念出发,深入剖析 Java 的字符编码机制,揭示 char、码点、代码单元、字形簇之间的层次关系。 Part 1: Unicode 基础——字符集的大一统 从 ASCII 到 Unicode 的演进 编码 年份 字符数 位宽 覆盖范围 ASCII 1963 128 7 位 英文字母、数字、控制字符 ISO 8859-1 1987 256 8 位 西欧语言 GB2312 1980 6,763 汉字 双字节 简体中文 GBK 1995 21,886 汉字 双字节 简繁中文 Shift_JIS 1982 ~7,000 变长 日文 Unicode 1.0 1991 7,161 16 位(最初设想) 多语言 Unicode 16.0 2024 154,998 21 位(实际) 全球所有文字 + emoji Unicode 之前的世界是编...
2026-09-07
从零构建现代搜索引擎(22):压缩向量与控制推理成本
第 18-19 篇用 float32 向量做 HNSW 搜索。512 维 float32 = 2KB/向量。1 万个 chunk 占 20 MB,尚可接受。但向量数增长到百万级时,内存开销达到 GB 级别——单机装不下,或者装得下但挤占了其他组件的内存预算。 本篇用量化减小向量体积,用缓存和批处理降低 embedding 推理的调用成本。 向量存储的成本账 内存占用 512 维 float32 向量的存储开销: 向量数 原始向量 含 HNSW 图 备注 10K 20 MB ~30 MB 教学语料 100K 200 MB ~300 MB 中等站点 1M 2 GB ~3 GB 大型站点 10M 20 GB ~30 GB 超出单机内存 HNSW 图的边(每节点 M 个邻居 × int32 node ID)增加约 50% 的额外开销。 推理成本 每次查询需要调用 embedding 服务编码查询文本。每次文档写入需要编码 chunk 文本。 操作 延迟(GPU) 延迟(CPU) 编码 1 条文本 ~5 ms ~50 ms 编码 100 ...