
Lombok 拾遗
sneakyThrow
1 | |
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles

2026-05-21
正则表达式如何变成自动机
DFA 和 NFA 已经把“字符串识别”拆成了状态、输入字符、转移规则和接受状态。正则表达式站在更高一层:开发者写 a(b|c)*,机器负责把它变成可以执行的匹配过程。 这篇文章只处理传统正则表达式的核心结构:字面量、连接、选择和重复。现代正则 API 还包含捕获组、环视、反向引用、贪婪/非贪婪策略等扩展;这些扩展属于工程实现层,不影响本文要展示的主线。 核心链路很短: 1regex text -> regex AST -> NFA design -> accepts(text) 本文不写正则 parser,直接手工构造 AST。前面文章已经展示过“字符串到 AST”的方法,这里把注意力放在第二步:一个正则 AST 节点怎样编译成 NFA。 正则表达式先变成结构 a(b|c)* 不是一串神秘字符。按传统正则语义,它可以拆成四种结构。 正则片段 AST 节点 含义 a Literal("a") 匹配一个字符 bc Concatenate(Literal("b"), Literal("c"...

2026-05-17
从 OSGi 到 Jigsaw:Java 模块化、SPI 与类加载器切换
写在前面 Java 的模块化不是从 JPMS 才开始的。很长一段时间里,classpath 像一条足够宽的路,所有 jar 都往上面放,能跑就行。等应用长大,库的版本开始冲突,内部包被外部代码依赖,插件想热更新,SPI 实现又被错误的类加载器发现,这条路才慢慢暴露出它没有边界的问题。 OSGi、JBoss Modules、Jigsaw(JPMS)都试图在 classpath 之上重新划边界,只是三者选择的边界不一样。OSGi 把运行时动态性放在第一位,JBoss Modules 更关心应用服务器内部的静态隔离,JPMS 则把强封装和可靠配置做进了 Java 平台本身。 类加载器切换是这条线上的另一面。Tomcat reload 之后类没卸掉、OSGi 升级 bundle 之后老对象 ClassCastException、JDBC Driver 把整个 webapp 钉在内存里、Spring Boot DevTools 重启后某个 SPI 实现加载了旧版本,这些现象表面上属于不同框架,根子都在 JVM 的类身份模型:一个类不只由全限定名决定,还由定义它的 ClassLoader 决...

2021-07-19
如何实现正确的微基准测试
原问题 FROM:《How do I write a correct micro-benchmark in Java?》 Tips about writing micro benchmarks from the creators of Java HotSpot: Rule 0: Read a reputable paper on JVMs and micro-benchmarking. A good one is Brian Goetz, 2005. Do not expect too much from micro-benchmarks; they measure only a limited range of JVM performance characteristics. Rule 1: Always include a warmup phase which runs your test kernel all the way through, enough to trigger all initializations and compilations before timi...
2026-09-07
从零构建现代搜索引擎(18):将文档编码成可检索向量
前面十七篇的检索全靠词汇匹配——查询和文档必须共享相同的 term 才能产生分数。搜索"如何提高程序运行速度",如果文档里写的是"性能优化",BM25 给出的分数是零。同义词表能覆盖一部分,但不可能穷举所有语义等价关系。 本篇引入向量检索:用 embedding 模型将文本编码为高维向量,在向量空间中用距离衡量语义相似度。先做精确扫描建立基线,下一篇再用 HNSW 加速。 从词汇匹配到语义匹配 BM25 的语义鸿沟 查询 相关文档包含 BM25 匹配 “如何提高程序运行速度” “性能优化最佳实践” 零分——没有共同 term “machine learning” “机器学习入门” 零分——跨语言 “数据库挂了怎么办” “MySQL 故障恢复指南” 低分——只有"数据库"模糊相关 同义词表(第 16 篇)缓解了一部分问题,但维护成本高,且无法覆盖所有隐含的语义关系。 向量空间的思路 将文本映射为 D 维向量(D 通常是 512 或 1024)。映射由 embedding 模型完成——模型在大量...
2026-01-24
Java 线程池笔记
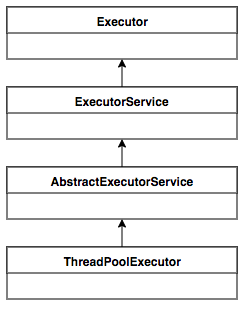
从执行器到线程池(from executor interface to thread pool implementation) Pooling is the grouping together of resources (assets, equipment, personnel, effort, etc.) for the purposes of maximizing advantage or minimizing risk to the users. The term is used in finance, computing and equipment management. ——wikipedia “池化”思想不仅仅能应用在计算机领域,在金融、设备、人员管理、工作管理等领域也有相关的应用。 在计算机领域中的表现为:统一管理IT资源,包括服务器、存储、和网络资源等等。通过共享资源,使用户在低投入中获益。除去线程池,还有其他比较典型的几种使用策略包括: 内存池(Memory Pooling):预先申请内存,提升申请内存速度,减少内存碎片。 连接池(Connection Poo...
2026-09-07
从零构建现代搜索引擎(21):让重排序模型检查候选
上一篇用 RRF 将 BM25 和向量检索的结果合并为一个排名。但 RRF 的融合依据只有排名位置——它不知道候选文档和查询的实际匹配程度。一篇排在 BM25 第 2 名的文档可能因为标题恰好包含查询词而得分高,但正文和查询主题完全无关。 本篇引入重排序模型(reranker),对 RRF 返回的 Top-N 候选逐一做精细评分,找出真正最相关的文档。 二阶段检索 为什么不用 reranker 做全量搜索 Cross-encoder reranker 对每个 (query, document) pair 做联合编码——query 和 document 的每个 token 之间做 full attention。这比 bi-encoder(第 18 篇)精确得多,但也慢得多。 方法 1 万文档耗时 10 万文档耗时 BM25 ~5 ms ~20 ms 向量 HNSW ~5 ms ~10 ms Cross-encoder ~5 s ~50 s Cross-encoder 对每个候选都要过一遍完整的 Transformer 前向传播。对 1 万文档逐个打分需...