Java 平台历代特性
Java 9 模块化,JDK 只依赖于 PATH 不依赖于 CLASSPATH。
https://magicliang.github.io/2020/03/01/Java-%E5%B9%B3%E5%8F%B0%E5%8E%86%E4%BB%A3%E7%89%B9%E6%80%A7/
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles

2026-10-04
深入 Play 18:HTTP 流式响应、背压与资源终止
一个响应最多输出 32 MiB,每次只产生 16 KiB。客户端收到响应头以后暂停读取,服务端生产计数停在 49 块;客户端随后只读一块就关闭真实 socket,服务端流进入终态,关闭计数为一。 这个实验测到了当前链路中的需求反馈与取消传播。49 块已经远大于客户端实际读取的一块,差额可以停留在流、服务器和内核缓冲中。把应用 Source 的 inputBuffer 设成一,不能把整条网络链路理解成“只允许提前产生一个元素”。 生产速率、消费速率与待发送字节 流式响应首先改变的是生产方式。有限列表先把所有对象构造完再交给 Source,虽然输出按元素传输,列表占用的内存已经发生。实验的 Source.range 只产生整数索引,map 在获得下游需求时分配一个 16384 字节数组,上限为 2048 块,不构造完整字节列表。 先忽略对象开销,以字节计算未消费数据。假设生产速率为每秒 8 MiB、消费速率为每秒 1 MiB,持续两秒且生产端没有减速,待发送数据会增加 14 MiB。这是速率差的积分,不是已经测出的 JVM 堆占用。如果可用缓冲只有 512 KiB,差额不能永久累积...
2020-03-08
JMX 深度历险
JMX 常见指标 JVM 指标 系统指标 System 相关指标 描述 system.load.average 系统load,如果是docker,此指标收集的物理机的load cpu.system.load.percent 系统所有进程占用cpu的百分比 cpu.jvm.load.percent jvm占用cpu的百分比 system.process.used.phyical.memory 系统使用的物理内存 system.process.used.swap.size 系统使用的swap内存 JVM 内存指标 JVM相关指标 描述 jvm.gc.count GC的次数 jvm.gc.time GC的时间,单位毫秒 jvm.younggc.count 年轻代GC的次数 ,包括的GC算法(Copy,ParNew,PS Scavenge,G1 Young Generation) jvm.younggc.time 年轻代GC的时间,单位毫秒 jvm.fullgc.count 年老代GC的次数,包括的GC算法 jvm.f...
2026-10-04
JPA 持久化 04:继承、关联与所有权
把明细放进集合,为什么外键仍可能没有变化 采购申请有两条明细,审批后只允许生成一张订单。把 ProcurementLine 加入 ProcurementRequest.lines,Java 内存里的集合已经变了;但如果明细的 request 仍指向旧申请,数据库该依据哪一侧更新外键?再设想“批准”和“驳回”是两种审批记录:查询共同父类能否返回两种子类?把这些问题都叫作“对象关系”会遮住两条不同的线:继承是同一身份体系下的多态映射,关联是不同实体之间关系的所有权。上章讨论过金额嵌入对象无独立身份,这里恰好要判断什么时候需要独立实体。 本篇源码、迁移、脚本与测试可从固定版本完整归档取得;版本 1b08ada,SHA-256 见源码清单。 业务范围不变:DRAFT → SUBMITTED → APPROVED → ORDERED,或 SUBMITTED → REJECTED;只有 APPROVED 能下单,每申请最多一单。每条明细归一张申请,订单记录对应申请,租户不可越权。本文以前三章的实体身份、flush 与回滚、类型和主键为先修;代码入口只针对将来的独立 examples/jpa/...

2026-09-30
深入 OpenTelemetry 20:三信号如何关联又不泄漏字段
同一次请求,哪些字段应跨越三条信号? 一次订单请求带有路由模板 /orders/{id}、方法 GET,也可能接触认证头和 SQL 绑定值。关联日志与指标需要的是 Trace ID 和 Span ID,不必让令牌或原始参数进入属性,更不该把每个订单 ID 当成 histogram 维度。本篇把范围限定为一个受控线程、一个请求 Scope、一个 Logback appender 和进程内三种数据读取;测试既证明安全的记录方式,也构造一个 View 过滤后仍泄漏 exemplar 的反例。 位置 允许字段 控制措施 验证对象 Span route=/orders/{id}、http.request.method=GET 业务侧只赋允许键;SDK 上限设为 2 内存 SpanData Logs 固定消息、logback.mdc.route Logback 桥接只捕获 route;SDK 上限设为 1 内存 LogRecordData Metrics histogram 聚合 route 模板 测量输入只传允许字段,View 再保留 route reader 的点及...
2020-03-11
Java Logging
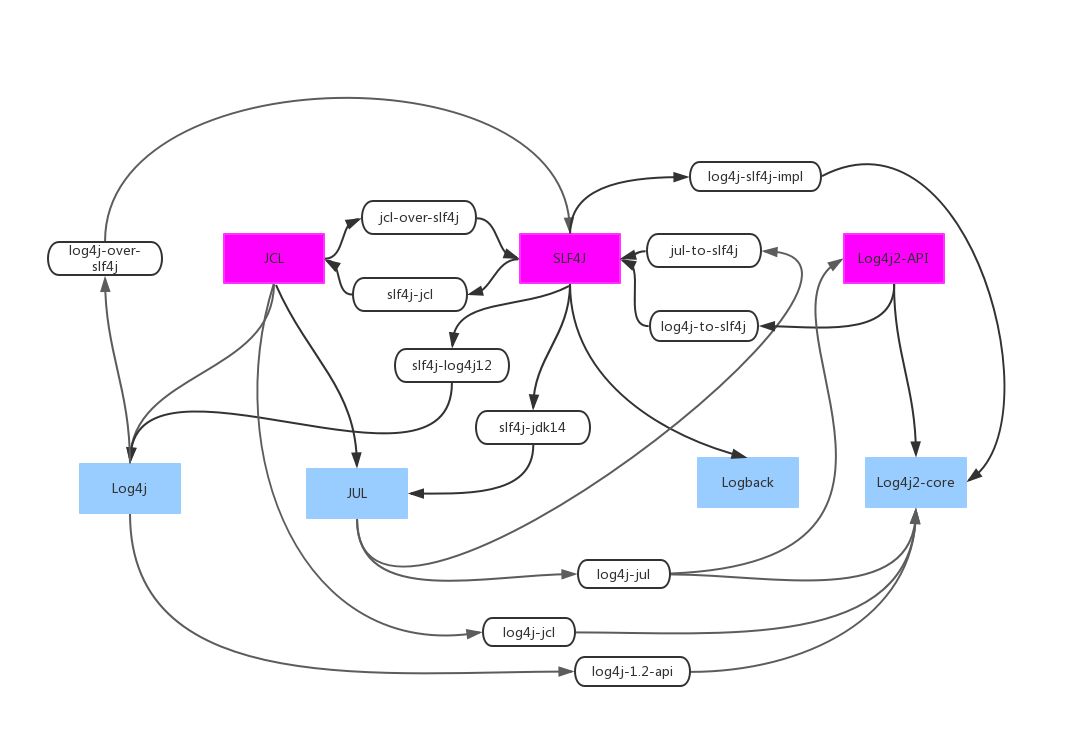
log 历史 阶段 阶段 阶段 阶段 阶段 log4j apache commons logging(JCL) log4j2 JUL simple log logback + slf4j 多个项目使用不同的 logging 库 + 传递依赖等于依赖管理不规范,日志库泛滥以至互斥。 具体框架与门面 所谓的日志框架,指的是日志输出的具体实现,常见的日志框架包括但不仅限于 JUL(Java Util Logging)、Log4j、Log4j2 和 Logback。这些框架的功能不尽相同,比如有些框架支持友好地打印异常,有些不支持,有些框架不支持,不同的框架的日志级别也各有差异。 因此,诞生了日志门面。所谓的门面,就是“使用一个中间层解耦”这一具体思想的应用。使用了门面,可以屏蔽日志使用者对于具体差异的依赖,既让代码变得整洁,而且可以简单地切换实现而不需要修改代码。没有日志门面,不足以统一日志框架的使用。 log facade(定义 interface,早期的 JCL 时代,facade 也被叫做接口)-> log imp...
2020-02-27
hive 汇总
Hive 操作符和函数汇总 Hive 架构概述 Hive 是构建在 Hadoop 之上的数据仓库基础设施,提供类 SQL 的查询语言 HQL,将查询转换为 MapReduce、Tez 或 Spark 任务执行。 核心组件 MetaStore 存储表的元数据信息,包括表结构、分区、列类型、序列化/反序列化规则等 支持多种存储后端:Derby(默认)、MySQL、PostgreSQL 可配置为远程服务模式,支持多客户端并发访问 Driver 接收查询请求,生成执行计划 编译器:解析 HQL,生成语法树,进行语义分析 优化器:基于规则和成本的查询优化 执行引擎:将逻辑计划转换为物理执行计划 执行引擎 MapReduce:早期默认引擎,适合大规模批处理 Tez:基于 DAG 的执行引擎,减少中间结果落盘 Spark:基于内存计算,显著提升查询性能 Hive 数据模型 Database 数据库是命名空间的逻辑容器,对应 HDFS 上的目录路径。 Table Hive 表分为两种类型: 管理表(内部表):删除表时删除元数据和数据 外部表:删除表时仅删除元数据,保留数据 Par...