计算机图形学 E04:射线怎样进入 GPU 工作队列
一批相机射线完成第一次求交后,有些已经得到环境颜色,有些还需反射。继续扫描全部射线很容易实现;把仍需计算的射线集中到队列,则能让下一阶段直接读取存活任务。代价是增加状态存储、原子分配与阶段切换。
这个选择可以在两个镜面组成的小场景里验证。实验保持光路与画质相同,对照全量扫描和队列消费,检查容量不足、陈旧计数与尾线程错误。真实 GPU 结果与 CPU 参考一致;本次计时存在大量量化零,不能据此判断队列具有稳定速度收益。
两次反射给出可手算的参考
第 23 篇区分了理想镜面与连续方向采样。本实验只保留确定性镜面,最多反射两次;没有随机 BSDF、MIS、Russian roulette 或 BVH,也没有使用硬件光追接口。它实现的是波前组织方式中的“保存射线、压缩存活任务、分阶段继续追踪”。
图像为 128×128,实际发射 N=16,381 条像素中心射线,最后三个像素留作黑色占位。射线从 (x,y,2) 沿 (0,0,−1) 发出,x、y 按像素中心均匀分布在 (−1,1)。第一块镜面位于 x+z=0,只保留 −1≤x<0、|y|<1 的区域。
使用未归一化法线也能计算反射,但必须保留分母:
代入 n=(1,0,1),反射方向恰为 (1,0,0)。8,192 条射线命中第一块镜面;其余立即读取环境。第二块镜面位于 x−z=2,范围是 |y|<0.5、0≤z<1。再用法线 (1,0,−1) 反射,方向变成 (0,0,1),共有 4,096 条射线完成第二次反射。
环境函数为 E(d)=0.125+0.875max(0,d.z)。第一次镜面反射率记作逐射线 RGB 向量 ρ,第二次为 (0.5,0.75,0.625)。因此三个终止结果分别是 0.125、0.125ρ、ρ⊙(0.5,0.75,0.625),⊙ 表示逐通道相乘。CPU 除实际求交外,还按像素列和行区间独立检查这三个闭式结果。
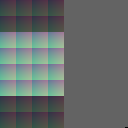
参考使用 double,GPU 使用 f32。本例的坐标、材料与反射运算刻意采用可精确表示的二进制分数,实际零差有明确的输入条件;换成任意几何或更长光路后仍需重新设定容差。
任务身份与队列位置分开
每个任务保存起点、方向、路径吞吐权重 β 和 active 标记。β 是逐次反射率相乘得到的无量纲权重。GPU 用三个 vec4f,共 48 字节,放在 states[rayId];起点的第四分量保存 active。输出的第四分量另作终止状态:−1 表示等待第二阶段,0、1、2 分别表示经历零次、一次、两次反射后结束。
第一阶段写好存活任务,再调用 atomicAdd(count,1)。它返回递增前的值,作为独占槽位 slot。容量为 C 时,仅 slot<C 才写 queue[slot]=rayId;否则增加 overflow。第二阶段只消费 min(count,C) 个槽,取出 rayId 后访问状态并回写 results[rayId]。
slot 表示本次压缩后的位置,rayId 表示光路和像素的稳定身份。跨工作组的原子分配顺序不保证按 rayId 排序,所以核对的是存活 ID 集合、唯一性与逐 ID 颜色。真实运行的四组正常队列都不是升序,但各自包含相同的 8,192 个合法 ID。
全量扫描使用相同状态,第二阶段遍历输入 ID 并检查 active;队列版本按槽读取存活 ID。两种模式每阶段都发出 256 组、每组 64 线程。队列只把有效消费集中到前 8,192 个槽,没有使用 indirect dispatch,也没有减少发出的总线程数。
这种身份分离可用于粒子存活列表或稀疏更新:列表位置允许变化,最终结果仍按稳定 ID 归位。若把 slot 当像素编号,颜色总量可能近似相同,画面位置却会错乱。
两个 pass 才形成消费边界
WGSL 原子操作采用 relaxed 内存语义。atomicAdd 能分配互不重复的槽位,但看到 count 增加,不能单靠这一点推断其他工作组已经发布了全部普通存储写入。workgroupBarrier 和 storageBarrier 的执行同步范围都是工作组,不能充当整个 dispatch 的屏障。WGSL 原子与同步规范
实现将生产与消费放入两个先后编码的独立 compute pass,每个 pass 各调用一次 dispatchWorkgroups。后一个 dispatch 对共享状态和队列的读取依赖 WebGPU 的命令与资源同步规则;没有在同一 dispatch 中跨组轮询计数,也没有构造全设备忙等屏障。WebGPU 资源同步
每轮执行前重置计数器、清零输出,并把队列填成 0xffffffff。读回还检查 64 个额外保护槽。生命周期错误可能保留一张正确的旧图,因而颜色、计数器和保护区需要分别验收。
三种负例各自破坏什么
打开实际 GPU 实验,运行完整对照后,再点击“检查容量、陈旧计数和尾保护”。页面导出原始数组与时间戳,设备不可用时显示原因。
2026-10-01 的真实运行报告 Chrome154、apple、metal-3,timestamp-query 可用;具体设备描述为空。四种排列各读回初始 scan、初始 queue 和计时后 scan,共 12 组完整结果,合计核对 196,572 条射线的 RGB、状态与保护区,最大绝对误差为零。没有逐次读回全部 240 条正式计时提交,也没有单独导出 states 载荷。
| 故意改变的条件 | 真实 GPU 结果 | 拒绝依据 |
|---|---|---|
| 容量 C=17 | count=8192,overflow=8175,processed=17 | 8175 条输出仍为 pending |
| 计数器预置 11 | count=8203,invalid=11 | 前 11 个哨兵槽被误列入消费范围 |
| 允许三个尾线程写入 | tail=3,保护区 12 个分量变成 9 | 有效像素虽正确,保护区已改变 |
容量不足时,原子竞争决定保留下来的具体 17 个 ID。检查按实际集合重建预期输出,不假定最小的 17 个编号获胜。限制消费上界能够避免读取容量之外,却不能恢复丢失任务,因此 overflow 必须使正常验收失败。
陈旧计数负例的有效颜色仍全部正确,说明只看画面会漏掉错误。尾写入发生在预先分配的安全保护区,没有依赖真实越界行为。随后恢复正常队列,全部结果、计数器与保护槽再次通过。
工作量相同,访问顺序仍会变化
分支排列有 grouped 和 interleaved 两种:前者把首反射存活任务集中,后者交错相同的 ID 集合。64 线程工作组内同时包含存活与终止任务的组数,从 0 变成 256。
材料另有顺序布局和置换布局,置换地址为 (rayId×4099) mod 16381。材料值保持不变,只改变物理位置。任务重排也会改变状态和输出的访问次序,置换还引入地址算术;原子队列顺序继续影响第二阶段局部性。因此四个组合测量的是任务排列与访存成本的共同影响,不能把差值单独归因于纯分支发散或内存带宽。
计时零值保留在统计里
每个组合每种模式预热 4 次,共 32 条预热记录。正式测量每组合 30 对,偶数对 scan→queue,奇数对 queue→scan,形成 AB/BA 交替,共 240 条正式样本。四条件分别统计,没有混合或删除慢样本。
CPU 编码提交从创建 encoder 前计到 submit 返回,包含重置命令的编码。CPU 完成等待计到 onSubmittedWorkDone 通知,二者相加得到编码至完成时间;后续映射和完整回读尚在其外。GPU 时间由两个 pass 的四个原始时间戳相减得到,包含共同诊断原子操作,排除重置复制、材料上传、结果回读与呈现。两阶段之和也不等于整帧时间。
下表为 GPU 两阶段之和,单位 ms;每格按 p10/p50/p90 排列,每模式 n=30:
| 任务/材料排列 | scan | queue | scan/queue 零样本数 |
|---|---|---|---|
| grouped/sequential | 0/0/0.065536 | 0/0/0.072090 | 21/20 |
| grouped/permuted | 0/0/0.072090 | 0/0/0.065536 | 26/25 |
| interleaved/sequential | 0/0/0.065536 | 0/0/0.065536 | 25/22 |
| interleaved/permuted | 0/0/0.137626 | 0/0/0.091750 | 25/21 |

分位数按排序位置 (n−1)p 线性插值,所以 0.072090 可能来自相邻量化值之间,不能据此推断时钟具有同等精度。480 个正式阶段差值中,非零值的最大公约数为 65,536 ns,即 0.065536 ms;这是本批观察到的量化结构。
四条件的 CPU 编码提交中位数也全为零,完成等待中位数均约 0.3 ms。等待包含主机通知等影响,不能代替 GPU 内核时间。量化时间零、图像误差零和终止状态零表达三件不同的事。
逐对 queue/scan 只有分母非零时可定义。四条件各 30 对中,分别只有 9、4、5、5 对满足条件;剩余分别含 14、23、19、18 个 0/0,以及 7、3、6、7 个正数/0。只对有限子集求中位数会改变样本集合,不能称为全部配对的加速比。本批结果不足以支持稳定加速结论。
复跑与练习
仓库根目录执行,先生成参考,再运行浏览器:
1 | |
打开 http://127.0.0.1:8772/gpuE04.html,运行两个按钮并下载记录。Node 检查只覆盖纯逻辑,不能替代真实 GPU。仓库的 summarizeE04.py 从保存的正常与负例 JSON 重新核对哈希、缓冲和所有配对统计。CPU参考、CPU原始计时与GPU完整统计随文保留;完整GPU回读、负例和审阅位于仓库 writing-plans/computer-graphics/evidence/E04-gpu-*。
练习一:本场景容量改为 8,000,其他条件正常,count、overflow 和可消费数量分别是多少?
答案:8192、192、8000。count 记录申请数,不能截成容量后假称全部成功;192 条存活射线无法完成第二阶段。
练习二:生产者在普通状态写入后递增原子计数,消费者在同一 dispatch 的另一工作组轮询计数,能否替代两个 pass?
答案:不能。relaxed 原子计数没有提供所需的跨组载荷发布保证,工作组屏障也不覆盖其他组。本实现保留独立 dispatch 的资源同步边界。
练习三:同一对 scan=0、queue=0 ms,应记录比值 1 吗?scan=0、queue=0.065536 ms 呢?
答案:第一种是未定义的 0/0,不能解释成耗时相等;第二种也不能给出有限比值。保留原值、类别及差值,不能补一个小分母制造精确加速倍数。
模式速查与出处
| 检查对象 | 可迁移规则 | 对应证据 |
|---|---|---|
| 压缩任务 | 稳定 ID 与临时 slot 分离 | 集合、唯一性、逐 ID 输出 |
| 跨阶段状态 | 明确生产完成与消费边界 | 独立 pass、计数和保护区 |
| 容量截断 | 有界写入同时报告丢失 | overflow 与 pending |
| 量化计时 | 保留零值及配对关系 | 原始时间戳、分母分类 |
- WGSL 原子函数与同步函数:原子返回值、内存语义及工作组同步范围。
- WebGPU dispatchWorkgroups与缓冲映射:调度单位与读回规则。
- WebGPU 官方 timestamp query 示例:可选时间戳能力与计算 pass 查询。