计算机图形学 35:用三个场景检验 SAH 分割
把一组图元按数量切成两半,会得到高度较均衡的树;这是否就是一棵适合射线的树?左右两个盒子可能包含几乎相同的空间,一条射线仍要进入两边。树的高度没有直接说明一条射线要测试多少图元。
本篇把“更好的分割能减少遍历工作”写成可反驳的小项目:固定第 34 篇验收过的显式栈遍历,比较数量中位数分割和 12 桶 SAH。均匀、不均两簇、重叠三组场景都检查最近命中、图像、工作量、构建成本和遍历时间,不预设每一组都会加速。
研究问题怎样落到代码上
第 18 篇已有数量中位数建树:求当前组的完整包围盒,选择跨度最大的轴,按图元包围盒质心沿该轴排序,用 nth_element 分成数量相近的两组。两个及以下图元成为叶子。
它控制了树高,却没有直接优化孩子包围盒面积。假设 56 个图元集中在左边,另 8 个在远处右边。数量二分的第一刀可能把左簇分到两侧,右孩子于是同时包含近簇与远簇。两侧各有 32 个图元,不意味着两侧容易被射线排除。
SAH 选择不同的目标:估计进入孩子以后还需付出的求交工作,比较分裂与保持叶子哪个更便宜。它是一个成本模型,不是所有相机射线的精确耗时方程。本文复现这个模型的有限桶版本,沿用已有相机、几何与查询代码。
两种构建策略都使用完整图元包围盒的最长轴。这是为了保持当前累计实现的轴规则。PBRT 的具体实现还用质心包围盒选择轴、不同固定遍历成本及最大叶大小策略;本篇不会把这些差异隐去后声称与教材逐行相同。
面积比怎样进入成本
设父盒面积为 A_P,两个孩子面积为 A_L、A_R,孩子图元数为 N_L、N_R。若每次内部节点处理的归一成本为 K_T,每次图元求交成本为 K_I,候选分割的局部估计是:
不再分割、直接成为叶子的估计是:
面积比近似孩子被射线访问的机会,假设射线分布足够宽泛。两侧盒子可以重叠,一条射线可以访问两边,因此两个面积比的和不必为 1。它不是把“只选左或只选右”的概率相加。
轴对齐盒子的边长为 d_x、d_y、d_z,表面积是 2(d_xd_y+d_yd_z+d_zd_x)。三角形的包围盒可能在一个轴上为零厚度,表面积仍可非零;线或点状盒子的面积才可能为零。直接把“任意平盒”判断为零面积会误处理正常的地面三角形。
用于面积的盒子必须包含实际图元。质心仅用于决定图元落在哪个桶,不能用孩子的质心范围代替完整几何范围。细长三角形的质心可能很近,但本身横跨较远区域;用质心盒计算成本会低估射线进入它们的机会。
本实验固定 K_T=K_I=1。若父面积为 100,两个孩子面积都是 30,图元数各为 4,那么 Csplit=1+0.3×4+0.3×4=3.4,而叶子成本为 8,模型支持分割。若两个孩子面积都为 100,成本变成 9,比保持叶子更高。
这两个例子解释的是模型的判断,不是测得的毫秒。处理一个 AABB 与一个三角形所需的真实时间可能不同,CPU 缓存与分支也没有出现在式子里。K_T 的选择要在实验开始前固定,不能观察结果后调整到有利于某个方案。
十二个桶怎样产生候选
在选定轴上求质心最小、最大值 c_min、c_max。对一个质心 c,桶编号为:
最大质心可能算出 12,需要归入最后一桶。c_max=c_min 时不计算这个除法,而是终止为叶子。空桶不提供几何,但可能位于两组图元之间;不能为它编造一个零点包围盒参与合并。
每桶保留图元数量和完整图元包围盒的并集。11 个桶间边界分别作为候选,累积左、右数量与包围盒,跳过任一侧为空的边界。比较局部成本,选最小者;只在它严格小于叶子成本时分裂。
程序按桶边界重排当前图元区间,使每个图元只进入一侧。即使一个三角形跨过分割位置,它也不会被复制到两边。这里构建的是按图元集合划分的 BVH,不是把空间切开以后在多个格子重复保存跨界图元。
数量中位数控制两侧数量,桶 SAH 允许数量不均衡。因此 SAH 树可能更深,也可能保留大叶子。对两种树都使用已有 hit_stack、相同 AABB 和三角形求交、相同左先顺序以及相同最近距离更新。
终止条件决定失败边界
小叶阈值仍为两个图元,除此之外,SAH 可以因零父面积、当前轴质心重合、没有有效候选或候选成本不优于叶子而停止。此时大叶子并不是程序缺少递归,而是当前规则选择的结果。
深度上限固定为 64。达到上限后保留叶子,使构建递归和查询栈具有明确的范围。上限不是“已经优化好”的证明;统计需要报告有多少节点因此停止,以及最大叶子大小。当前数量中位数在原有一百万图元限制内不会达到这个深度。
sah35_check.cpp 已实际执行空树、两个图元、所选轴质心重合、零面积、成本不划算、深度上限、含空桶的稀疏分布和有面积的平面输入。四个重复三角形还检查等距命中保留较小图元编号。一个可手算的稀疏球组得到成本 1+96/184,与程序一致。
NaN、负半径、非法模式、深度 0 或 65,以及有限图元合并后面积溢出等七个输入被拒绝。检查合并面积发生在“小叶直接返回”之前,否则两个各自面积有限的图元也可能留下无法解释的统计。数量中位数的旧建树与所有求交函数体保持不变;旧 BVH、场景、第 33 篇项目和第 34 篇比较程序都重新严格编译并运行通过。
选择的轴也构成边界。完整盒子的最长轴可能恰好没有质心差异,而另一个轴能够区分图元。本篇约定不另试第二个轴,以保持有界实现可解释;这种输入会成为叶子,不能宣称已经搜索了所有可行分割。
三组输入保持同一观察协议
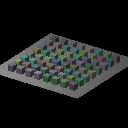
每组含 64 个盒子和两片地面三角形,共 770 个三角形。均匀组在 XZ 平面布置 8×8 个边长 0.6 的盒子,中心坐标沿两轴从 −3.5 到 3.5。两簇组把 56 个盒子排列在左侧 7×8 网格,8 个排列在右侧 4×2 网格,尺寸为 (0.2,0.24,0.2),网格间距 0.3。重叠组让 64 个尺寸为 (1.2,1.2,1.2) 的盒子完全重合于 (0,0.6,0)。
地面半宽为 5。相机位于 (9,8,13),朝向 (0,0.2,0),正交半高 6,近远面 1 与 40。点光源位于 (−4,10,6),强度 180,人工填充系数 0.06。第 33 篇的时刻固定为 tick=120,动画振幅设为零。生成的三个 .scene 文件保留所有配置,几何 CSV 保留变换后的顶点、法线和线性反射率。
三组都使用 128×128 像素中心主射线,右手世界坐标、Y 向上、相同正交相机、线性 Lambert 点光源与人工填充项。一次测试中两种树读取完全相同的几何。没有随机数、随机种子、多跳路径或自适应采样。
每组保存完整几何和树节点 CSV。节点记录包含包围盒、左右孩子、叶区间或图元数量,既可以复算面积成本,也可以查看大叶子为何形成。图像由实际求交结果生成,图元编号与命中距离另行检查,材质颜色相同不能掩盖错面。
49,152 条射线逐条对照暴力求交。三组的命中数均为 4,935;背景地面覆盖相同,盒子命中与材质分布不同。两种树的命中状态、图元编号、距离、位置、法线和重心坐标与暴力结果完全相同,线性 RGB 的最大误差与 MSE 都为零。每组的两个实际 PPM 图像相同,误差图全黑。这个结论来自浮点结果和编号检查,不依赖 PNG 看起来相同。


预测成本和真实工作量分开看
整树的估计可以递归写成叶子 N K_I、内部 K_T+(A_L/A_P)C_L+(A_R/A_P)C_R。把面积比逐层相乘后,以根面积归一化,等价于:
根面积为零时报告没有可用的归一化成本,不把 0/0 填成零分。这个数适合检查建树模型是否按约定执行;它仍不等于当前相机射线的实际求交次数。
下表中的计数是一遍 16,384 条射线的总量;“中位数→SAH”表示改变建树策略,查询算法相同。
| 场景 | 节点数 | 深度 | 最大叶图元数 | 预测整树成本 | 节点/AABB 测试 | 图元测试 |
|---|---|---|---|---|---|---|
| 均匀 | 1023→401 | 10→10 | 2→8 | 31.302856→14.942142 | 305524→109594 | 42734→45738 |
| 两簇 | 1023→385 | 10→10 | 2→8 | 19.456355→5.224256 | 185648→44420 | 18877→14412 |
| 重叠 | 1023→5 | 10→3 | 2→514 | 39.446454→518.972903 | 359344→41992 | 110100→3310980 |
均匀组的图元测试略增,但节点测试显著下降;不能只拿图元次数判断快慢。两簇组两项工作量都下降。重叠组虽仅剩五个节点,却形成巨大叶子,图元测试增加到约三十倍。
重叠组的 514 图元叶包含地面的两个三角形,以及每个盒子另外四个面的八个三角形,共 2+64×8。它们沿 X 的包围盒中点全为零。合并盒的最长轴再次选 X,当前规则立即因该轴质心重合而终止。这里不是所有三维质心完全重合;换轴或强制数量二分可能继续拆分。实验没有在看到结果后补上这些策略,所以这个失败应归属于本篇声明的有界实现,不能扩展成“所有 SAH 都会如此”。
三组都没有触发深度上限、零面积或不划算成本终止。均匀与两簇各有 64 个叶子因所选轴质心重合停止,重叠有三个;其余 SAH 叶子来自小叶阈值。这些停止计数与节点表中的叶数一致。
计数器另跑一遍,记录节点、AABB 与图元测试。两种分割改变了树,本篇允许这些计数不同;要求它们全部相同反而会把建树实验的主要效应排除掉。结果相同与工作量相同是两个不同条件。
构建和遍历分别计时
构建时间包括初始化节点、索引数组和建树,输入几何的准备与复制、最终树的析构在计时外。遍历时间使用已经构建的树,预生成射线与按实际深度分配的栈;着色、图像写出、诊断计数、CSV 写出都不进入遍历计时。
每个构建样本只构建一次;每个遍历样本连续查四遍,即 65,536 次查询。每遍保留相同编译器屏障,命中结果进入相同 checksum,写入可观察的结果,防止无效工作被编译器删除。汇编检查确认四段逐射线循环保留,调用不带诊断计数的显式栈遍历;构造调用位于两个时钟读数之间,输入复制与析构在外。
实际环境为 Apple clang 21.0.0、arm64 Darwin,编译选项 -std=c++17 -O2 -Wall -Wextra -Wpedantic -Werror,单线程。每个场景的遍历阶段都使用相同四遍查询协议,正式运行前固定参数。下表的遍历毫秒是一整个四遍样本,比较对象都包含相同的 checksum 算术,不能理解为裸求交指令成本。
使用与第 34 篇相同的 steady_clock CPU 墙钟口径和 (n−1)p 线性插值分位定义。每个阶段都有四对预热和三十对 AB/BA 正式测量,所有原始样本保留。不把建树加上传时间命名成 GPU 执行时间,也不把一个查询批次叫作浏览器帧间隔。
| 场景/阶段 | 中位数分割 p10/中位数/p90,ms | SAH p10/中位数/p90,ms | 成对 SAH/中位数 p10/中位数/p90 |
|---|---|---|---|
| 均匀/建树 | 0.212395/0.224646/0.272013 | 0.289416/0.301042/0.320187 | 1.116015/1.334994/1.397276 |
| 两簇/建树 | 0.211076/0.217437/0.289292 | 0.293971/0.298042/0.321617 | 1.143760/1.377172/1.400017 |
| 重叠/建树 | 0.176621/0.177938/0.198742 | 0.071496/0.072542/0.077554 | 0.383324/0.403699/0.409729 |
| 均匀/遍历 | 18.734283/19.459042/21.422066 | 7.720238/8.256938/8.694854 | 0.390951/0.422856/0.453958 |
| 两簇/遍历 | 10.068570/10.942209/12.921600 | 2.720054/3.001792/3.339392 | 0.228055/0.268674/0.300333 |
| 重叠/遍历 | 22.971675/24.629271/25.946721 | 56.537570/57.069021/58.608000 | 2.217138/2.311240/2.500306 |
成对比值先对同一对样本相除,再求分位;不等于两个耗时中位数直接相除。均匀、两簇、重叠的 AB/BA 遍历比值中位数分别为 0.426781/0.419727、0.270053/0.267295、2.322567/2.304327,交换执行顺序后,三组方向一致。原始记录含 360 行正式耗时,构建与遍历分开各占一半,预热不混入统计。

图中横轴是样本对编号,每个面板独立选择毫秒纵轴范围,不能通过不同面板的点距比较绝对时间。均匀与两簇的遍历在这组样本中分别降至约 42% 与 27%;重叠组增至约 231%。SAH 的额外建树工作在前两组有用,在重叠组则更快地产生一棵查询更差的树。
如果模型降低、图元测试降低,但遍历耗时没有按同样比例降低,优先检查模型没有覆盖的成本:AABB 数量、分支、数据访问和共同 checksum。不能为了让曲线吻合就删除慢样本或改用不同样本量。
构建成本怎样摊销
设两种建树耗时为 B_m、B_s,平均每条射线查询成本为 t_m、t_s。在输入保持静止、所有射线服从当前测量协议的假设下,总时间比较为:
若 t_m>t_s,则有门槛 R>(B_s−B_m)/(t_m−t_s)。分子若为负,意味着当前测量中 SAH 连建树也较便宜;分母若非正,则不存在这个形式的正向“多发射线后摊销额外成本”的收益论证。
均匀组的额外构建中位成本为 0.0763955 ms,四遍查询节省 11.2021035 ms,除以 65,536 得每条约 0.1709305 μs。代入后门槛约 447 条射线。两簇的额外构建成本为 0.0806045 ms,每条节省约 0.1211611 μs,门槛约 665 条。它们远低于当前一遍主射线数量,但估算沿用批量测量中的热缓存条件。
重叠组建树节省 0.1053955 ms,四遍查询却增加 32.43975 ms。对于少到仅一次查询的任务,建树节省可能暂时占优;按当前平均查询差额约 0.495 μs 估算,射线数超过约 213 条就失去该优势。它不存在“多查以后收回额外建树成本”的门槛,而是查询越多,巨大叶子的代价越大。
这个门槛使用样本中位数做条件估算,不是带置信度的生产保证。每帧重建、相机变化、阴影射线或缓存状态改变都会改变条件;把一帧主射线的结果扩展为整段动画需要新的测量。
练习与自检
练习一。 父面积为 100,左右孩子面积为 80、20,图元数量为 2、6,K_T=K_I=1。分裂成本是多少?模型是否支持分裂?
答案:1+0.8×2+0.2×6=3.8,小于叶子成本 8,所以局部模型支持分裂。两侧数量不均衡不会使它自动无效;决定条件是加权成本。
练习二。 四个球具有相同包围盒质心,但半径不同。按本篇桶规则是否还能分裂?为什么不能用球的数量足够多来证明一定能分裂?
解题要点:c_max=c_min,无法按该轴将质心映射到不同桶,程序保持叶子。不同半径改变完整包围盒面积,却没有为质心桶提供区分位置。换其他分割策略可能有效,但已超出本篇约定。
练习三。 SAH 比中位数多用 2 ms 建树,每条射线少用 0.1 μs,门槛是多少?如果每条射线反而多用 0.1 μs 呢?
答案:统一为微秒,2000/0.1=20,000 条;严格不等式要求超过这个数量。若遍历更慢,则分母为负,两项成本都较大,不会随正的射线数量增加而变成收益。
复跑报告与出处
累计工程入口是仓库内 examples/computer-graphics/。在该目录执行以下命令;先建树与查询,再从原始记录独立复算统计和图表:
1 | |
复跑会生成新的本机耗时,不应期待和文章的小数逐位相同。本文首次正式原始记录已保存在同名素材目录:耗时 CSV、完整报告。同目录保留三个场景、世界几何、六棵节点表、逐像素结果、两种算法结果图及误差图。writing-plans/computer-graphics/evidence/35-cpu.txt 记录真实运行、回归和文件 SHA;事实核验记录为同目录 research-35.md。
summarize35.py 复用第 34 篇的分位函数,从 360 行原始样本检查全部 90 个分位,从六棵节点表重新计算模型,并检查 49,152 个像素的线性颜色、checksum 和计数。源码验收、图像验收与统计复算各自保留,构建通过不能替代它们。
- PBRT 4 §7.3.2:The Surface Area Heuristic,叶成本、面积权重与十二桶近似。本篇 K_T=1、完整 bounds 最长轴和终止策略是已声明的实验选择。
- Wald 2007,On fast Construction of SAH-based Bounding Volume Hierarchies,§2.2 和 §3 的成本模型与快速构建问题。本篇只研究有限桶的局部分割,不复刻论文全部构建与多线程工程。
系列入口 · 上一篇:画质与时间的有界比较 · 下一篇:曲面与隐式几何(E01,待完成)。