计算机图形学 34:一次优化怎样同时检查画质和时间
把递归遍历改成显式栈,画面仍是两个盒子,是否就能接受这次优化?黑色背景占据大半张图,一次漏掉小物体未必容易发现;单次运行快几毫秒,也可能来自测量顺序。优化需要同时回答两个问题:程序是否仍计算同一个结果,这个结果用了多少时间。
本篇复用第 33 篇的场景,选择 BVH 最近命中查询作为待研究的热点。基线和对照使用同一棵树,只改变保存待访问节点的方式。这个小实验测量一个 CPU 查询内核,不能据此宣称整个渲染器的主要瓶颈已经确定。
有界问题先固定输入
场景冻结在 tick=120,即固定步模拟完成一秒的位置。仍是地面、移动盒与静止盒,共 26 个三角形;相机和点光源保持上一章的配置。图像为 128×128,每个像素只有一个中心样本。
射线由上一章的权威 float32 VP 矩阵反投影近、远端得到。世界坐标为右手系,Y 向上;图像原点在左上角。射线命中范围、几何法线、反射率、点光源与人工填充项都没有另外设一组参数。
本篇的问题是:在相同 BVH 上,递归调用与显式待访问栈能否得到相同最近命中,CPU 耗时分布有什么差别?它不比较光栅与光追,不改变每像素样本数,也不讨论一个 API 调用能够发出多少 GPU 绘制任务。
16,384 条射线在计时之前生成。建树、计算实际树深度、分配显式栈、写 CSV 和编码图像都在计时外完成。两种遍历读取同一节点数组、同一图元数组和同一射线数组,减少把无关开销误算成遍历收益的机会。
这个范围也有代价:所有数据可以反复进入缓存,26 个三角形无法代表大型动态场景。实验结论只适用于指定代码、编译器、输入和测量协议;迁移到更大场景需要重新测量。
两种程序保存同一份待办
最近命中查询维护当前最近距离 tMax。若射线没有穿过节点包围盒,就跳过整棵子树;若进入叶子,就测试叶区间中的图元。更近的有效命中缩短 tMax,后续包围盒和图元都使用这个更新后的范围。
命中一个三角形还不能结束查询。其他待访问节点可能包含更近的面。这里处理的是 closest-hit;找到任意遮挡就可以返回的 any-hit 查询具有不同的终止条件,不能混入同一计时比较。
递归版本在内部节点依次调用左、右孩子。右孩子开始时读取左孩子更新后的最近距离。函数调用栈保存当前调用需要恢复的位置与状态。
显式版本从根节点开始,每次弹出一个节点,内部节点先压右孩子、再压左孩子。由于栈后进先出,实际处理顺序仍是左、右。最近距离放在查询状态中,弹出右子树后使用已经缩短的范围。
1 | |
左右访问顺序看似不影响最终最近距离,却影响剪枝发生的时机。若同时增加“先访问较近孩子”的规则,就已经改变了第二个因素。节点布局、叶子大小、分割算法和 AABB 求交也一样,需要在当前比较中保持固定。
两个入口共用叶子求交与更新函数。距离相同的候选按原有图元编号规则决定结果;这个规则对三角形共享边等情况有用。只比较颜色会漏掉“两个不同面恰好具有同一材质”的错误,因此图元编号也进入验收。
累计代码保留旧的 hit(ray, counts) 接口,既有章节继续使用它。新计时只比较 hit_recursive 与 hit_stack;旧入口为每次查询创建动态 vector 的分配开销没有混入两者差值。
栈容量也是算法条件
显式栈把内存需求写成了一个可检查的条件。本篇先计算当前树的最大深度,再在计时外准备容量;每次压栈仍检查边界,容量不足要报错,不能写出数组。
对于深度为 D、一次压入左右两个孩子、沿左侧继续的二叉树,栈中最多保存当前路径对应的待处理右分支和接下来处理的节点。以根深度为 1 的约定,D 个槽足以覆盖这种访问方式。容量依据的是当前树,不是任意写下一个常数。
PBRT 第四版 §7.3.5 也使用显式待访问栈,其代码同时包含紧凑节点布局、方向倒数和近远访问策略。这里引用它来说明遍历结构,不把这些因素一起移植,也不把它的实用容量常数解释成任意树的数学保证。
递归版本同样占用空间,只是交给语言运行时的调用栈。改成显式栈不等于消除了空间复杂度;两者沿树深度保存状态。当前中位数分割有界树的深度较小,实验没有声称支持恶意构造的任意深递归树。
正确性先看命中,再看图像
对每条固定射线,程序把两个新入口与旧入口、遍历全部图元的参考比较。检查项目包括有无命中、图元编号、t 和世界命中点。三角形求交函数没有改动,因此在相同访问顺序下还可以检验浮点结果是否相同。
颜色在命中之后用上一章的公式生成:
本篇不启用阴影,A 仍是人工填充。背景为零,前景使用命中面的法线与线性反射率。所有误差在高光压缩和 sRGB 编码之前计算。两张显示图相同只是辅助观察,逐通道线性差才是对应的数值依据。
实际检查了 16,384 条射线,其中 5692 条命中。两种新入口与旧入口、暴力参考的命中标识、距离、点、法线和重心坐标完全一致。全图三个线性通道的最大差和 MSE 都为零,没有通过边界排除缩小比较范围。
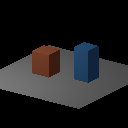


黑色差图需要与数值一起看。如果差值极小而显示编码后归零,黑图也会出现;这里的实际最大差与 MSE 才区分“精确相同”和“只是无法在截图上看见”。全图比较不沿用上一章的光栅边界掩码,因为本篇两个版本使用同一套射线求交。
计数器另跑一遍,记录节点访问、AABB 测试与图元测试。若两种遍历真的只改变控制流保存方式,它们应处理相同的节点与叶区间。出现计数差异时,要先查访问顺序或 tMax 更新,不能直接把时间减少归为更好的栈实现。
树有 31 个节点,最大深度为 5;显式栈准备 5 个整数槽。一批射线的节点访问和 AABB 测试都是 154,930 次,图元测试是 32,397 次,三个 BVH 入口的计数相同。暴力参考执行 425,984 次图元测试,即 16,384×26。这说明当前 BVH 确实减少了图元求交工作量,但不能从测试次数直接推导墙钟加速倍数。
程序另查空树、单叶、跨叶相同 t 的编号取舍、右子树中的更近命中与计数器累加。零槽和不足容量的栈分别触发异常,避免主场景深度较浅时掩盖容量错误。
计时包括什么
计时器使用 C++ steady_clock 的经过时间。每个测量臂遍历同一批射线八次,消费每次返回的命中并累加校验值。这样测到的是 CPU 遍历加共同结果消费的墙钟耗时,不能叫 GPU 执行时间或帧间隔。
预热使用四个成对实验。正式测量 30 对,奇偶对交替采用递归→栈和栈→递归的顺序,即 AB/BA。每对的两个臂相邻运行,使长期环境变化较少混入单一方法;这并不消除系统调度、频率与缓存等所有影响。
正式计时不更新诊断计数器。否则每个节点的整数加法会进入内核,计数器实现本身可能改变优化结果。诊断入口使用同一算法的计数版本,计时入口使用不计数的版本。
原始 CSV 保留 pair、实际顺序、方法、毫秒和校验值。统计不删除慢样本。对 n 个排序样本、分位 p,位置取 q=(n−1)p,在相邻样本间线性插值。p10、median、p90 都使用这个定义,不把 p90 写成最大值。
本机用 Apple LLVM 21.0.0,目标为 arm64,编译选项为 C++17、-O2 -Wall -Wextra -Wpedantic。实际 CPU 型号查询被系统拒绝,回执只保留可确认的编译器和架构,没有由 GPU 厂商字段推断 CPU 型号。
| 方法 / 指标 | 样本数 | p10 | median | p90 |
|---|---|---|---|---|
| 递归,ms | 30 | 17.65562 | 19.27225 | 20.33450 |
| 显式栈,ms | 30 | 17.55558 | 18.78265 | 19.79484 |
| 成对栈 / 递归 | 30 | 0.908719 | 0.983135 | 1.062422 |
每个毫秒样本包括八遍射线,总计 131,072 次查询。不能将表中的约 19 ms 当成一帧渲染时间,也不能与上一章动画的显示帧间隔对比。steady_clock 在此编译环境报告纳秒周期,但计数单位为纳秒不代表每次读时钟都具有一纳秒的实际精度。

还需要看成对比值。令每对的栈时间为 T_s,递归时间为 T_r,记录 R=T_s/T_r。R 小于 1 表示这对中栈较快;R 大于 1 表示递归较快。两个独立中位数的比不一定等于成对比值的中位数,所以它们不能混用。
按顺序分组,AB 的成对比值中位数为 1.00594,BA 为 0.973017。整体成对中位数约 0.983,p10 到 p90 跨过 1;这次运行支持“结果相同、时间略有差异”,不支持“显式栈具有稳定收益”。不能选出最快的一对作为最终性能结论。
为避免编译器把八遍查询合并成一遍,每遍之前放置相同的 atomic_signal_fence,并消费每个命中。这个编译器屏障没有把遍历变成多线程程序,也不是等待 GPU 的同步操作。最终 -O2 汇编中,两个测量臂都保留了八次循环及逐射线遍历调用;每臂校验值为 407082.95290006464,与计时外暴力结果按同一累加顺序得到的值相同。
这些样本共享同一台机器、输入和一次进程,不等于跨设备的独立试验。分位区间描述本次运行的分布,没有自动给出统计置信区间。原始样本比一个“快了百分之几”的口号更有助于复查。
误差预算不一定要变大
有些优化通过少采样、降低纹理级别或近似照明节省时间,需要给出可接受的误差界。本篇的控制流替换要求保持同一最近命中,因此质量预算为零:只要图元或线性颜色改变,就先按实现错误处理。
这个要求并不说明所有浮点优化都能逐位等价。若以后更改运算次序、SIMD 精度或快速数学选项,需要重新定义合理容差,并给出反例检查。不能把本篇的零误差结论自动扩展到另一种算法。
单个内核的速度变化也不直接等于整帧速度变化。设原帧时间中该内核占比为 f,它加速 s 倍,其他部分保持不变,则理想的整帧加速上限为:
若 f=0.2、s=2,得到 S=1/0.9≈1.111。这是给定条件下的算术例子,本实验没有测量完整帧的 f。图像编码、光栅、着色、上传和浏览器显示都在当前计时范围之外,不能从遍历 CSV 推断它们的占比。
选择下一项优化时,要先知道实际工作量在哪里。如果更多节点来自分割质量,换一种保存调用状态的方法未必解决问题。第 35 篇将在固定遍历的条件下研究分割策略,继续把每次修改限制为一个可解释的因素。
练习与自检
练习一。 显式栈把左孩子先压、右孩子后压,最近命中图像仍然正确,为什么不能把这个版本直接纳入本篇计时?
解题要点:后进先出会先处理右子树,改变缩短 tMax 的时机。最终最近距离可能保持相同,节点/AABB/图元计数却可能改变。这个比较同时包含保存状态方式与访问顺序两个因素,应恢复右先压、左后压,或另开一个独立对照。
练习二。 三对时间分别为递归 10、20、40 ms,栈 12、18、32 ms。求独立中位数之比及成对比值中位数。
答案:独立中位数为 20、18,比为 0.9;成对比值为 1.2、0.9、0.8,中位数为 0.9。这组数据两者恰好相同。把栈时间改成 12、32、18 ms 后,独立中位数之比仍为 0.9,成对比值为 1.2、1.6、0.45,中位数变成 1.2;独立汇总丢掉了配对关系。
练习三。 一个内核原先占整帧 10%,把它加速到任意快,整帧最快能加速多少?
答案:令 s 趋于无穷,S 趋于 1/(1−0.1)=1.111…,约快 11.1%。若实测整帧快了两倍,至少有一个假设不成立,需要检查 f、其他开销或比较条件。
复跑与出处
1 | |
再运行 python3 examples/computer-graphics/summarize34.py examples/computer-graphics/build,从原始 CSV 独立重算五组分布、像素差和计数,并生成时间图。这个检查不能复现过去的墙钟数字,但可以检出汇总与原始样本不一致。
附件包含 60 行原始计时、逐像素线性数据与计数、汇总及编译器字段和三张实际结果 PNG。累计代码为 bvh.hpp、benchmark34_check.cpp、summarize34.py;验证回执保存在 writing-plans/computer-graphics/evidence/34-cpu.txt。本实验单线程、无随机采样,没有种子、随机终止策略或 GPU 耗时数据。
- PBRT 4 §7.3.4:Compact BVH for Traversal,节点数组、叶区间与紧凑布局。
- PBRT 4 §7.3.5:Bounding and Intersection Tests,待访问栈、最近命中距离更新与子树处理;本篇没有一并引入其中的全部优化。