计算机体系结构 32:Roofline 与矩阵数据复用
计算机体系结构 32:Roofline 与矩阵数据复用
核心问题
分块矩阵乘法减少了某一层级的数据搬运,性能就一定提高吗?Roofline 先用运算强度把计算峰值和带宽上界放在同一坐标系中,但模型上界不是实测性能点;字节流量还必须注明针对 DRAM、缓存还是片上 scratchpad。
附件:矩阵流量与上界、Roofline 图、计算与绘图源码。
范围与证据等级
证据等级为解析模型。固定 N=256 的方阵乘法 C=A×B,三个矩阵为行优先 float32,假设每次内层乘加算 2 FLOP,总计 2N³=33,554,432 FLOP。分块边长为 32,先把 A/B 分块搬进片上存储,C 分块在片上累加后写回;字节分母限定为理想 DRAM 流量。题设计算峰值 128 GFLOP/s、DRAM 带宽 32 GB/s 都未实测。
Williams、Waterman 与 Patterson 的 Roofline 模型用下式表达可达到性能的上界:
1 | |
公式中的 peak 和 bandwidth 必须来自同一机器与相符的测量口径;operational intensity 的字节分母也要固定内存层级。
核心案例:同一计算量,不同数据复用
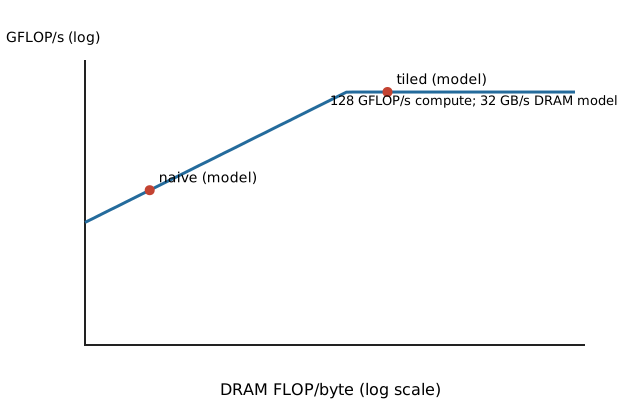
朴素模型假设每次乘加各从 DRAM 读取 A、B 的一个 4 字节元素,C 每个输出只读写一次:流量为 8N³+8N²=134,742,016 byte,强度为 33,554,432/134,742,016≈0.249 FLOP/byte,模型上界约 7.969 GFLOP/s。边长 32 的分块模型理想流量为 8N³/32+8N²=4,718,592 byte,强度约 7.111 FLOP/byte,计算屋顶截断后的模型上界是 128 GFLOP/s。两条流量式都假设所需数据留在片上且忽略冲突、写分配和额外访存,不是 DRAM 计数器读数。
这两个点只表达数据复用可能让瓶颈从带宽侧移向计算侧。真实实现还会受指令组合、并行度、缓存容量、对齐和调度开销影响,因此实测点通常落在屋顶线下。
模式:先固定层级,再算强度
1 | |
CPU cache blocking、GPU shared memory tiling 和矩阵加速器片上复用都能使用这个模式。层级变化时必须重新计算分母,不能沿用同一个强度值。
验收结果
本批脚本由矩阵尺寸、字节数和 FLOP 数计算两个上界并生成 SVG 图;measured=false、measured_points=[]。当前没有矩阵 kernel、峰值校准或 DRAM 流量及带宽实测,模型上界不能写成测得的吞吐。
练习
带宽改为 16 GB/s 时,两个点的上界分别是多少?
同一 kernel 的 DRAM 运算强度和 L1 运算强度为什么可能不同?
模式速查
| 输入 | 在模型中的作用 | 常见误用 |
|---|---|---|
| 峰值计算能力 | 水平屋顶 | 当成应用实测性能 |
| 峰值带宽 | 斜线斜率 | 与别的机器参数混用 |
| 运算强度 | 决定模型位置 | 不注明字节流量层级 |
一手参考资料