
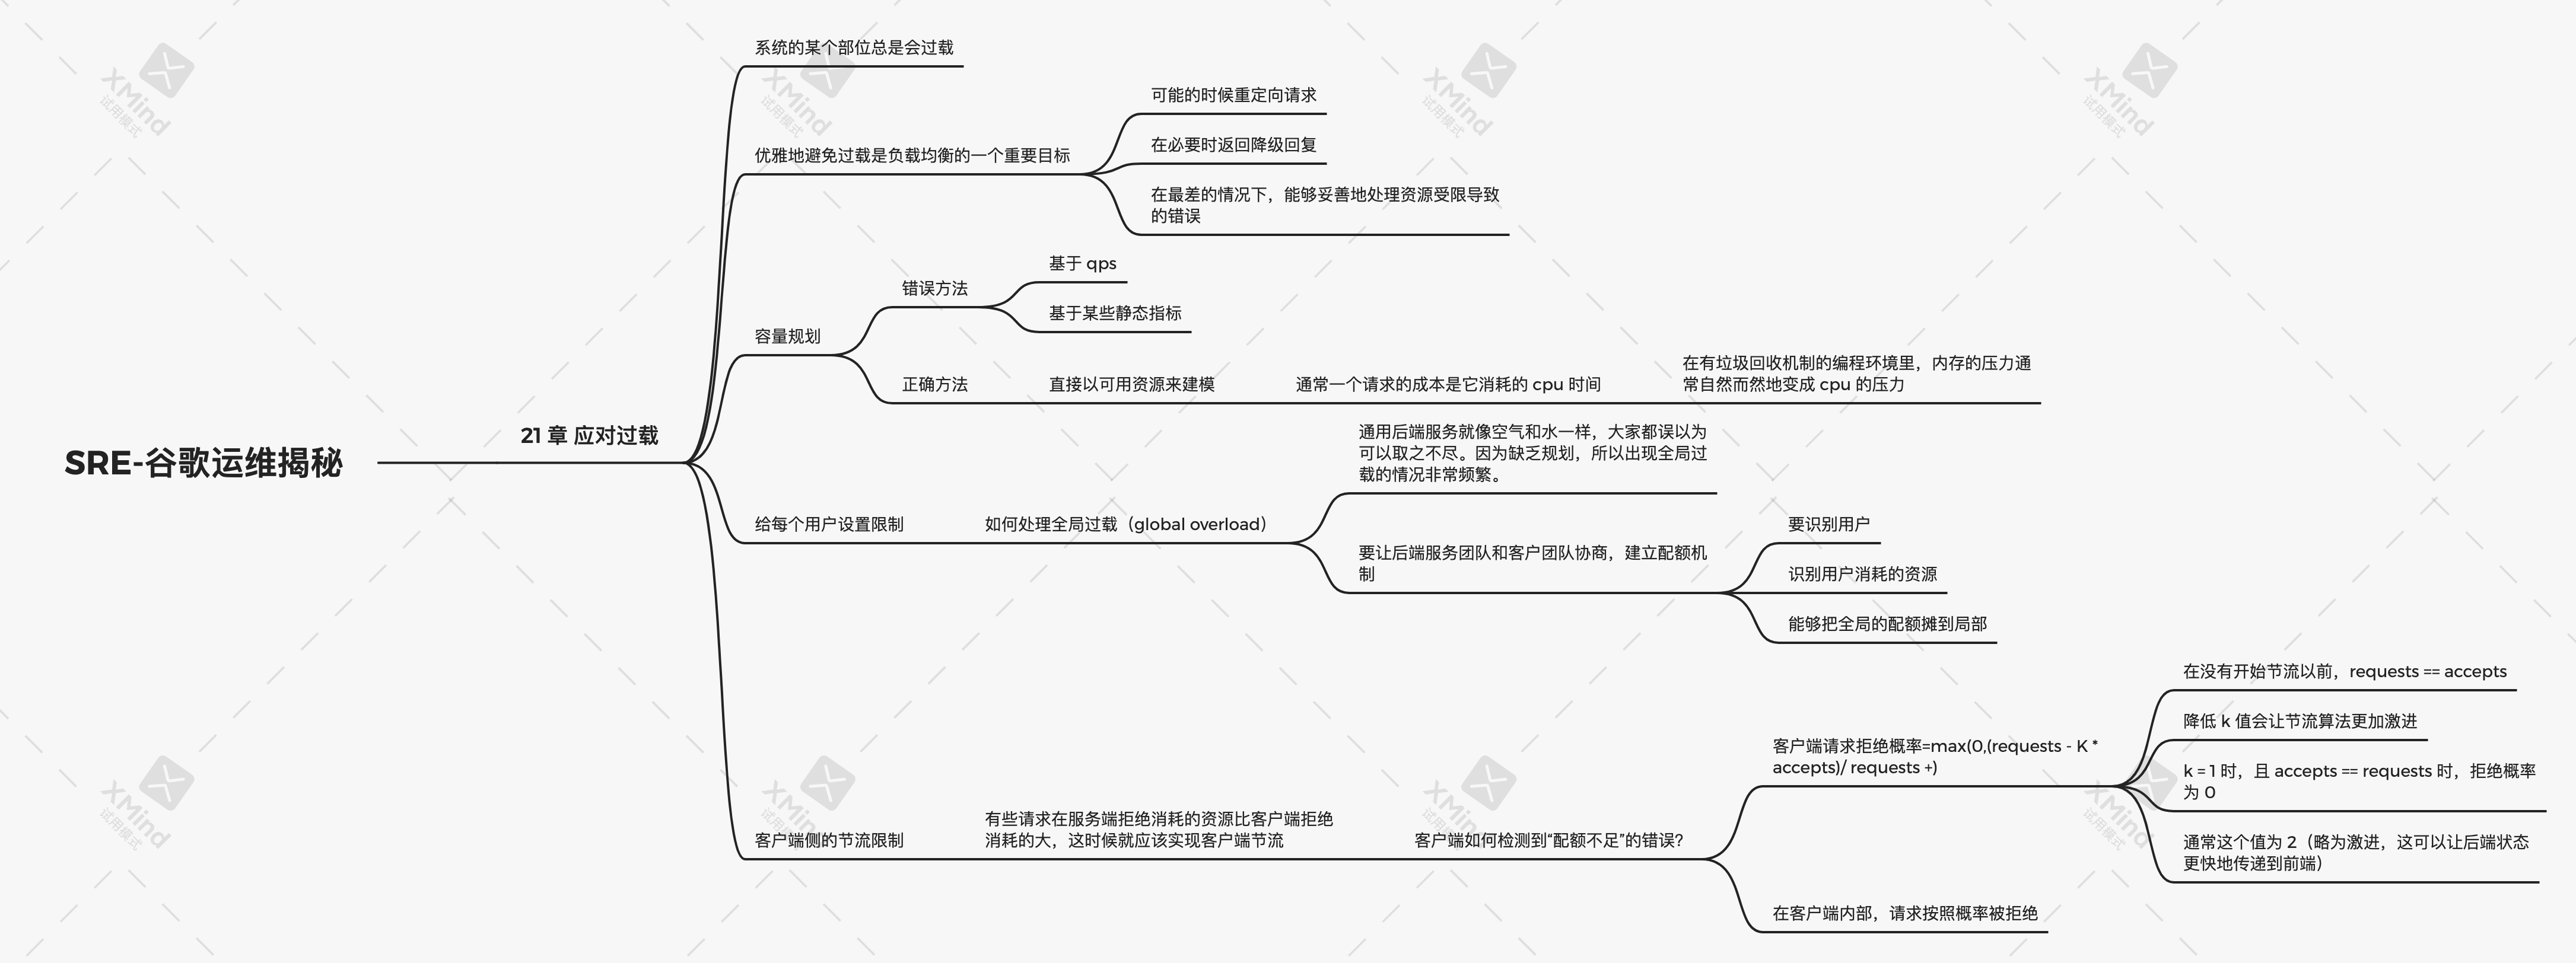
SRE-谷歌运维揭秘
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles

2025-07-29
数据库写入的潜规则——合并树与 MPP 架构深度剖析
许多开发者在使用 ClickHouse、HBase、Elasticsearch 等现代数据系统时,都会遇到"不建议高频写入"的限制。这一限制常被归因于"列式存储",但这是一个常见的误解。 高频写入受限的根本原因在于数据库的存储引擎架构。本文将深入剖析四大主流架构——LSM-Tree、ClickHouse MergeTree、MPP 和 B-Tree——分析它们各自的写入机制、性能权衡,以及它们"偏爱"批量写入的底层原因。 Part 1: 磁盘 I/O 基础——理解一切的前提 深入存储引擎之前,有必要先理解磁盘 I/O 的基本特性,因为所有存储引擎的设计都是围绕磁盘特性做出的权衡。 随机写 vs 顺序写 指标 HDD(机械硬盘) SSD(固态硬盘) 内存(DRAM) 随机写 IOPS ~100-200 10K-100K ~10M 顺序写吞吐 ~100-200 MB/s 500 MB/s - 3 GB/s ~10 GB/s 随机写延迟 ~10ms(寻道时间) ~100μs ~100ns 顺序写延迟...

2026-06-20
生产运维:集群扩缩、监控指标与故障排查
上一篇解决了安全体系的认证、授权与加密。这一篇进入生产运维。 生产运维容易被理解为"改配置 + 重启"。更准确的说法是:Kafka 集群的运维本质上是对分布式日志的分区所有权、副本状态和元数据的受控迁移,每一步操作都在改变哪些 broker 持有哪些 partition 的哪个角色。 本文只抓三个问题:如何安全地扩缩 broker,应该盯哪些 JMX 指标,以及遇到常见故障时从哪里开始排查。 集群扩缩容模型 Kafka 集群的 broker 状态可以用一个简化模型描述: 123456789101112当前集群: [broker-0, broker-1, broker-2]partition 分布: topic-A-0 -> leader=0, follower=[1,2] topic-A-1 -> leader=1, follower=[0,2]加 broker-3 后: broker-3 加入集群,无 partition -> 手动触发 partition reassignment topic-A-0 -> leader=0...

2026-09-04
分布式 ID 系统设计:从需求约束推导架构
数据库自增列足以支撑单库业务。系统拆成多个写入节点后,ID 生成突然变成一项基础设施能力:它要避免碰撞,不能拖慢写路径,还要经受扩容、时钟异常、数据库切换、配置漂移和跨地域网络分区。 这类系统最容易从算法名称开始讨论:UUID、Snowflake、数据库序列、号段。算法当然重要,但架构并不是从算法列表里挑出来的。它来自一组可验证的约束:唯一到什么范围,顺序要强到什么程度,故障时允许停多久,ID 可以暴露什么信息,以及团队能维护多少协调状态。 先定义 ID 的合同 “生成一个全局唯一且递增的 ID”看似明确,实际混合了几种不同语义。若不拆开,评审阶段达成的共识很可能只是每个人对同一句话的不同理解。 唯一性有作用域 唯一性至少要说明三个边界: 命名空间:全公司、单业务、单租户、单表,还是单个分片。 时间范围:进程存活期间、数据保留期,还是系统整个生命周期。 保证方式:确定性不重叠,还是碰撞概率低到工程上可接受。 数据库序列和合理分配的 Snowflake 节点空间可以给出确定性的不重叠保证。UUIDv4 依靠足够大的随机空间降低碰撞概率。两者都常被称为“全局唯一”,但证明路径并...
2025-07-29
Java 集合框架完全指南
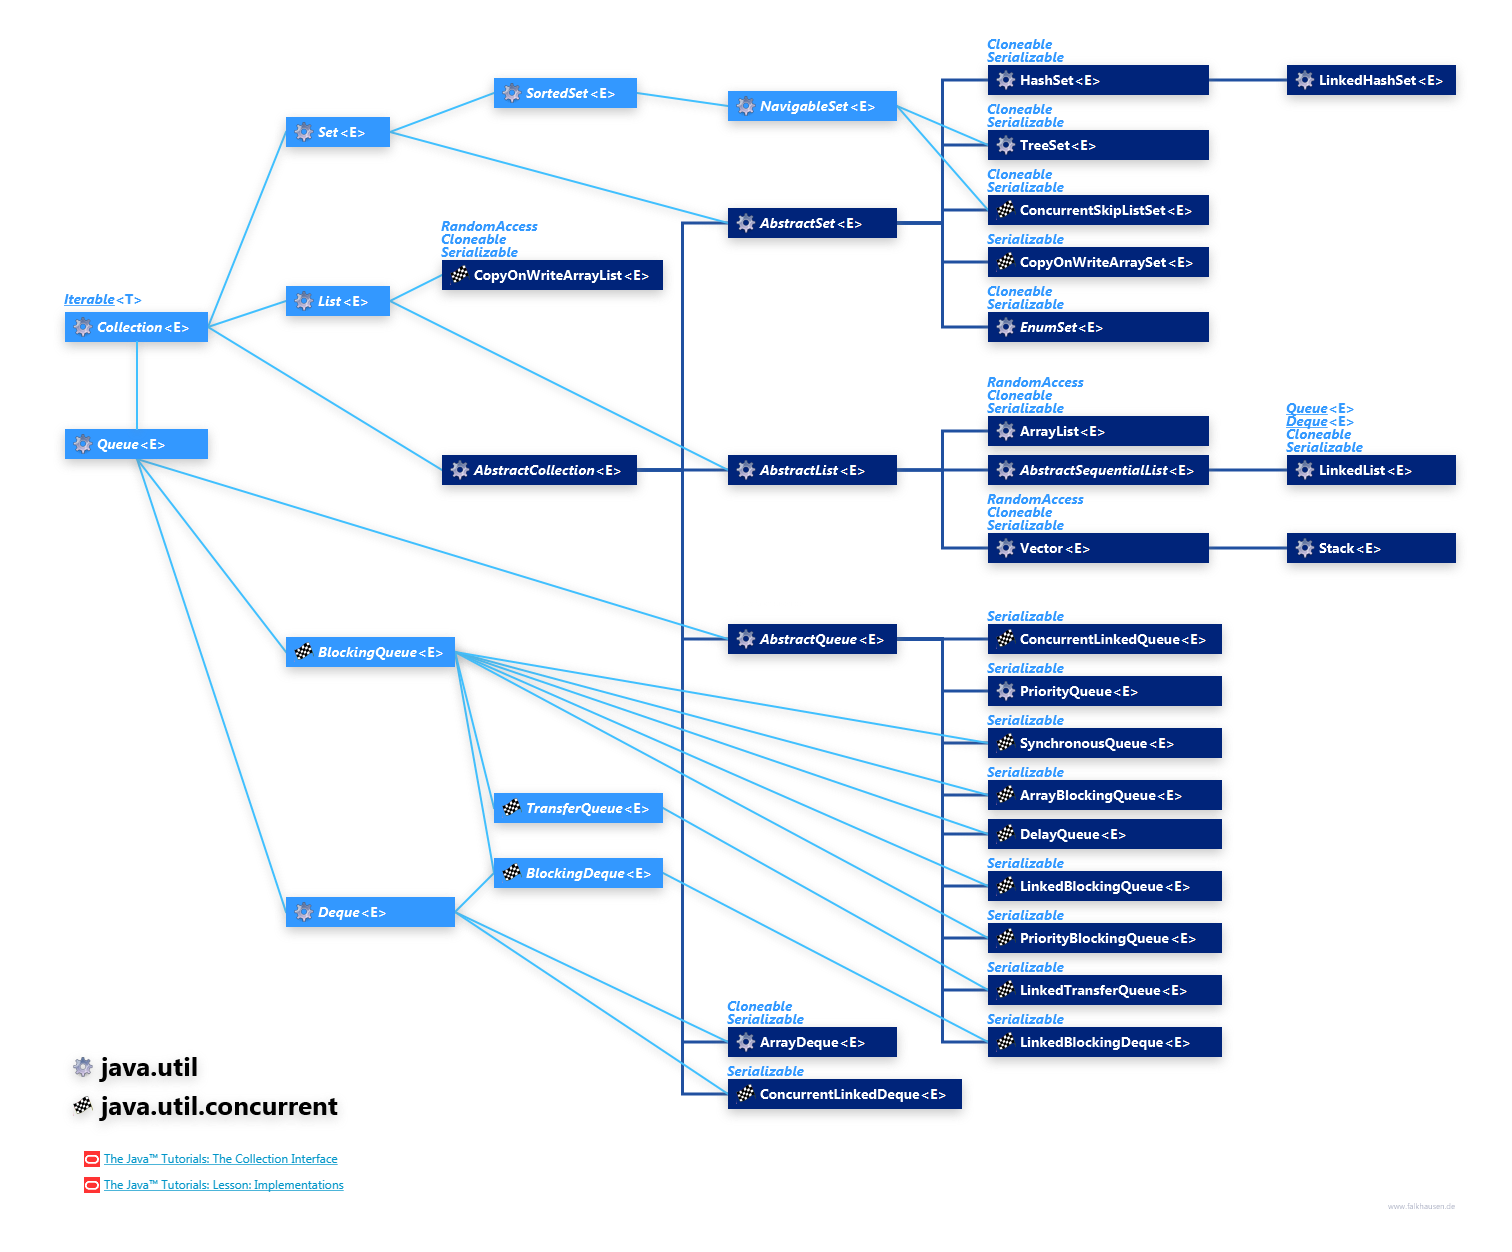
Java 集合框架完全指南 本文系统性地介绍 Java 集合框架的核心概念、实现原理和设计模式。内容涵盖集合框架体系结构、列表与队列机制、哈希表家族的扩缩容策略、缓存淘汰算法实现以及系统级扩缩容设计。通过深入分析源码实现和性能特征,帮助理解各集合类的适用场景和最佳实践。 第一章:全景导图 文章结构 模式总览 模式名 口诀 覆盖场景 扩容因子1.5倍 扩容1.5倍,平衡空间时间 ArrayList扩容、StringBuilder扩容 队列六操作 add/offer/put,peek,poll/take 所有队列实现的标准操作 优先级堆 小顶堆TopK,大顶堆调度 PriorityQueue、任务调度 延迟队列 getDelay负值出队,compareTo排序 DelayQueue、缓存过期、订单超时 扰动函数 高16异或低16,分散哈希冲突 HashMap哈希优化 2的幂容量 位运算取余,快速计算索引 HashMap、ConcurrentHashMap 树化阈值8 泊松分布概率,红黑树优化 HashMap性能优化 反树化阈值6 低于阈值退...

2021-09-05
基本编程范式、模型和风格
盒子模型 表达式由一系列盒子组成,这些盒子相互决定位置和大小。 流水线模型 模式-动作范式 一系列的输入会被每个模式所检查,模式匹配时,执行相应的输入。 复杂流程总-分架构 流程被分为:step1、step2、step3;stage1、stage2、stage3;phase1、phase2、phase3。 数据只要可以在同层内串联,每一层就可能被抽象成 step。如果 step 的输入输出是无关的,则需要使用 context 模式;否则使用 stream 模式,每个 step 可以由<T,R>指定输入输出类型,每个 step 的输出会成为下一个阶段的输入。。每一步如果可以在实现上变化,可以使用策略模式,如果需要实现差异化的聚合,需要使用组合模式。 我们使用 Step 的时候最好先指定<T,R>。

2026-04-14
Anthropic Managed Agents 深度研究:解耦大脑与双手的架构哲学
原文链接:Scaling Managed Agents: Decoupling the brain from the hands 研究时间:2026-04-14 研究方法:多轮迭代搜索 + 交叉验证 + 结构化综合 前言:从"程序即未设想之物"说起 Anthropic 在 2026 年 4 月发布的 Managed Agents 服务,解决了一个经典的计算机科学问题:如何为"尚未设想的程序"设计系统。 这个问题的答案,早在几十年前操作系统设计时就已经给出——通过虚拟化硬件为通用抽象(进程、文件),使得 read() 系统调用既能访问 1970 年代的磁盘组,也能访问现代 SSD。抽象层保持稳定,底层实现自由演进。 Managed Agents 做了同样的事情:将 Agent 组件虚拟化为三个核心组件——Session(追加式事件日志)、Harness(调用 Claude 并将工具调用路由到相关基础设施的循环)、Sandbox(Claude 可以运行代码和编辑文件的执行环境),并在此基础上通过**两个扩展维度——Many Brains(多...


