CI/CD 方法论的前世今生
软件工程有一条反直觉的规律:集成的频率越高,每次集成的痛苦越小。这条规律从 1990 年代末被 Kent Beck 写进极限编程的实践清单,到今天演化出一整套涵盖构建、测试、部署、发布的自动化体系。CI/CD 不是某一个工具或某一种流程,而是三十年工程实践反复迭代的产物。
持续集成的诞生(1996-2006)
极限编程与 CI 的起源
1996 年,Kent Beck 加入克莱斯勒公司的 C3(Chrysler Comprehensive Compensation System)项目。这个项目此前陷入僵局,Beck 将它作为极限编程(XP)的试验田,引入了十二条核心实践,持续集成是其中之一。CI 的核心主张很简单:开发者每天多次将代码集成到主干,每次集成都触发自动构建和测试。1999 年出版的《Extreme Programming Explained: Embrace Change》正式将 CI 确立为一个命名实践。
CI 要解决的问题在当时有一个形象的说法叫"集成地狱"(integration hell)——团队各自开发数周甚至数月,最后合并代码时发现冲突遍地、Bug 丛生。CI 的药方是缩短集成周期,把痛苦分散到每天的小增量里。Martin Fowler 后来给了一句被广泛引用的评价:“持续集成并不能消除 Bug,而是让它们非常容易发现和改正。”
flowchart LR
    A[开发者提交小增量] --> B[集成到主干]
    B --> C[自动构建]
    C --> D[自动测试]
    D -->|通过| E[保持可集成]
    D -->|失败| F[立即修复]
    F --> B
持续集成把一次大合并拆成多个小反馈回路
CruiseControl:第一个 CI 服务器
2001 年,ThoughtWorks 开源了 CruiseControl——业界公认的第一个专用 CI 服务器。CruiseControl 用 Java 编写,能在代码签入后自动触发构建,并通过邮件通知结果。此前团队要做 CI,只能靠 cron 脚本或手动触发,CruiseControl 把这件事变成了一个可配置的基础设施。ThoughtWorks 后来又推出了 CruiseControl.NET 和 CruiseControl.rb,覆盖 .NET 和 Ruby 生态。
ThoughtWorks 在 CI/CD 文化中的角色不止于此——Martin Fowler 长期担任 ThoughtWorks 的首席科学家,Jez Humble 也出自这家公司。CI/CD 方法论的理论化和工具化,很大程度上由 ThoughtWorks 这一组织推动。
sequenceDiagram
    participant Dev as 开发者
    participant SCM as 源码仓库
    participant CC as CI 服务器
    participant Build as 构建机
    participant Notify as 结果通知
    Dev->>SCM: 签入代码
    SCM-->>CC: 发现变更
    CC->>Build: 构建并测试
    Build-->>CC: 通过或失败
    CC->>Notify: 发布结果
CI 服务器把提交、构建和反馈连接成自动回路
Fowler 的十条准则
2006 年 5 月,Martin Fowler 在个人网站上发表了《Continuous Integration》一文(至今仍在更新),给出了 CI 的十条核心实践:
- 维护一个单一的源码仓库
- 自动化构建
- 让构建过程包含自测
- 每次提交都在集成机器上构建
- 保持构建速度(十分钟以内)
- 在生产环境的克隆上测试
- 让任何人都能轻松拿到最新可交付物
- 所有人都能看到构建结果
- 自动化部署
- 构建失败时立即修复
这十条准则至今仍是评判一个团队 CI 成熟度的基准线。很多团队号称"在做 CI",实际上只做到了自动化构建,连构建自测和构建速度都没有保障。
flowchart TD
    Repo[单一源码仓库] --> Build[自动化构建]
    Build --> Test[构建包含自测]
    Test --> Commit[每次提交都验证]
    Commit --> Feedback[公开结果]
    Feedback --> Fix[失败立即修复]
    Test --> Package[生成可交付物]
    Package --> Env[在生产环境克隆上验证]
    Env --> Deploy[自动化部署]
CI 准则的主线是让提交快速进入可验证、可交付状态
从 Hudson 到 Jenkins:一次影响深远的分裂
2005 年,Sun Microsystems 的工程师 Kohsuke Kawaguchi 开发了 Hudson,最初只是一个解决个人痛点的副项目。Hudson 凭借易用性和插件生态迅速增长,到 2009 年已经成为全球使用最广泛的 CI 服务器。
2010 年,Oracle 收购 Sun Microsystems 后,主张对 Hudson 商标的所有权,并试图将项目迁移到 Oracle 基础设施上。开发者社区对 Oracle 的治理方式产生严重不信任。2011 年 1 月,社区投票决定将项目 fork,新项目命名为 Jenkins(两个名字都来自英式管家的形象)。Oracle 保留了 Hudson 之名,但缺乏社区支撑的 Hudson 很快边缘化,Jenkins 则发展为全球最大的开源 CI/CD 生态系统。
flowchart LR
    H[2005 Hudson] --> G[社区增长]
    G --> O[2010 Oracle 收购 Sun]
    O -->|治理与商标分歧| F[2011 社区 fork]
    F --> J[Jenkins:社区主线]
    F --> R[Hudson:Oracle 维护]
开源项目的分裂点同时涉及代码、治理和社区归属
持续交付的理论奠基(2010)
《持续交付》与部署流水线
2010 年 8 月,Jez Humble 和 David Farley 出版了《Continuous Delivery: Reliable Software Releases through Build, Test, and Deployment Automation》。这本书由 Martin Fowler 作序,在 CI 的基础上提出了一套完整的交付体系。
书中最核心的概念是部署流水线(Deployment Pipeline):代码从提交到上线,经过一条自动化的阶段序列——提交阶段(编译+单元测试)→ 自动验收测试 → 用户验收测试 → 预发布环境 → 生产环境。每个阶段都是一道质量关卡,任何环节失败都会阻断流水线。
Humble 还明确区分了两个容易混淆的概念。持续交付(Continuous Delivery)是指软件始终处于可发布状态,何时发布是一个业务决策,由人拍板。持续部署(Continuous Deployment)则是每次通过所有自动化测试的提交都自动部署到生产环境,不需要人工审批。多数企业实践的是持续交付;持续部署对自动化测试覆盖率和监控体系的要求极高,只有 Etsy、Amazon、Netflix 等少数组织在大规模实践。
flowchart LR
    C[代码提交] --> S[提交阶段:编译与单测]
    S --> A[自动验收测试]
    A --> P[预发布环境]
    P --> Ready[可发布制品]
    Ready -->|人工决策| Delivery[持续交付]
    Ready -->|自动门禁通过| Deployment[持续部署]
Delivery 保证可发布,Deployment 自动完成发布
书中还有一条被广泛引用的原则:“如果一件事做起来很痛苦,就更频繁地做它。”(If it hurts, do it more often.)这与 Kent Beck 在 CI 上的思路一脉相承——缩小批次,分散风险。
基础设施即代码
部署流水线要求环境可重复创建,这推动了基础设施即代码(Infrastructure as Code, IaC)的发展。IaC 工具的演进脉络如下:
| 年份 | 工具 | 特点 |
|---|---|---|
| 1993 | CFEngine | Mark Burgess 开发,最早的配置管理工具 |
| 2005 | Puppet | 声明式 DSL,代理模式 |
| 2009 | Chef | Ruby 编写基础设施代码,代理模式 |
| 2012 | Ansible | 无代理,YAML 声明,2015 年被 Red Hat 收购 |
| 2014 | Terraform | HashiCorp 出品,HCL 语言,云平台无关,plan/apply 工作流 |
从 CFEngine 到 Terraform,IaC 工具经历了从命令式到声明式、从代理到无代理、从单机到云原生的转变。Terraform 的 plan/apply 模式先预览变更再执行,后来成为 GitOps 工作流的直接前身。
flowchart LR
    C[配置管理] --> CF[CFEngine]
    CF --> P[Puppet]
    P --> Ch[Chef]
    Ch --> A[Ansible:无代理]
    A --> T[Terraform:plan/apply]
    T --> G[GitOps:声明状态持续对齐]
IaC 把一次性的环境操作变成可审查、可重复的状态变更
分支策略的三次范式转移
分支模型决定三件事:开发者多久把代码放回共享主线,发布从哪里产生,线上修复怎样回到后续版本。比较 GitFlow、GitHub Flow 和 Trunk-Based Development(TBD)时,不能只数分支,也不能把“feature 分支超过一天”当作长期分支的判据。更有效的尺度是:哪些分支长期存在,临时分支何时结束,团队多久完成一次集成。
三种模型的实际分支流转
三种模型都允许临时分支,区别在于共享主线的数量和临时分支回归主线的速度。GitFlow 的 feature、release、hotfix 都是有退出条件的辅助分支;GitHub Flow 只保留一条默认分支;TBD 既可以直接提交 trunk,也可以使用通常不超过一两天的短分支。
flowchart TB
    subgraph GF[GitFlow:版本化发布]
        GFmain[main:长期生产主线]
        GFdev[develop:长期开发主线]
        GFfeat[feature/*:临时]
        GFrel[release/*:临时]
        GFhot[hotfix/*:临时]
        GFdev --> GFfeat --> GFdev
        GFdev --> GFrel --> GFmain
        GFmain --> GFhot --> GFmain
        GFrel --> GFdev
        GFhot --> GFdev
    end
    subgraph GH[GitHub Flow:主干加短分支]
        GHmain[main:唯一长期分支]
        GHfeat[主题分支:完成一个变更]
        GHpr[Pull Request / CI / 评审]
        GHmain --> GHfeat --> GHpr --> GHmain
        GHmain --> GHrelease[从 main 发布]
    end
    subgraph TBD[Trunk-Based Development:主干持续可发布]
        TBDtrunk[trunk/main:始终可发布]
        TBDfeat[可选短分支:小增量\n通常不超过 1-2 天]
        TBDreview[预合并 CI]
        TBDrel[可选 release:只做稳定化]
        TBDtrunk --> TBDfeat --> TBDreview --> TBDtrunk
        TBDtrunk --> TBDrel
        TBDtrunk -. 修复回灌 .-> TBDrel
    end
三种模型的核心区别:长期分支数量、集成位置、发布来源
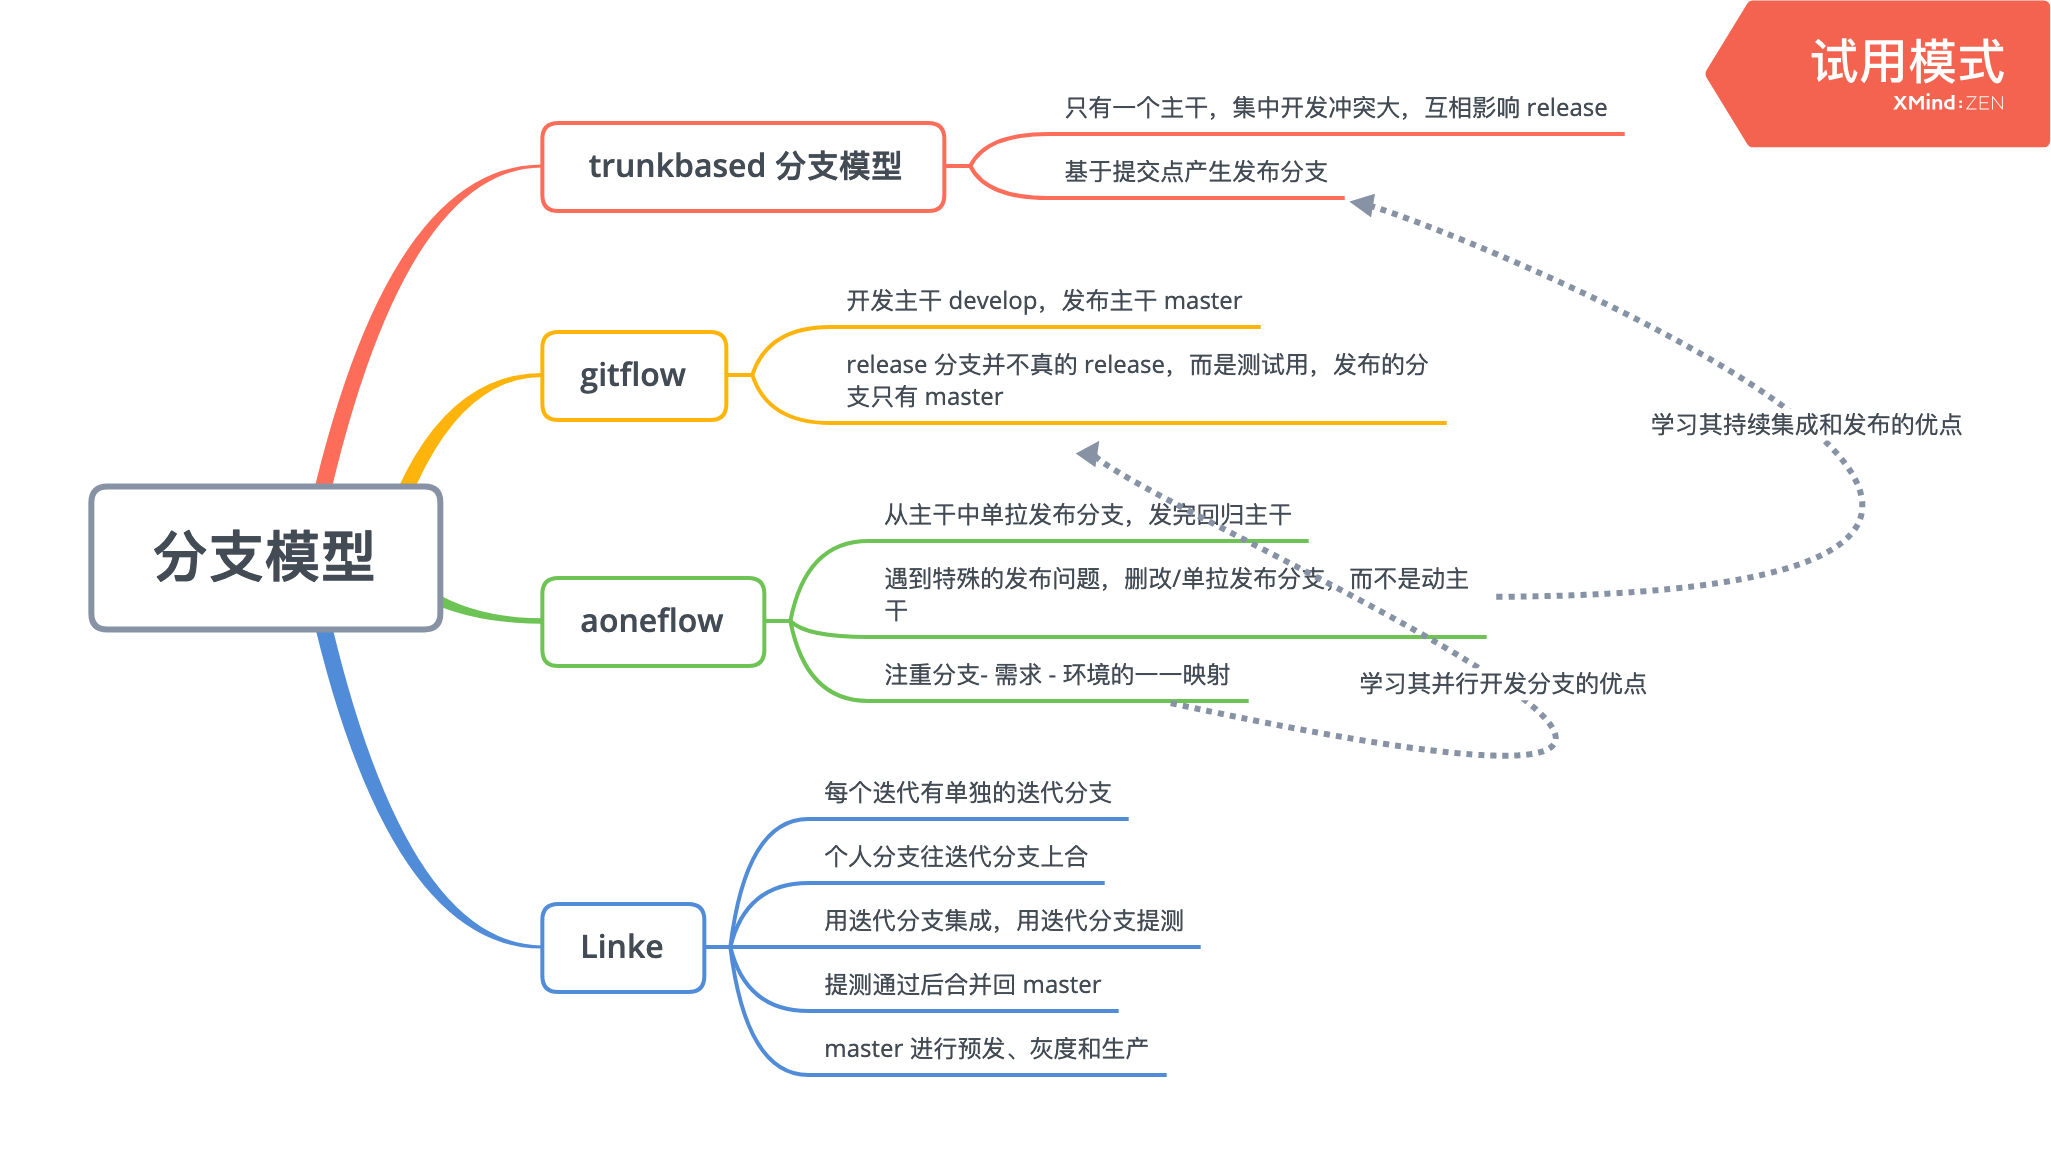
这张项目变体图补充了 AoneFlow、Linke 等团队约定;它们不是本文要定义的行业标准,采用前仍需明确各自的合并方向、分支寿命和发布来源。
GitFlow
2010 年,Vincent Driessen 发布了《A successful Git branching model》。这套模型有两条长期主线:main 记录生产版本,develop 汇集下一个版本的开发结果。feature/*、release/* 和 hotfix/* 都是辅助分支,完成任务后删除。
以“订单支持优惠券,目标版本为 2.4”为例,分支会这样流动:
flowchart LR
    Main23[main\nv2.3 已上线] --> Hotfix[hotfix/2.3.1\n修复线上支付错误]
    Hotfix --> Main231[main\n打 tag v2.3.1]
    Hotfix --> Develop[develop\n下个版本集成线]
    Develop --> Feature[feature/coupon\n开发优惠券]
    Feature --> Develop2[develop\n合入并删除 feature]
    Develop2 --> Release[release/2.4\n回归、版本号、发布说明]
    Release --> Main24[main\n打 tag v2.4.0]
    Release --> Develop3[develop\n带回发布期修复]
GitFlow 的两条主线长期存在,三类辅助分支都在任务结束后退出
feature/coupon 从 develop 创建。它可以存在数天或数周,因为寿命由功能规模和团队协作方式决定;“存在超过一天”不会把它变成长期主线。开发完成后,它合入 develop 并删除。
准备 2.4 时,团队从 develop 创建 release/2.4。这条分支只接收回归修复、版本号和发布说明,不再接收新功能。发布通过后,release/2.4 合入 main 并打 v2.4.0 标签,同时把发布期修复带回 develop,然后删除。
如果 2.3 正在生产环境出现紧急支付错误,hotfix/2.3.1 从 main 创建。修复既要进入 main 形成 2.3.1,也要回到 develop,避免下一个版本重新引入同一缺陷。
GitFlow 适合有明确版本列车、需要同时维护生产版本和下一个版本的产品。它的成本也来自这里:功能先在 feature 内开发,再进入 develop,最后经过 release 才进入 main,集成反馈和生产反馈之间隔着多道合并。Driessen 后来在原文中补充说明,持续交付的 Web 应用通常更适合简单模型。
GitHub Flow
GitHub Flow 只有一条长期默认分支。每个独立变更从 main 创建主题分支,提交后通过 Pull Request 接受讨论、自动检查和评审;合入后删除主题分支。是否自动部署由团队流水线决定,不是 GitHub Flow 本身强制规定的步骤。
同一个优惠券需求不必在一个分支里封闭开发五天。更稳妥的拆法是先合入数据库兼容层和默认关闭的 Release Toggle,再分别合入计价逻辑、接口和页面入口。每个 Pull Request 都让 main 保持可部署,功能在开关打开前不对普通用户可见。
sequenceDiagram
    participant Main as main
    participant Branch as add-coupon-pricing
    participant PR as Pull Request
    participant CI as 自动检查与评审
    participant Deploy as 部署流水线
    Main->>Branch: 从最新 main 创建主题分支
    Branch->>PR: 推送提交并尽早开 Draft PR
    PR->>CI: 测试、静态检查、代码评审
    CI-->>PR: 通过
    PR->>Main: 合并小增量
    Main->>Deploy: 构建并按团队策略发布
    Deploy-->>Main: 删除主题分支;异常时回滚提交或制品
GitHub Flow 用 Pull Request 承载协作,默认分支始终是唯一集成点
GitHub 官方流程并未给主题分支规定固定时限。分支应该围绕一个相关变更,合并后删除;如果一个需求长期不能合入,通常应继续拆小,或用特性开关隐藏尚未开放的路径。
Trunk-Based Development
TBD 的长期共享分支只有 trunk/main。小团队可以直接提交主干;规模较大的团队通常使用短分支完成评审和预合并检查。TBD 对短分支有明确的时间压力:通常在一两天内合回主干,避免它演变成另一个集成分支。
优惠券需求需要拆成可独立集成的小步:先增加向后兼容的数据字段,再加入保持现有结果的计算骨架。随后接入默认关闭的 Release Toggle,最后逐步开放。每一步都进入 trunk,并且不妨碍 trunk 构建和发布。
sequenceDiagram
    participant Trunk as trunk/main
    participant Branch as 可选短分支
    participant CI as 预合并 CI
    participant Flag as Release Toggle
    participant Release as 可选 release/2.4
    Trunk->>Branch: 切出不超过一两天的小增量
    Branch->>CI: 提交并验证
    CI->>Trunk: 合入后立即删除分支
    Trunk->>Flag: 未完成功能保持关闭
    Trunk->>Release: 临近版本时切稳定化分支
    Trunk-->>Release: 修复先进入 trunk,再回灌 release
TBD 允许短分支和发布分支,但日常集成不能离开 trunk
TBD 的 release 分支是可选的。需要同时维护多个已发布版本时,可以在临近发布时从 trunk 切出 release 分支;它只接收稳定化修复,不承载下一轮功能开发。修复优先进入 trunk,再按需要回灌到仍受支持的 release 分支,防止主干遗漏线上修复。
同一个需求在三种模型中的差异
flowchart LR
    Change[优惠券需求] --> GF2[GitFlow\nfeature → develop → release → main]
    Change --> GH2[GitHub Flow\n主题分支 → PR → main]
    Change --> TBD2[TBD\n小增量 → trunk]
    GF2 --> Batch[随 2.4 版本列车发布]
    GH2 --> Merge[合并后形成可部署版本]
    TBD2 --> Toggle[持续集成,按开关开放]
同一需求在三种模型中经过的集成点和发布时间不同
| 比较项 | GitFlow | GitHub Flow | TBD |
|---|---|---|---|
| 长期共享分支 | main、develop |
main |
trunk/main |
| 优惠券代码先进入哪里 | feature/coupon,完成后进 develop |
主题分支,经 PR 进 main |
直接进 trunk,或经一两天短分支进入 trunk |
| 生产版本从哪里产生 | main 上的版本标签 |
默认分支合并后的提交或制品 | trunk;需要版本维护时可从 release 分支发布 |
| 未完成功能怎样处理 | 留在 feature,或额外使用开关 | 拆小后配合开关合入 main | 依赖小步集成、Branch by Abstraction 或 Release Toggle |
| 线上修复怎样回流 | hotfix 同时回到 main 和 develop |
从 main 修复并合回 main |
先修 trunk,再回灌仍受支持的 release |
| 主要约束 | 分支职责和合并方向 | PR 质量与默认分支可部署性 | 极短集成周期和主干持续健康 |
容器化与云原生 CI/CD
Docker 统一了构建环境
2013 年 3 月,Solomon Hykes 在 PyCon 上发布了 Docker。Docker 对 CI/CD 的影响是根本性的:它让"在我机器上能跑"变成了"在任何机器上都能跑"。CI 服务器不再需要为每种语言和框架维护独立的构建环境,只需要一个 Dockerfile 就能复现完整的构建上下文。
构建环境的可重复性问题,在 Docker 之前一直是 CI 的痛点。不同机器上的依赖版本、系统库版本、编译器版本的微小差异,都可能导致"CI 过了但生产环境挂了"的问题。容器镜像把这些变量全部锁定。
flowchart LR
    Source[源码] --> Dockerfile[Dockerfile]
    Dockerfile --> Image[不可变镜像]
    Image --> CI[CI 测试环境]
    Image --> Staging[预发布环境]
    Image --> Prod[生产环境]
同一份镜像贯穿验证和发布,环境差异从构建阶段被显式化
Kubernetes 重塑编排
2014 年 6 月,Google 发布了 Kubernetes,脱胎于其内部的 Borg 和 Omega 系统。Kubernetes 在 2016 年加入 CNCF 后迅速成为容器编排的事实标准。
Kubernetes 对部署策略的影响尤其显著。滚动更新(Rolling Update)成为 Deployment 资源的内置策略,通过 maxSurge 和 maxUnavailable 两个参数就能控制更新节奏。蓝绿、金丝雀等策略则借助 Istio、Argo Rollouts 等工具实现。
flowchart LR
    Spec[Deployment 期望状态] --> Controller[Deployment Controller]
    Controller --> Old[旧 ReplicaSet]
    Controller --> New[新 ReplicaSet]
    Old --> PodsOld[旧 Pods]
    New --> PodsNew[新 Pods]
    PodsNew --> Health[就绪检查]
    Health --> Controller
Kubernetes 控制器通过观测和调谐逐步逼近期望状态
SaaS CI 与 GitHub Actions
CI 工具在 2010 年代经历了从自托管到云托管的转变:
| 年份 | 工具 | 意义 |
|---|---|---|
| 2010 | Travis CI | 第一个主流 SaaS CI,YAML 配置,与 GitHub 深度集成 |
| 2011 | CircleCI | SaaS CI,强调速度和并行化 |
| 2012 | GitLab CI | 与代码仓库统一产品,2016 年合并为 GitLab CI/CD |
| 2018 | GitHub Actions | GitHub 原生 CI/CD,2019 年 11 月 GA |
| 2019 | Tekton | CNCF 项目,Kubernetes 原生流水线 |
GitHub Actions 把 CI/CD 变成了代码托管平台的内置能力,工作流定义文件(YAML)和代码放在同一个仓库里版本管理。
flowchart LR
    Self[自托管 CI] --> SaaS[SaaS CI]
    SaaS --> Repo[代码平台内置 CI/CD]
    Repo --> Cloud[云原生流水线]
    Self --> Jenkins[Jenkins 等插件化服务器]
    SaaS --> Travis[Travis / CircleCI]
    Repo --> Actions[GitHub Actions / GitLab CI]
    Cloud --> Tekton[Tekton 等 Kubernetes 原生组件]
CI 的边界逐步从独立构建机移动到代码平台和集群控制面
GitOps:Git 即运维
2017 年,Weaveworks CEO Alexis Richardson 提出 GitOps:把 Git 仓库作为基础设施和应用配置的事实来源,再由控制器持续校正集群状态。
GitOps 的两个代表性工具是 Flux(Weaveworks,2016 年启动,2022 年 CNCF 毕业)和 Argo CD(Intuit,2018 年推出,2022 年 CNCF 毕业)。GitOps 把 Terraform 的 plan/apply 思路用于 Kubernetes 集群管理:变更集群状态时提交 Git commit,再由控制器执行并校正漂移。
flowchart LR
    Commit[Git 提交配置] --> Controller[GitOps Controller]
    Controller --> Diff[比较声明状态与实际状态]
    Diff -->|有差异| Apply[应用变更]
    Apply --> Cluster[集群实际状态]
    Cluster --> Diff
    Diff -->|一致| Observe[持续观测]
    Observe --> Diff
GitOps 的核心是持续调谐,不是把 kubectl 命令换成 Git 提交
从部署到发布:先分层,再组合
滚动重启、滚动更新、蓝绿、Canary、Shadow、Feature Toggle 和 A/B Test 经常出现在同一张“发布策略对比表”里,但它们解决的不是同一层问题。滚动更新处理实例替换,Canary 控制真实流量的暴露范围,Shadow 用于旁路验证,Feature Toggle 在应用内部选择代码路径,A/B Test 则是实验方法。把这些概念放在一条坐标轴上,会得到“哪种策略更好”这类没有明确对象的问题。
flowchart TB
    Change[一次代码变更] --> Runtime[实例与环境层\nRolling Restart / Rolling Update / Blue-Green]
    Runtime --> Exposure[流量暴露层\n全量切换 / Canary]
    Exposure --> Validation[验证与决策层\n冒烟 / 内部预览 / Shadow / 指标门禁]
    Validation --> Feature[功能与实验层\nFeature Toggle / A-B Test]
    Feature --> Users[用户看到新行为]
这些机制可以组合,但不能作为同一层的互斥选项比较
第一层:实例与环境怎样变化
这一层只回答运行载体发生了什么变化。它不直接说明哪些用户会看到新版本,也不保证业务指标健康。
滚动重启(Rolling Restart)
滚动重启逐个停止并重新启动实例,期望镜像版本保持不变。它常用于重新加载配置或 Secret、节点维护、进程资源回收。由于没有引入 v2,滚动重启本身不是新版本发布方式。
sequenceDiagram
    participant LB as 负载均衡
    participant A as v1 实例 A
    participant B as v1 实例 B
    LB->>A: 摘除流量
    A->>A: 重启同一个 v1
    A-->>LB: 健康检查通过
    LB->>B: 摘除流量
    B->>B: 重启同一个 v1
    B-->>LB: 健康检查通过
Rolling Restart 改变进程状态,不改变应用版本
滚动更新(Rolling Update)
滚动更新创建 v2 实例并逐步淘汰 v1。Kubernetes Deployment 用 maxSurge 控制额外实例数,用 maxUnavailable 控制更新期间允许不可用的实例数。控制器主要依据副本数和就绪状态推进,并不知道订单成功率是否下降。
stateDiagram-v2
    [*] --> Old: v1 = 4, v2 = 0
    Old --> Mixed1: v1 = 3, v2 = 1
    Mixed1 --> Mixed2: v1 = 2, v2 = 2
    Mixed2 --> Mixed3: v1 = 1, v2 = 3
    Mixed3 --> New: v1 = 0, v2 = 4
    New --> [*]
Rolling Update 描述副本替换顺序,不自动构成业务层 Canary
1 | |
更新期间 v1 与 v2 同时服务,因此接口、消息和数据库 schema 必须支持新旧版本共存。
蓝绿部署(Blue-Green Deployment)
蓝绿部署保留两套可运行环境。蓝环境继续承载生产流量,绿环境部署 v2 并通过预览入口完成验证;推广时把生产入口切到绿环境。旧环境暂时保留时,回切可以很快。
flowchart LR
    Users[生产流量] --> Active[Active Service]
    Active --> Blue[蓝环境 v1]
    Preview[Preview Service] --> Green[绿环境 v2]
    Check[预发布分析] --> Green
    Promote{推广?} -->|是| Active
    Active -. 切换后 .-> Green
    Promote -->|否| Blue
蓝绿解决环境切换;切换可以全量,也可以再叠加流量分配机制
蓝绿需要额外容量,并且快速回切只覆盖应用和路由。数据库写入、消息副作用以及不可逆的数据迁移不会因为入口切回蓝环境而自动恢复。
第二层:流量怎样进入新版本
流量层可以一次性把入口切到 v2,也可以逐步扩大真实用户范围。Canary Release 属于后一种发布政策:先让受控的一小部分生产流量访问新版本,观察技术与业务指标,再继续放量或中止。
Canary Release
flowchart LR
    Traffic[生产流量] --> Router[分流规则]
    Router -->|稳定流量| V1[v1]
    Router -->|1% 或指定人群| V2[v2 Canary]
    V1 --> Metrics[对照指标]
    V2 --> Metrics
    Metrics --> Gate{达到门禁?}
    Gate -->|是| Expand[5% → 20% → 50% → 100%]
    Expand --> Router
    Gate -->|否| Abort[流量归零并保留证据]
Canary 的闭环是受控暴露、观测、扩大或中止
Canary 不限定基础设施实现。至少有四种常见办法:
| 实现 | 分流依据 | 优点 | 限制 |
|---|---|---|---|
| 副本比例 | v1/v2 实例数量 | 不需要独立流量网关 | 比例受副本数限制,请求分布也未必精确 |
| L7 权重 | 网关或服务网格的流量权重 | 1%、5% 等比例更精确 | 需要额外流量控制面 |
| 人群路由 | 用户、租户、地域、Header | 可以先覆盖员工或白名单租户 | 样本可能不代表整体流量 |
| Release Toggle | 应用内按用户或百分比选择代码路径 | 不一定需要两套服务版本 | 新旧路径共处一个进程,隔离边界较弱 |
Rolling Update 能否实现 Canary
可以,但需要补上暂停、观测和继续/中止决策。假设总副本数为 10,先创建 1 个 v2、保留 9 个 v1,在确认指标后再继续替换,这相当于用容量比例近似 10% Canary。Argo Rollouts 在没有独立流量路由时也采用这种方式逼近 setWeight。
flowchart LR
    Update[Rolling Update] --> One[1 个 v2 + 9 个 v1]
    One --> Pause[暂停替换]
    Pause --> Observe[比较 v1 / v2 指标]
    Observe -->|通过| Continue[继续滚动到 100%]
    Observe -->|失败| Stop[缩容 v2,保留 v1]
Rolling Update 提供实例替换;暂停和指标门禁把它组织成 Canary
这种实现有两个边界。第一,10 个副本只能自然表达 10% 的粒度,无法精确给 1% 流量。第二,负载均衡按连接或请求分配时,单个 v2 实例不一定恰好收到 10% 流量。需要精确权重、指定人群或 v2 实例数与流量比例解耦时,应使用网关或服务网格。
第三层:新版本怎样被验证
暗部署、内部预览和 Shadow 都能在全面发布前提供证据,但它们不是 Canary 的同义词。它们可以作为 Canary 之前的验证步骤,也可以独立使用。
暗部署与内部预览
“暗部署”(Dark Deployment 或 Dark Launch)并没有唯一实现。常见含义是代码已经进入生产环境,但普通用户还看不到:v2 可以没有生产路由,也可以只开放预览入口,或由默认关闭的 Release Toggle 隐藏。只要没有真实外部用户进入新路径,它就还没有开始 Canary。
flowchart LR
    Deploy[部署 v2 到生产基础设施] --> Hidden{怎样保持不可见}
    Hidden --> Zero[生产流量权重为 0]
    Hidden --> Preview[仅预览域名或内部 Header]
    Hidden --> Off[Release Toggle 默认关闭]
    Zero --> Smoke[冒烟与依赖检查]
    Preview --> Internal[内部用户验证]
    Off --> Internal
    Smoke --> Canary[随后可进入 Canary]
    Internal --> Canary
暗部署描述“已部署但未公开”,Canary 描述“已向少量真实用户开放”
Shadow Traffic
Shadow 将线上请求复制一份给 v2,主请求仍由 v1 返回。Istio 把这种能力称为 traffic mirroring;镜像请求在主请求链路之外执行,v2 响应不会返回给用户。
flowchart LR
    User[真实请求] --> Gateway[入口]
    Gateway --> Stable[v1:处理并返回响应]
    Gateway -. 请求副本 .-> Shadow[v2:执行但丢弃响应]
    Stable --> User
    Shadow --> Compare[比较延迟、错误和结果]
Shadow 验证生产流量下的行为,但不验证用户看到 v2 后的真实交互
Shadow 适合查询、搜索、推荐和协议兼容性验证。写请求必须隔离副作用,例如阻断下游写入、写入影子存储或使用可识别的模拟依赖,否则可能产生重复订单、重复消息或污染主库。由于用户没有收到 v2 响应,Shadow 也不能替代真实用户 Canary。
第四层:功能怎样向用户开放
Feature Toggle
Feature Toggle 把“代码是否已部署”和“功能是否可见”拆开。代码中的 Toggle Point 负责选择路径,Toggle Router 根据配置和请求上下文给出决策。它是一种控制机制,不是一种固定部署拓扑。
flowchart TD
    Request[请求上下文] --> Router[Toggle Router]
    Config[配置、比例、用户或租户规则] --> Router
    Router --> Point[Toggle Point]
    Point -->|关闭| Old[旧路径]
    Point -->|开启| New[新路径]
    Old --> Metrics[统一观测]
    New --> Metrics
Toggle Router 决定谁走哪条路径,Toggle Point 执行这个决定
Martin Fowler 按用途列出四类 Toggle:
| 类型 | 解决的问题 | 典型生命周期 | 例子 |
|---|---|---|---|
| Release Toggle | 未完成或暂不公开的代码能否进入主干 | 通常短期,发布稳定后清理 | 优惠券入口默认关闭 |
| Experiment Toggle | 用户稳定分组后走哪个实验方案 | 覆盖实验周期 | 结算页按钮文案 A/B |
| Ops Toggle | 运行时是否启用高成本或高风险能力 | 多数短期,少量 kill switch 长期存在 | 高负载时关闭个性化推荐 |
| Permissioning Toggle | 哪些用户或套餐拥有能力 | 可以长期存在 | 企业版、白名单、内测用户 |
flowchart LR
    Toggle[Feature Toggle] --> Release[Release\n发布时机]
    Toggle --> Experiment[Experiment\n实验分组]
    Toggle --> Ops[Ops\n运行控制]
    Toggle --> Permission[Permissioning\n权益与权限]
“四种”是按用途分类;动态性、寿命和决策输入是另外的维度
因此,“Feature Toggle 有几种”有两个答案。按 Fowler 的用途分类是四种;从工程管理看,还要标明它是静态还是动态、短期还是长期、全局决策还是按请求决策。Release Toggle 可以实现功能级 Canary,例如先对 1% 用户打开优惠券;Ops Toggle 和 Permissioning Toggle 则不因为使用了同一种开关基础设施就自动变成 Canary。
Java 中编译期常量、字节码处理和运行时 Feature Flag 的更新粒度,见《Java 中的条件编译》。把开关用于可逆架构演进的做法,见《演进式架构》中的“默认关闭、验证后全量开启”。
每个短期开关都应有负责人和删除条件。测试需要覆盖开、关两条路径;发布完成后不清理旧开关,会留下不可见的组合状态和过时代码。
A/B Test
A/B Test 的目标是比较方案对业务行为的因果影响。它需要稳定分组、统一指标和统计判断,最终产物是实验结论。Canary 的目标是控制发布风险,最终通常收敛到新版本全量。两者可以共用人群路由和 Feature Toggle,但判定标准不同。
flowchart LR
    Users[符合实验条件的用户] --> Cohort[稳定随机分组]
    Cohort --> A[A:原方案]
    Cohort --> B[B:新方案]
    A --> Measure[统一指标]
    B --> Measure
    Measure --> Stats[统计检验与实验结论]
A/B Test 比较产品效果;Canary 判断新版本是否可以继续放量
Progressive Delivery:把各层串成闭环
Progressive Delivery 不是排在 Canary、蓝绿之后的另一种“策略”。它是一套交付控制方式,把部署拓扑、流量或开关、自动分析、人工批准和回滚组织成可暂停的状态机。
flowchart LR
    Build[构建不可变制品] --> Deploy[Rolling Update 或 Blue-Green]
    Deploy --> Dark[无外部流量验证]
    Dark --> Expose[Canary 或 Release Toggle]
    Expose --> Analyze[技术指标 + 业务指标]
    Analyze -->|通过| Promote[扩大范围]
    Promote --> Analyze
    Promote -->|达到 100%| Finish[完成发布并清理临时开关]
    Analyze -->|失败| Abort[停止流量、回切或关闭开关]
渐进式交付的关键是每一步都有观测、门禁和反向动作
Argo Rollouts 的结构可以直观说明这种分层:BlueGreen 和 Canary 是 rollout strategy,traffic management 负责精细分流,analysis 决定继续、暂停或中止。不同机制在控制器中协作,并未被当成一组同层概念。
组合速查表
flowchart TD
    Need{当前要解决什么问题} --> Same[同版本逐个重启]
    Need --> Replace[逐步替换 v1 为 v2]
    Need --> Risk[控制真实用户风险]
    Need --> Verify[生产流量验证但不返回 v2]
    Need --> Feature[控制功能或实验分组]
    Same --> RR[Rolling Restart]
    Replace --> RU[Rolling Update 或 Blue-Green]
    Risk --> Canary[Canary + 指标门禁]
    Verify --> Shadow[Shadow Traffic]
    Feature --> Toggle[Feature Toggle;实验场景再加 A/B 设计]
先确定问题所在的层,再选择机制并组合
| 需求 | 所在层 | 首选机制 | 常见组合 |
|---|---|---|---|
| 配置加载后让所有进程生效 | 实例操作 | Rolling Restart | 摘流、健康检查、逐个恢复 |
| 用 v2 替换 v1,资源有限 | 实例替换 | Rolling Update | 就绪检查、schema 向后兼容 |
| 新环境验证后快速切换入口 | 环境拓扑 | Blue-Green | Preview Service、切换后分析 |
| 少量真实用户先用 v2 | 流量发布 | Canary | Rolling Update 或双版本实例 + 流量路由 + 指标门禁 |
| 用真实请求验证 v2,但不影响响应 | 旁路验证 | Shadow | 流量镜像、副作用隔离、结果比对 |
| 已部署代码只对部分用户开放 | 功能发布 | Release Toggle | 百分比或人群规则,可形成应用内 Canary |
| 比较两个产品方案 | 实验 | A/B Test | Experiment Toggle、稳定分组、统计分析 |
数据库变更与新旧版本共存
需要兼容数据库的条件不是“用了哪种发布名词”,而是新旧应用是否会在一段时间内共同访问同一份数据。Rolling Update、Canary 和保留旧环境的 Blue-Green 都可能出现这种状态。Rolling Restart 没有引入新版本,不属于这个问题。
蓝绿也不等于数据库隔离。两套应用环境经常共享数据库;即使数据库也做双环境,数据同步、写入切换和回退仍是独立工程问题。应用入口能够秒级回切,不代表 schema 和已写入数据可以同时回退。
flowchart LR
    Expand[Expand\n新增可选字段、表或兼容接口] --> DeployOld[旧代码仍可运行]
    DeployOld --> DeployNew[部署新代码并迁移读写]
    DeployNew --> Backfill[回填与校验数据]
    Backfill --> Observe[确认旧路径不再读写]
    Observe --> Contract[Contract\n删除旧字段、旧表或兼容逻辑]
Expand-Contract 把破坏性 schema 变更拆到新旧版本共存窗口之外
迁移脚本需要版本化、可重复验证,并明确失败后的恢复方式。删除字段、修改含义或收紧约束应放在旧版本完全退出且数据校验完成之后;双写只在确有同步需求时使用,因为它会引入顺序、幂等和一致性问题。
DevOps 运动与度量体系
从 Velocity 大会到 devopsdays
2008 年 Agile 大会上,Patrick Debois 和 Andrew Shafer 在走廊里讨论了"敏捷基础设施"的话题——这次即兴对话被视为 DevOps 运动的概念性起点。
2009 年,Flickr 的 John Allspaw 和 Paul Hammond 在 O’Reilly Velocity 大会上发表了"10+ Deploys Per Day"演讲,展示了开发和运维协作下的高频部署实践。Patrick Debois 在比利时看了这场演讲的录像后深受触动,于同年 10 月在根特组织了第一届 devopsdays 大会——DevOps 这个词就此诞生。"devops"这个拼写是为了适应 Twitter 的字符限制,从"devopsdays"的 hashtag 缩略而来。
flowchart LR
    A[2008:敏捷基础设施讨论] --> B[2009:10+ Deploys Per Day]
    B --> C[2009:devopsdays]
    C --> D[协作、自动化、快速反馈]
DevOps 的早期演进把组织协作与高频交付放进同一个问题域
DORA 四指标
2018 年,Nicole Forsgren、Jez Humble 和 Gene Kim 出版了《Accelerate》,公布了 Google DORA 团队多年调研的结论。DORA 识别出四个衡量软件交付效能的关键指标:部署频率(Deployment Frequency)、变更前置时间(Lead Time for Changes)、变更失败率(Change Failure Rate)和服务恢复时间(Time to Restore Service, MTTR)。
这项研究的价值在于用大规模实证数据证明了 CI/CD、主干开发和松耦合架构与交付效能之间的因果关系。数据表明速度和稳定性不矛盾——高效能团队在四个指标上同时领先。
flowchart LR
    Change[代码变更] --> Lead[变更前置时间]
    Change --> Frequency[部署频率]
    Deploy[部署] --> Failure[变更失败率]
    Failure --> Restore[恢复服务时间]
    Restore --> Feedback[反馈回到下一次变更]
    Feedback --> Change
DORA 指标需要一起看,单独追求部署频率会掩盖变更失败
供应链安全
2020 年 12 月的 SolarWinds 事件是 CI/CD 安全意识的转折点。攻击者在 SolarWinds 的构建流水线中注入恶意代码,通过正常的软件更新渠道分发到数千个客户组织。这次事件暴露了一个事实:CI/CD 流水线本身也是攻击面。
此后,业界围绕构建流水线的安全做了系统性的防御工作。Google 主导的 SLSA(Supply-chain Levels for Software Artifacts)框架在 2021 年发布,定义了从 L1 到 L4 的供应链完整性等级。Sigstore 项目在 2022 年 GA,提供了对构建产物进行密码学签名和验证的开源方案。这些工具正在被集成到主流 CI/CD 平台中,成为流水线的标配环节。
flowchart LR
    Source[源码与依赖] --> CI[构建流水线]
    CI --> Artifact[构建制品]
    Artifact --> Sign[签名与来源证明]
    Sign --> Registry[制品仓库]
    Registry --> Verify[部署前验证]
    Verify --> Deploy[部署环境]
供应链防护要验证制品从哪里来、由什么构建、是否被篡改
参考资料
- Continuous Integration - Martin Fowler (2006)
- Continuous Delivery - Jez Humble & David Farley (2010)
- Feature Toggles (aka Feature Flags) - Martin Fowler
- ParallelChange - Martin Fowler
- A successful Git branching model - Vincent Driessen (2010)
- GitHub Flow - GitHub Docs
- Accelerate - Nicole Forsgren, Jez Humble, Gene Kim (2018)
- What is Trunk-Based Development? - Paul Hammant
- Short-Lived Feature Branches - Trunk-Based Development
- Deployments - Kubernetes Documentation
- Canary - Argo Rollouts
- BlueGreen - Argo Rollouts
- Traffic Mirroring - Istio
- Blue/Green Data Synchronization and Schema Changes - AWS
- 10+ Deploys Per Day - John Allspaw & Paul Hammond (2009)