
性能优化
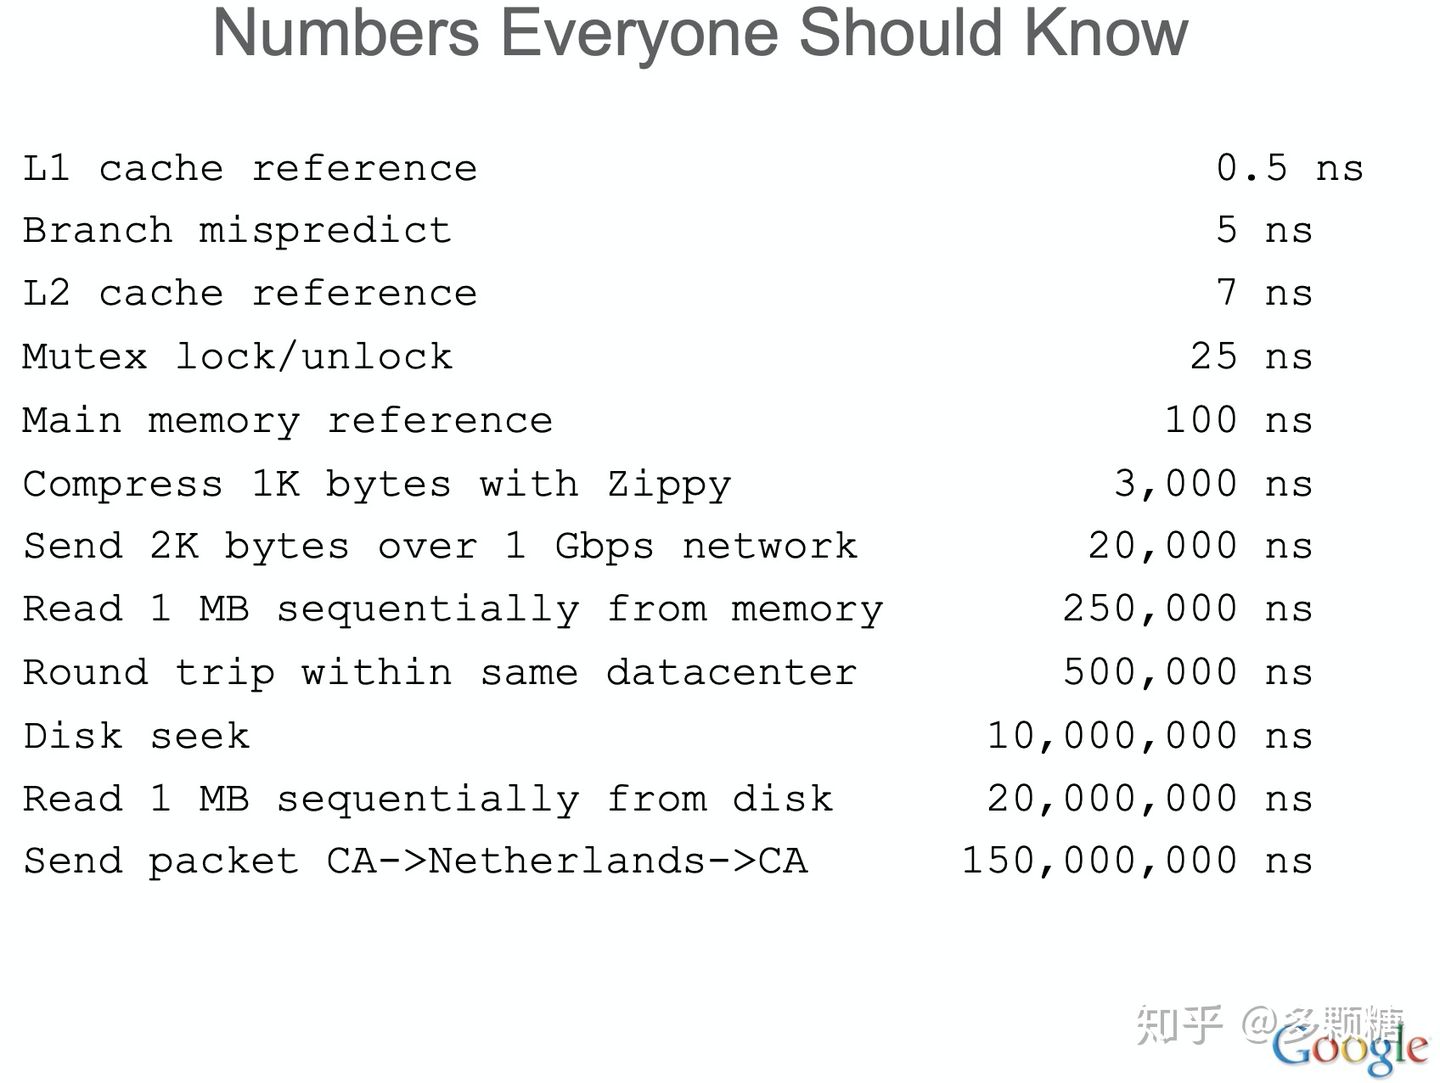
每个人都应该知道的操作时间
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles

2026-08-06
深入 Kibana 15 - 性能模型:bundle、bootstrap 与异步搜索会话
插件数量增长会直接推高前端包体和启动成本,长查询又要求结果能够在页面离开后继续保存。Kibana 的性能治理因此同时覆盖 bundle 拆分、bootstrap 顺序和后台搜索。这里的“搜索会话”在 8.15 起已经进入弃用路径,9.0 默认关闭,9.2 之后由 background search 接棒。本篇把首屏加载与后台查询放在一张性能模型里讨论。 前端 bundle 体系 Kibana 的前端代码量巨大。Discover、Lens、Dashboard、Maps、Security、Observability 加在一起,编译后的 JavaScript 体积以百 MB 计。如果把所有代码打成一个 bundle 让用户一次性下载,首屏时间会无法接受。 Kibana 的解法是三层 bundle 结构。 12345678910111213浏览器请求 Kibana 页面│├── bootstrap.js 核心 shell,极小,总是先加载│ └── 初始化运行时,注册模块加载器,决定加载哪些插件│├── core bundle 平台公共服务│ ...
2026-10-09
Go 35:profile 如何定位热点而不替代测量
上篇看到等待中的 worker 并不等于正在消耗 CPU。要找实际计算热点,先选负载,再采样;profile 给出下一步该改哪里的线索,改动是否有收益则要回到多轮基准与业务断言。本篇仍使用同一任务服务的 AnalyzeContext 和已完成任务 HTTP GET。工程包、SHA-256及独立复跑步骤带完整原始 profile。 一组 profile 必须注明两种负载 新增的 BenchmarkTaskAnalyzeContext 在计时循环外固定 strings.Repeat("Go one two 你好 ", 128),每轮实际运行当前 worker 使用的 stats.AnalyzeContext,校对词数、字节和 rune 数以及错误返回;原有 BenchmarkTaskHTTPRead 则查已完成任务,检查 200/终态/词数。两者都在 profile 采样的进程里跑,但不是同一个业务路径。未开 profile 的五轮基线、原始 -cpuprofile 和 -memprofile 文件,以及 go tool pprof -top 原文分别存于 wri...

2018-06-19
如何做性能测试的问题下的答案
试着回答一下这个问题。 首先要划分系统类型:有状态还是无状态,业务系统还是存储系统。根据不同的业务场景,设立性能测试的目标:是要测 QPS,还是 TPS 还是 TPS,还是任何其他【性能】-从广义来讲,一个存储系统到底能够以多高的平均时延来管理大多的存储空间,可能也是性能的一种。 有了性能测试的目标,接下来就是拆解用例。如果把性能测试归为测试的话,测试就需要测试用例,测试用例只是用例的形式化表达。把用户的使用场景勾勒出来,把每一步拆解成的流程图或者时序图–我们已经得到了一个纸上的集成测试计划,只是没有跟性能挂上钩。 接下来就进入真正写测试用例的环节了。 我们的测试报告如果要涵盖足够立体的信息,则既要了解每一个环节/接口/API 的性能指标,又要了解整体的性能指标。 这个时候测试工具的覆盖面就很重要了。如果我们选择偏黑盒的测试工具,apache ab /JMeter,则我们的测试用例就要围绕着对外交互的 API写,也只能测到外围接口的性能。这样的测试用例写起来最简单,无需侵入任何内部代码中。 如果我们使用了 JMH 一类的工具,则可以自由编写对任何方法的测试用例。但需要对系统有非常...

2026-06-20
性能模型:吞吐、延迟与调优思路
前面的文章覆盖了 Kafka 的核心机制和生态组件。这一篇回到工程视角:Kafka 的性能模型到底长什么样。 性能调优容易变成一张参数清单。更有效的方式是先建立一个吞吐-延迟的基本模型,再用这个模型解释每个参数的作用方向和代价。 本文只抓一个问题:Kafka 的吞吐和延迟分别由哪些因素决定,调节一个参数时另一端会发生什么变化。 性能基础:四个底层机制 Kafka 的高吞吐不是来自某个单一优化,而是四个机制叠加的结果。 1234567891011Producer Broker Consumer | | | |-- batch N records ---->| | | (linger.ms window) |-- sequential append --> | | | (page cach...
2026-10-01
容器 34:冷启动时间花在哪一段
拿一条从 docker run 到终端提示的总耗时,无法推断是拉取慢、快照准备慢、进程启动慢还是应用就绪慢。先定义测量的边界与可关联的对象,然后谈数值。 同一只 Pod 在两台节点的“启动耗时”可能相差很大:一台已有内容存储和快照,另一台要从 registry 取层;应用的探针又可能固定等待十秒。只看 kubectl wait 结束时刻,连缓存条件都无法还原,更谈不上给 OCI create 分配多少毫秒。本篇把一次启动拆成控制面可见事件、节点运行时原始事件、应用首次就绪三条时间轴;先标记哪些区间目前还不可观测,再决定能不能比较冷、热启动。 先写实验设计,后写结论 同一 probe-app 固定 image digest、节点 CPU 架构、内核与运行时版本,在专用 VM 上分冷缓存与热缓存两组。时间戳分别落在开始拉取、manifest/layer 验证结束、本机解包与 snapshot 准备结束、OCI create/start、进程首条日志、/ready=200。对同一 ID 记录事件时钟来源,跨组件不能把不同机器的墙钟未经校准就做相减。预先确定预热次数、重复次数、并发、输入...

2026-10-04
Scala 38:集合与抽象的性能证据
四种写法先算出同一个金额 订单批次的金额可以用数组上的 while 循环计算,也可以把 List、Vector 的每个订单行映射成小计,再折叠求和。Vector 的 view 则把映射推迟到消费阶段。源代码的长度不同,执行过程还受集合结构、闭包、十进制计算、JIT 与垃圾回收共同影响。要比较成本,首先要保证每一种实现完成同样的工作。 本实验把数量和单价存入 OrderLine,四种路径都使用 BigDecimal 乘法和加法,并返回整批小计。输入在基准启动前构造,测量期间复用;循环中没有文件读取、随机生成或控制台输出。正确性程序先在 1、7、512、4096 行下对照结果,同时拒绝零行负载。这些断言通过之后才运行 JMH。 状态为 LAB_VERIFIED。冻结组合是 Scala 3.3.7、Scala CLI 1.9.1、JMH 1.37、Amazon Corretto JDK 21.0.11。已经运行两 fork、每 fork 两轮预热及三轮正式测量,得到八组带原始样本的结果;GC profiler 另行运行四组诊断。代码在 examples/scala-lab/snippe...