
性能优化
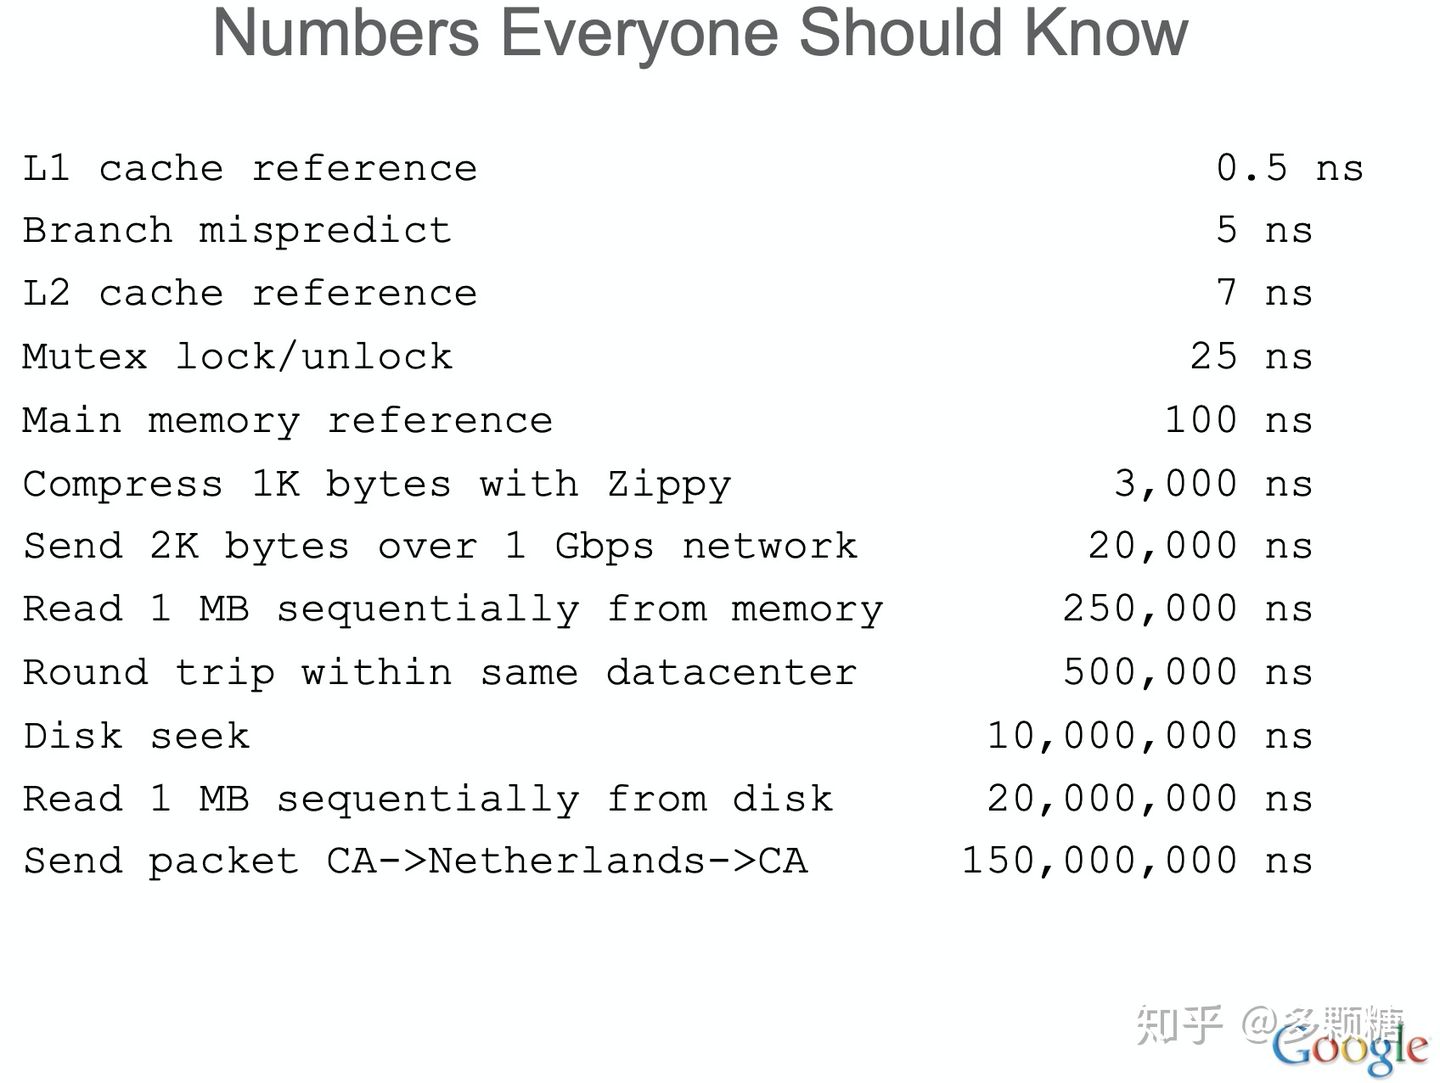
每个人都应该知道的操作时间
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles
2026-10-01
容器 35:性能差异来自隔离层还是实验条件
“容器性能损耗多少”缺少测量对象和实验条件。应用计算、内存申请、文件系统 copy-up、网络封装都在不同路径上。34只评估启动,不把 steady-state 性能一起平均。本篇先设定可以证伪的对照,再决定哪些数字能归因于容器边界。 把某个程序在宿主上执行十次、在容器里执行十次,得到两列数字后相除,并不能得出“容器比宿主慢 X%”:运行方式可能顺带改变了 CPU 配额、可用核心、进程 UID、文件路径、网络路由与镜像依赖。先用一种不碰磁盘、也不调用网络的短时计算任务建立最小对照;再单独讨论内存、OverlayFS 与网络。每次只改变一个前提,才能知道数字是哪个路径造成的。本篇没有专用 Docker/双 VM,数字一律留空,不用外部基准报告代替自己的实验。 逐项只改变一个条件 同一内核、架构、节点、二进制和输入,先在普通进程跑 bounded_load 的有界计算/内存路径,再在专用容器内跑同样命令;分别记录用户态时间、CPU/内存控制器、可运行 CPU 集与真实的 cgroup 限制。文件系统实验区分宿主相同盘的普通写入、容器可写层首次写入与同一镜像的重复写入;网络实验区分 l...

2026-05-24
Huge Page:TLB 压力和页表开销
上一篇讲了 NUMA 如何让内存访问不再均匀。但即使在单 node 系统上,当工作集足够大时,另一类开销浮现:TLB miss 和页表自身的内存消耗。Huge page 通过增大映射粒度来同时缓解这两个问题。 核心问题可以压成一句话: huge page 用更大的映射粒度减少 TLB 和页表开销,但引入碎片、分配时机和回收复杂度作为代价。 问题从哪里来 标准页大小 4KB。一个 64GB 内存的机器有 1600 万个物理页。如果一个进程映射了 8GB 工作集,对应 200 万个 PTE。 TLB(Translation Lookaside Buffer)是 MMU 的地址翻译缓存。现代 CPU 的 L1 dTLB 通常只有 64-128 个条目,L2 sTLB 有 1024-2048 个条目。200 万个活跃页面对 2048 个 TLB 条目意味着 TLB 覆盖率不足 0.1%——绝大多数访问要走 page table walk。 page table walk 不是免费的。它需要 4-5 次内存访问(每级页表一次),即使有 page walk cache 辅助,在 TLB...

2018-06-19
如何做性能测试的问题下的答案
试着回答一下这个问题。 首先要划分系统类型:有状态还是无状态,业务系统还是存储系统。根据不同的业务场景,设立性能测试的目标:是要测 QPS,还是 TPS 还是 TPS,还是任何其他【性能】-从广义来讲,一个存储系统到底能够以多高的平均时延来管理大多的存储空间,可能也是性能的一种。 有了性能测试的目标,接下来就是拆解用例。如果把性能测试归为测试的话,测试就需要测试用例,测试用例只是用例的形式化表达。把用户的使用场景勾勒出来,把每一步拆解成的流程图或者时序图–我们已经得到了一个纸上的集成测试计划,只是没有跟性能挂上钩。 接下来就进入真正写测试用例的环节了。 我们的测试报告如果要涵盖足够立体的信息,则既要了解每一个环节/接口/API 的性能指标,又要了解整体的性能指标。 这个时候测试工具的覆盖面就很重要了。如果我们选择偏黑盒的测试工具,apache ab /JMeter,则我们的测试用例就要围绕着对外交互的 API写,也只能测到外围接口的性能。这样的测试用例写起来最简单,无需侵入任何内部代码中。 如果我们使用了 JMH 一类的工具,则可以自由编写对任何方法的测试用例。但需要对系统有非常...

2026-05-24
回到工程:Linux VM 如何改变性能诊断
前面 16 篇从地址空间到 OOM,逐层拆解了 Linux 虚拟内存子系统的结构和机制。这些知识的价值不只在于读源码——更在于它提供了一种分层诊断习惯:遇到内存相关的性能问题时,先定位层次,再找对象,再看状态转移,最后用指标验证。 核心问题可以压成一句话: Linux VM 的价值不只在源码知识,而在一种分层诊断习惯:先定位层次,再找对象,再看状态转移,最后用指标验证。 系列概念地图 整个系列覆盖的层次和对象: 1234567891011121314151617181920212223用户空间视角 内核视角───────────── ──────────malloc / mmap VMA (vm_area_struct) ↓ 虚拟地址 ↓page fault 页表 (PGD→P4D→PUD→PMD→PTE) ↓ 物理页分配 ↓RSS 增长 ...

2026-08-06
深入 Logstash 06 - dissect 与结构化 filter:放弃回溯换吞吐
官方基准里,同条件单 filter 的 dissect 比 Grok 快一成到两成。这个数字小到不值得为它改配置。dissect 真正值钱的地方在另一头:它不用正则引擎,回溯那条会让单条 event 从微秒跳到秒级的路径在它这里根本不存在。 顺着这个判断往下,本篇落到三件具体的事:线性扫描的每一步怎么走、dissect 的语法能覆盖到哪、以及同一个管道里 dissect 和 Grok 怎么分工。 123456789101112131415同一行日志,两条处理路径:message: "2026-08-06T13:40:00 INFO pay-svc user=42 amount=99.50" │ ├── dissect ──── 找分隔符 ──── O(n) 线性扫描 ──── 字段 │ 无正则引擎 │ 无回溯 │ └── grok ─────── ...
2026-10-01
容器 34:冷启动时间花在哪一段
拿一条从 docker run 到终端提示的总耗时,无法推断是拉取慢、快照准备慢、进程启动慢还是应用就绪慢。先定义测量的边界与可关联的对象,然后谈数值。 同一只 Pod 在两台节点的“启动耗时”可能相差很大:一台已有内容存储和快照,另一台要从 registry 取层;应用的探针又可能固定等待十秒。只看 kubectl wait 结束时刻,连缓存条件都无法还原,更谈不上给 OCI create 分配多少毫秒。本篇把一次启动拆成控制面可见事件、节点运行时原始事件、应用首次就绪三条时间轴;先标记哪些区间目前还不可观测,再决定能不能比较冷、热启动。 先写实验设计,后写结论 同一 probe-app 固定 image digest、节点 CPU 架构、内核与运行时版本,在专用 VM 上分冷缓存与热缓存两组。时间戳分别落在开始拉取、manifest/layer 验证结束、本机解包与 snapshot 准备结束、OCI create/start、进程首条日志、/ready=200。对同一 ID 记录事件时钟来源,跨组件不能把不同机器的墙钟未经校准就做相减。预先确定预热次数、重复次数、并发、输入...