数据库容灾体系的演变
什么是容灾
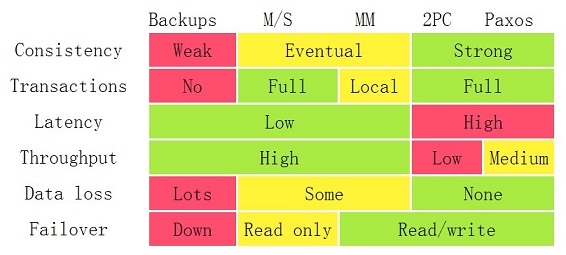
备份的分类
| 备份方式 | 说明 |
|---|---|
| 逻辑备份 | 数据库对象级备份,备份内容是表、索引、存储过程等数据库对象,如MySQL mysqldump、Oracle exp/imp。 |
| 物理备份 | 数据库文件级备份,备份内容是操作系统上数据库文件,如MySQL XtraBackup、Oracle RMAN。 |
| 快照备份 | 基于快照技术获取指定数据集合的一个完全可用拷贝,随后可以选择仅在本机上维护快照,或者对快照进行数据跨机备份,如文件系统Veritas File System,卷管理器Linux LVM,存储子系统NetApp NAS。 |
规划
要结合业务,产生多维立体的解决方案。
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles
2026-06-29
MySQL 经典架构模式:从主从复制到分库分表
MySQL 在绝大多数业务系统中扮演事实源的角色。Redis 和 ES 都是派生存储——数据可以从 MySQL 重建,反过来不行。围绕 MySQL 的架构模式,核心问题始终是三个:怎么扛住读写压力、怎么保证数据不丢、怎么随业务增长水平扩展。 下面整理十个生产环境中反复出现的 MySQL 架构模式。和 ES 架构模式 与 Redis 用例全解 形成三件套:Redis 管热路径和派生状态,ES 管可搜索的派生索引,MySQL 管事实。 模式速查 模式 解决的问题 核心机制 典型场景 主从复制 + 读写分离 读压力分摊 binlog 复制 + 代理层路由 读多写少的业务 半同步复制 + 增强半同步 主从切换时数据不丢 after-sync / after-commit 金融、订单 双主(互为主从) 机房级故障切换 双向复制 + 自增步长错开 同城双活 级联复制 大规模从库扩展 从库的从库 读流量极大的分析场景 分库分表 单库容量和写入瓶颈 水平分片 + 路由中间件 亿级数据量 影子表与 Online DDL 大表结构变更不锁表 pt-osc / gh...
2021-03-18
MySQL pitfalls 与配置札记(2018-2021 札记整合)
一、SQL 语义陷阱 引号的方言差异 标准的 SQL 中只允许用单引号表达字符串类型。有些 SQL 方言允许使用双引号包裹字符串,如 MySQL,有些则不允许,如 Oracle。 反引号是专门用来表达 identifier 的。 字符串与数字的隐式转换 pitfall Data truncation: Truncated incorrect 不要小看 MySQL,它出 warning 就一定有错误。 不要滥用 MySQL 字符串到decimal,和 decimal 到 string 的转换。这样有时候 MySQL 不只是 warning。 二、存储引擎对比 参考:https://www.zhihu.com/question/20596402 MyISAM 与 InnoDB 的区别 InnoDB 支持事务,MyISAM 不支持事务。这是 MySQL 将默认存储引擎从 MyISAM 变成 InnoDB 的重要原因之一; InnoDB 支持外键,而 MyISAM 不支持。对一个包含外键的 InnoDB 表转为 MYISAM 会失败; InnoDB 是聚集索引,MyISAM ...

2026-06-13
深翻页的本质:从 RDBMS 到 ES 和 Hive
分页通常是一个很安静的接口参数:page_no、page_size,或者 limit、offset。数据量小时,它几乎没有存在感;等列表长到几十万、几百万行之后,同一条 SQL 只是把 OFFSET 往后挪了一点,延迟却会突然变得难看。 问题不在“翻页”这个动作本身,而在系统被要求从一个有序结果集里跳过很长的前缀。RDBMS、Elasticsearch、Hive 的表现各不相同,底层代价却很接近:先把前面的候选算出来,再把它们丢掉。 这也是深翻页最容易被误解的地方。它不只是 SQL 写法问题,还牵涉访问路径、排序稳定性、产品交互,以及底层系统是否需要跨节点合并结果。一个可用的分页方案,往往先从产品语义开始,而不是从 LIMIT 990000, 1000 开始。 深翻页的成本来自“计算前缀再丢弃前缀”。优化要么把前缀变窄,要么把“第 N 页”改成“从某个锚点继续”,要么提前把结果集物化成可跳转目录。 一个大表实验 有一个很典型的大表实验:表里大约 1000 万行,按 status 过滤后命中约 100 万行。测试环境是本地硬盘,慢查询阈值按 100ms 估算。几条查询的结果很...
2018-06-06
log 的历史
Log:一种被低估的计算机科学基础抽象 在计算机科学中,log(日志)远不止是"打印调试信息"那么简单。从数据库的 WAL 到分布式系统的共识协议,从版本控制系统到区块链,log 作为一种 append-only 的有序记录序列,是贯穿整个计算机科学发展史的核心抽象之一。 LinkedIn 的前首席工程师 Jay Kreps 在其著名文章 “The Log: What every software engineer should know about real-time data’s unifying abstraction” 中指出:log 是一种比消息队列、数据库、文件系统更基础的抽象——后者都可以建立在 log 之上。 本文尝试梳理 log 这一抽象在不同技术领域中的演化脉络。 数据库中的 Log:WAL 与 Binlog WAL(Write-Ahead Logging) WAL 是数据库实现 ACID 特性的基石。其核心思想是:在修改数据页之前,先将修改操作写入日志。 WAL 的工作流程: 事务开始时,将修改操作(redo log entry)追加写...
2025-07-29
数据库写入的潜规则——合并树与 MPP 架构深度剖析
许多开发者在使用 ClickHouse、HBase、Elasticsearch 等现代数据系统时,都会遇到"不建议高频写入"的限制。这一限制常被归因于"列式存储",但这是一个常见的误解。 高频写入受限的根本原因在于数据库的存储引擎架构。本文将深入剖析四大主流架构——LSM-Tree、ClickHouse MergeTree、MPP 和 B-Tree——分析它们各自的写入机制、性能权衡,以及它们"偏爱"批量写入的底层原因。 Part 1: 磁盘 I/O 基础——理解一切的前提 深入存储引擎之前,有必要先理解磁盘 I/O 的基本特性,因为所有存储引擎的设计都是围绕磁盘特性做出的权衡。 随机写 vs 顺序写 指标 HDD(机械硬盘) SSD(固态硬盘) 内存(DRAM) 随机写 IOPS ~100-200 10K-100K ~10M 顺序写吞吐 ~100-200 MB/s 500 MB/s - 3 GB/s ~10 GB/s 随机写延迟 ~10ms(寻道时间) ~100μs ~100ns 顺序写延迟...
2017-11-15
MariaDB 调优相关
本文主要摘译自这里。 MySQL 曾经有独立的公司。但那间公司后来被 Sun 微系统公司获取了。 Sun 微系统公司又被 Oracle 获取了。原 MySQL 开发者担心 MySQL 成为闭源软件,因此成立了一家SkySQL 公司维护开源的 MySQL 分支–MariaDB。 MariaDB 支持的存储引擎包括: InnoDB/XtraDB 后者是前者的加强版,属于事务性存储引擎,也叫 ACID-compliant(ACID 遵从的)。XtraDB 是 Percona 开发的存储引擎,整体向下兼容。使用普通的 mysqldump 会耗尽 cpu(因为要把数据库转化成正经的 SQL 语句)。而 xtrabackup 在大库上的备份、还原、冗余都表现得更好(因为像 Oracle 一样是二进制备份吗?)。 TokuDB。另一个事务性存储引擎。以高压缩率著称(最高25倍压缩)。适合小空间存储大数据。 MyISAM。MySQL 上最古老的存储引擎。非事务性存储引擎,只支持表级锁,不支持 MVCC。 SphinxSE。非事务性存储引擎。这名字和古希腊猜谜语的怪兽,斯芬克斯一样。本以上是用...