
数据库容灾体系的演变
什么是容灾
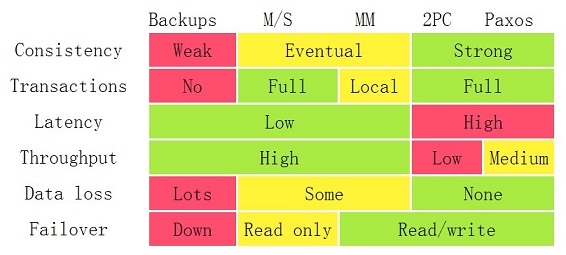
备份的分类
| 备份方式 | 说明 |
|---|---|
| 逻辑备份 | 数据库对象级备份,备份内容是表、索引、存储过程等数据库对象,如MySQL mysqldump、Oracle exp/imp。 |
| 物理备份 | 数据库文件级备份,备份内容是操作系统上数据库文件,如MySQL XtraBackup、Oracle RMAN。 |
| 快照备份 | 基于快照技术获取指定数据集合的一个完全可用拷贝,随后可以选择仅在本机上维护快照,或者对快照进行数据跨机备份,如文件系统Veritas File System,卷管理器Linux LVM,存储子系统NetApp NAS。 |
规划
要结合业务,产生多维立体的解决方案。
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles

2021-03-17
分库分表
业界方案问题 垂直拆分 优点:降低负载,提高可用性 缺点: 无法降低单表数据量 不能无限扩容 存在单点故障 join 等多表操作受限 存在跨库事务 水平拆分 优点: 降低单表数据量 理论上可无限扩容(NoSQL 通常采取这种方案) 不存在单点故障 缺点: join 等多表操作进一步受限 存在跨库事务 扩容成本高 如何分 hash 分表 常见的分表方案。 range 分表 建立时间 range,按 range 分表。 混合分表 先 hash,再 range。 怎么查 SQL 路由(route)和结果合并(merge) 多表 join 多维度查询 跨库事务 路由要定义 dsl,用语言解析表达式。 做广播表的查询的结果就是一张逻辑表查询转成多张表查询。 如果要做无分表键的查询,不如做影子表做侧维度。但影子表依赖于数据迁移服务。数据迁移服务的存在在日常的数据库运维中非常重要,它可以支持任意的 etl 的形式来同步异构数据。但这会带来成本上的坑。
2021-03-10
秒杀通用解决方案
秒杀的实质 秒杀的实质,是围绕库存管理展开的并发读写 如果架构设计里面包含商品系统,包含库存,秒杀就要解决库存热点行高并发读写问题。 秒杀的底线是:不能超卖。qty库存 ≥ qty卖出 && qty库存 - qty卖出 ≈ 0。 秒杀能够容忍的一些思路:渐进趋于一致,允许漏卖。 秒杀架构的特性 高性能:秒杀架构要承载的访问流量比平时高出许多倍,涉及大量的并发读和并发写,因此支持高并发访问非常关键。 一致性:秒杀活动中有限数量的商品在同一时刻被很多倍的请求同时扣减库存,在大并发更新的过程中要保证数据准确,不能发生超卖的问题(超卖,本来应该卖完下架的商品,在前台展示依然有库存,依然不停的被卖出),即库存是多少,理应卖出多少(qty库存 ≥ qty卖出 && qty库存 - qty卖出 ≈ 0)。 高可用:秒杀架构虽经多次打磨优化,但现实中总难免出现一些考虑不到的情况,要保证系统的高可用,还要设计一个兜底预案,以便在最坏的情况发生时仍能从容应对。 秒杀技术难点 在有限的资源下,秒杀链路承载合理的最大流量。 大并发下扣减库存准确,“一致性...
2018-06-06
log 的历史
Log:一种被低估的计算机科学基础抽象 在计算机科学中,log(日志)远不止是"打印调试信息"那么简单。从数据库的 WAL 到分布式系统的共识协议,从版本控制系统到区块链,log 作为一种 append-only 的有序记录序列,是贯穿整个计算机科学发展史的核心抽象之一。 LinkedIn 的前首席工程师 Jay Kreps 在其著名文章 “The Log: What every software engineer should know about real-time data’s unifying abstraction” 中指出:log 是一种比消息队列、数据库、文件系统更基础的抽象——后者都可以建立在 log 之上。 本文尝试梳理 log 这一抽象在不同技术领域中的演化脉络。 数据库中的 Log:WAL 与 Binlog WAL(Write-Ahead Logging) WAL 是数据库实现 ACID 特性的基石。其核心思想是:在修改数据页之前,先将修改操作写入日志。 WAL 的工作流程: 事务开始时,将修改操作(redo log entry)追加写...
2018-05-29
JPA 的 id 生成策略
JPA 有一个@GeneratedValue注解,有一个strategy attribute,如 @GeneratedValue(strategy = GenerationType.IDENTITY)。 常见的可选策略主要有IDENTITY和SEQUENCE。 GenerationType.IDENTITY 要求底层有一个 integer 或者 bigint 类型的自增列( auto-incremented column)。自增列的赋值必须在插入操作之后发生,因为这个原因,Hibernate 无法进行各种优化(特别是 JDBC 的 batch 处理,一次 flush 操作会产生很多条insert 语句,分别执行)。如果事务回滚,自增列的值就会被丢弃。数据库在这个自增操作上有个高度优化的轻量级锁机制,性能非常棒。 MySQL 支持这种 id 生成策略, 使用 MySQL 应该尽量使用这个策略,即使它无法优化。 JPA 用它生成 id,会一条一条地插入新的 entity。 GenerationType.SEQUENCE 数据库有一个所谓的 sequence 对象,可以通过 selec...
2025-07-29
数据库写入的潜规则——合并树与 MPP 架构深度剖析
许多开发者在使用 ClickHouse、HBase、Elasticsearch 等现代数据系统时,都会遇到"不建议高频写入"的限制。这一限制常被归因于"列式存储",但这是一个常见的误解。 高频写入受限的根本原因在于数据库的存储引擎架构。本文将深入剖析四大主流架构——LSM-Tree、ClickHouse MergeTree、MPP 和 B-Tree——分析它们各自的写入机制、性能权衡,以及它们"偏爱"批量写入的底层原因。 Part 1: 磁盘 I/O 基础——理解一切的前提 深入存储引擎之前,有必要先理解磁盘 I/O 的基本特性,因为所有存储引擎的设计都是围绕磁盘特性做出的权衡。 随机写 vs 顺序写 指标 HDD(机械硬盘) SSD(固态硬盘) 内存(DRAM) 随机写 IOPS ~100-200 10K-100K ~10M 顺序写吞吐 ~100-200 MB/s 500 MB/s - 3 GB/s ~10 GB/s 随机写延迟 ~10ms(寻道时间) ~100μs ~100ns 顺序写延迟...
2017-11-15
MariaDB 调优相关
本文主要摘译自这里。 MySQL 曾经有独立的公司。但那间公司后来被 Sun 微系统公司获取了。 Sun 微系统公司又被 Oracle 获取了。原 MySQL 开发者担心 MySQL 成为闭源软件,因此成立了一家SkySQL 公司维护开源的 MySQL 分支–MariaDB。 MariaDB 支持的存储引擎包括: InnoDB/XtraDB 后者是前者的加强版,属于事务性存储引擎,也叫 ACID-compliant(ACID 遵从的)。XtraDB 是 Percona 开发的存储引擎,整体向下兼容。使用普通的 mysqldump 会耗尽 cpu(因为要把数据库转化成正经的 SQL 语句)。而 xtrabackup 在大库上的备份、还原、冗余都表现得更好(因为像 Oracle 一样是二进制备份吗?)。 TokuDB。另一个事务性存储引擎。以高压缩率著称(最高25倍压缩)。适合小空间存储大数据。 MyISAM。MySQL 上最古老的存储引擎。非事务性存储引擎,只支持表级锁,不支持 MVCC。 SphinxSE。非事务性存储引擎。这名字和古希腊猜谜语的怪兽,斯芬克斯一样。本以上是用...