checklist
写代码 checklist 注意位置 注意顺序 注意初始化 注意返回值 注意注释 注意防御性编程 注意数据库性能 上线 checklist 代码变更 check 代码 配置变更 check 配置 系统变更注意上线顺序 依赖中间件变更注意配置中间件 配置中心配了吗 交互所有细节都实现了吗? 配监控和埋点 数据库变更了吗? 安全检查
JDWP 与远程调试
JDWP(Java Debug Wire Protocol),它提供了调试器和目标 JVM (target vm)之间的调试协议。 在 target vm 启动时,增加这个 JAVA_OPTS: 1JAVA_OPTS="-Xdebug -Xnoagent -Djava.compiler=NONE -Xrunjdwp:transport=dt_socket,server=y,suspend=n,address=26310" 在服务器端,增加 remote debuging 的时候使用如下配置: 12345678# Java 9 以上-agentlib:jdwp=transport=dt_socket,server=y,suspend=n,address=*:8000# Java 5-8-agentlib:jdwp=transport=dt_socket,server=y,suspend=n,address=8000# Java 1.4.x -Xdebug -Xrunjdwp:transport=dt_socket,server=y,suspend=n,addre...
卡表和 RSet
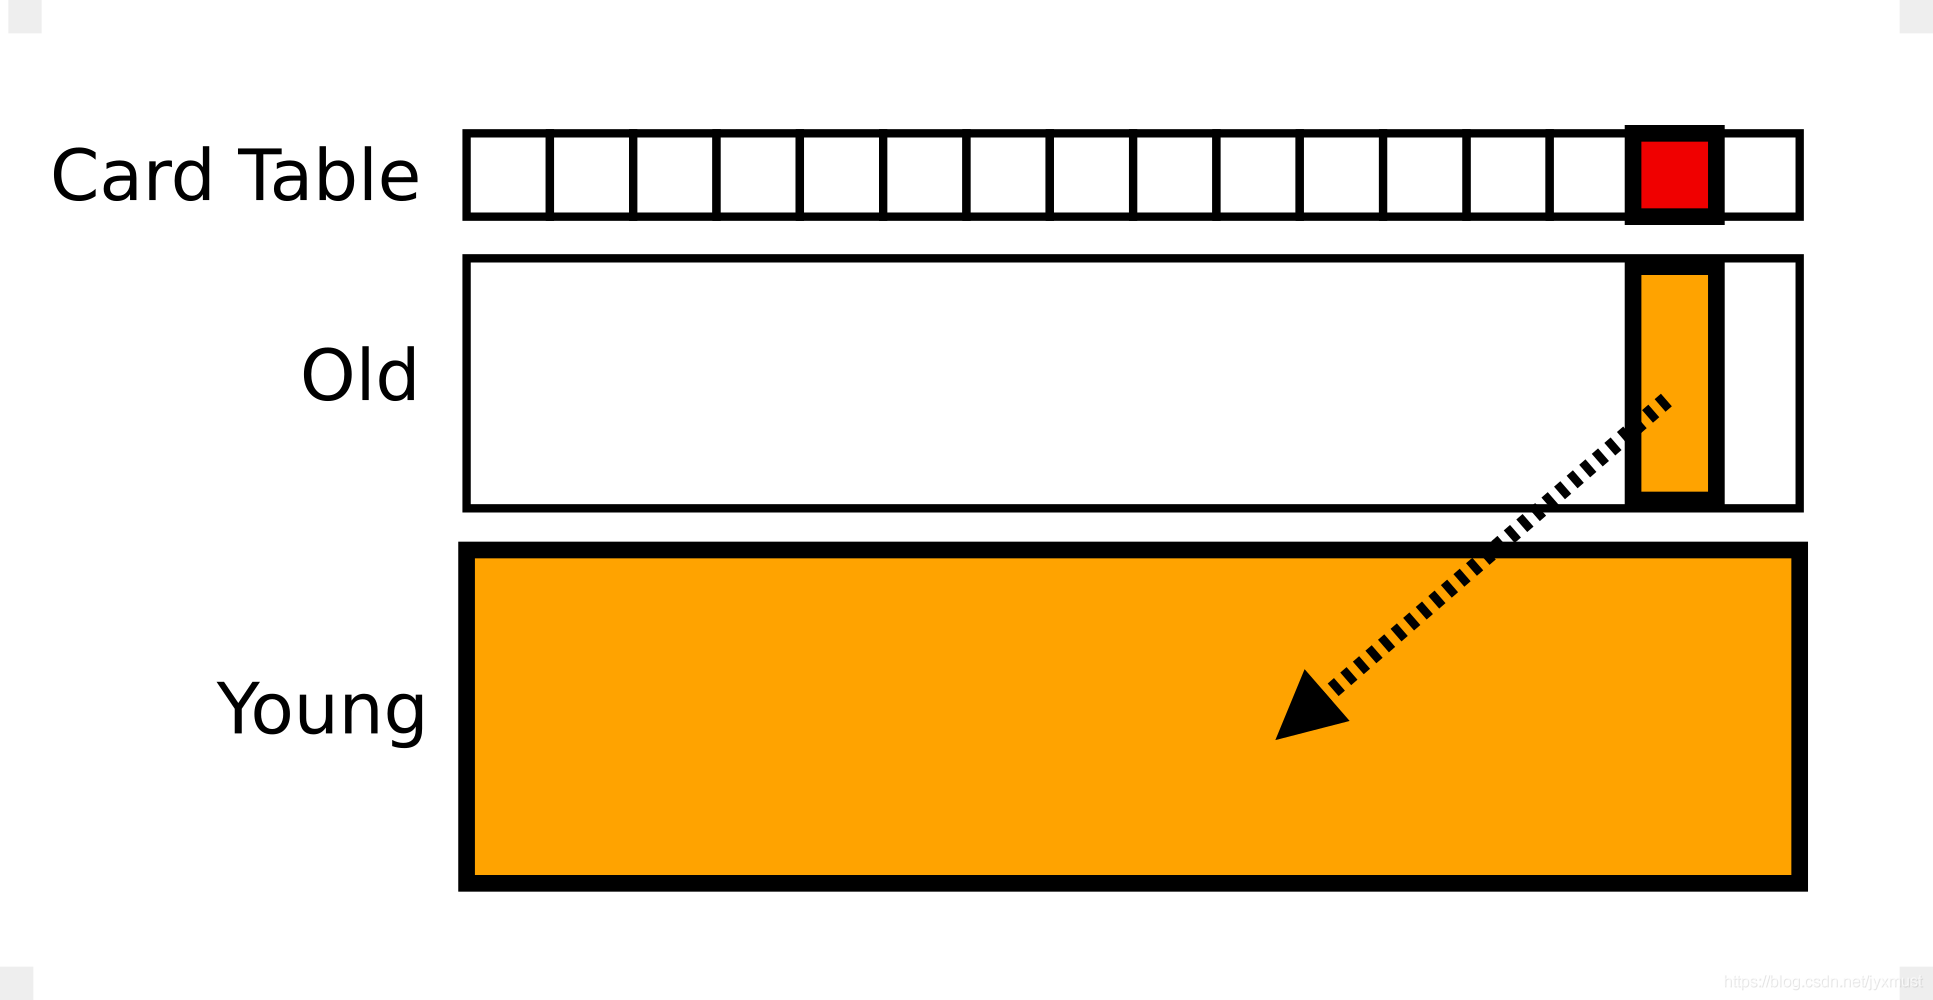
卡表和 RSet 问题定义:为什么需要跨区域引用记录 JVM 垃圾收集器的核心工作之一是确定 live set——哪些对象仍然存活、不可回收。确定 live set 的标准做法是从 GC Roots(栈帧中的局部变量、静态字段等)出发,沿引用链遍历所有可达对象。 问题在于:当堆被划分为多个区域(代、Region)并且只回收其中一部分时,如何高效地找到从"不回收区域"指向"回收区域"的引用? 以 Young GC 为例:只回收新生代,但老年代中可能持有指向新生代对象的引用。如果不处理这些跨代引用,就会错误地回收仍被老年代引用的新生代对象。最朴素的做法是扫描整个老年代来找出这些引用——但老年代通常远大于新生代,这样做的代价过高,违背了分代收集"只回收一部分堆"的初衷。 卡表(Card Table)和 RSet(Remembered Set)正是为解决这个问题而设计的辅助数据结构。二者的关系并非互相替代,而是层次不同、协作互补:卡表是底层的脏标记机制,RSet 是建立在卡表之上的更高层索引结构。 核心概念速览 在深入细节之前,...

数据建模名称规范
综合 NV + DiDi + Ali 的各种命名规范。 DO( Data Object):与数据库表结构一一对应,通过DAO层向上传输数据源对象。 DTO( Data Transfer Object):数据传输对象,Service或Manager向外传输的对象。 BO( Business Object):业务对象。 由Service层输出的封装业务逻辑的对象。 AO( Application Object):应用对象。 在Web层与Service层之间抽象的复用对象模型,极为贴近展示层,复用度不高。 VO( View Object):显示层对象,通常是Web向模板渲染引擎层传输的对象。 POJO( Plain Ordinary Java Object):POJO专指只有setter/getter/toString的简单类,包括DO/DTO/BO/VO等。 Query:数据查询对象,各层接收上层的查询请求。 注意超过2个参数的查询封装,禁止使用Map类来传输。 Entity:JPA 规范下从数据持久层存储里取出来的对等对象。其实相当于 DO 。 Request:RESTful 接...

业务分析方法
背景 从 prd 出发,分析业务需求,寻找可以创造价值的方案。 业务分析的价值 全面分析用户的各项需求 告诉我们“做什么” 业务分析的目的 理解产品需求,识别业务范围 分析业务模块的重要程度、优先级 发现产品设计的不足 为后后续测试分析做准备 业务分析方法-整体过程 用不同的动作达到不同的产出。 理解 需求背景(必须) 举例:阿里巴巴账户体系 要初步阐述:1. 产生什么价值。 2. 需要解决什么问题。3. 甚至要阐明要达到什么目标(比如,基于支付宝账户体系统一账户id)。 现状分析(必须) 产品定位 现有业务架构 产品业务范围 规划业务架构**(1. 要有分期的意识,识别产品形态。 2. 要有清洗数据的方案,预测安全风险)** 识别(抽象分析建模) 业务角色(实际上就是系统交互的输入方,有多少个角色,就需要关注多少个东西) 自然人 其他系统 业务串联(为了找业务用例。业务串联就是把一堆文字描述串在一起) 业务用例(建模-业务用例图 用例是对场景的概括) 分析业务用例(建模-活动图 活动图是对用例的拆解) 提炼(进一步建模) 关键流程 由活动图的 ...
系分方法论交流笔记
分析、设计和架构的区别 系分 = 业务分析 + 系统设计 系分其实就是 Analysis + Design 业务分析才是最重要的大头 要理解: 架构约束 项目约束 要有: 权衡 选择 的过程 理解业务,要理解业务背后的东西,产出的是模型。 一步一步走,推演出来解决方案,要有方法论。 系统设计是很明确的工作了 应用设计 + 数据设计 + 技术设计 = 系统方案 要考虑的额外问题: 非功能设计:运行关注点、运维关注点、开发关注点、测试关注点。 项目约束 常见方法论 用例驱动设计 SOAD 面向服务的分析和设计 OOAD 面向对象分析和设计 DDD 领域驱动设计 DDD特别适合复杂系统。有一个以不变应万变的对象,才可以在未来承载复杂的业务演进过程。 这几种方法论可以混合使用。 需求分析与业务建模 把 prd 从薄读到厚,把文档中缺失的部分补全。 系分做 PRD 评审的时候,影响比较大的点一定要尽早确认。一些对系统变化可控,可预测的变化,可以暂时放过,后续在补充。 面向服务的业务建模 分析主业务服务,设计业务功能域,设计业务功能域边界。这个过程可能不断地螺旋式地重构。 如果用...

日期与时间
JSR 310 Java Date与Time API 新旧 API 的更迭 旧的 Java API 主要包括java.util.Date和java.util.Calendar 两个包的内容。这两个包的时间类型是可变的。如 Date 的实例可以通过 setYear 来产生变化。 JSR 310 中包括的日期类型主要有: 计算机时间:Instant,对应 java.util.Date,它代表了一个确定的时间点,即相对于标准Java纪元(1970年1月1日)的偏移量;但与java.util.Date类不同的是其精确到了纳秒级别。 人类时间:对应于人类自身的观念,比如LocalDate和LocalTime。他们代表了一般的时区概念,要么是日期(不包含时间),要么是时间(不包含日期),类似于java.sql的表示方式。此外,还有一个MonthDay,它可以存储某人的生日(不包含年份)。每个类都在内部存储正确的数据而不是像java.util.Date那样利用午夜12点来区分日期,利用1970-01-01来表示时间。这些类型的实例是 immutable 的,而且只能通过工厂方法创建。 时区...

使用 Truffle 来编译、安装智能合约(旧文一篇)
因为官定版本的 solidity 实在编译安装太费力了,放弃,改用 Truffle。 直接用 npm 安装: 1npm install -g truffle 创建新目录,初始化新目录: 123mkdir myprojectcd myprojecttruffle init 修改配置文件 truffle.js: 12345678910 module.exports = { networks: { development: { host: "localhost", port: 8545, network_id: "*", // Match any network id gas: 500000 } }}; 生成必须的智能合约源码和迁移脚本: 1234567891011121314151617181920212223242526272829303132333435363738394041424344454647484950515253...
以太坊深度研究合集(2017-2018 旧文整合)
本文整合了 2017 年 10 月到 2018 年 8 月间一系列以太坊学习与实战笔记,包括工作机制、Gas 系统、事务与消息调用、随机数问题、硬分叉、谢灵点应用、为什么以太坊不适合做联盟链,以及 CentOS 6.7 上 geth 私链搭建、web3 安装、solidity 智能合约部署等实战。三篇 2018-08-29 的"旧文一篇"已统一收录于第五至第七章,作者当时的"旧文回顾"语气一并保留。 一、概述 以太坊(Ethereum)是一台 transactional singleton machine with shared-state——事务性状态共享的单例机器。实际上就是逻辑上唯一,但物理上由多个节点维护的共识中的 world computer。这台机器的状态是由事务变迁驱动的: 以太坊的核心区别于比特币的设计点: 引入 EVM 与图灵完备的智能合约 账户模型而非 UTXO 用 Gas 系统作为算力定价与防滥用机制 默克尔帕特里夏树存储状态、事务和收据 “幽灵协议”(GHOST = Greedy Heaviest Observe...

如何做性能测试的问题下的答案
试着回答一下这个问题。 首先要划分系统类型:有状态还是无状态,业务系统还是存储系统。根据不同的业务场景,设立性能测试的目标:是要测 QPS,还是 TPS 还是 TPS,还是任何其他【性能】-从广义来讲,一个存储系统到底能够以多高的平均时延来管理大多的存储空间,可能也是性能的一种。 有了性能测试的目标,接下来就是拆解用例。如果把性能测试归为测试的话,测试就需要测试用例,测试用例只是用例的形式化表达。把用户的使用场景勾勒出来,把每一步拆解成的流程图或者时序图–我们已经得到了一个纸上的集成测试计划,只是没有跟性能挂上钩。 接下来就进入真正写测试用例的环节了。 我们的测试报告如果要涵盖足够立体的信息,则既要了解每一个环节/接口/API 的性能指标,又要了解整体的性能指标。 这个时候测试工具的覆盖面就很重要了。如果我们选择偏黑盒的测试工具,apache ab /JMeter,则我们的测试用例就要围绕着对外交互的 API写,也只能测到外围接口的性能。这样的测试用例写起来最简单,无需侵入任何内部代码中。 如果我们使用了 JMH 一类的工具,则可以自由编写对任何方法的测试用例。但需要对系统有非常...