深入压测(07)怎样从监控证据定位瓶颈
订单接口几乎没有变慢,订单确认却大量超过 2 秒。应用 CPU 平稳,消费者的每秒完成数停在 68,消息最老年龄不断增长。此时先数清楚发布、进入队列、消费和终态各有多少工作,再判断是消费者、数据库还是别的共享资源让释放速率下降。
在同一时间轴上放四层证据
| 观察位置 | 同时看的量 | 常见情形 |
|---|---|---|
| 发压机 | 计划启动、实际启动、调度滞后、连接错误 | 施压能力先见顶 |
| 网关与服务 | 到达、有效响应、分类型延迟和拒绝原因 | 流控生效,或后端排队 |
| 存储、中间件和运行时 | 连接池等待、锁等待、分片延迟、积压及年龄、GC、配额 | 拥塞发生在局部资源 |
| 业务终态 | 同批次的受理、按时完成、迟到和失败 | 早返回掩盖下游欠账 |
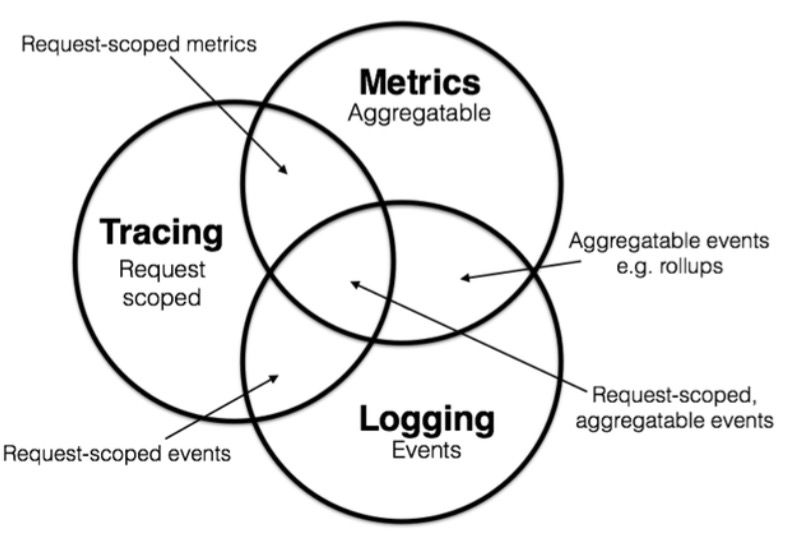
大盘应标记升压、配置变更、故障与停止发压的时点。延迟、流量、错误和饱和是 Google SRE 建议的四类信号。每种信号都要能落到对应边界。均匀的集群 CPU 会掩盖单个分区或单个租户饱和,应按实例、可用区、路由和分区查看偏斜。请求 ID、订单 ID 和运行编号留在日志、追踪与对账数据里,指标标签使用有限枚举,避免每笔订单创建新的时间序列。Google SRE,Monitoring Distributed Systems
用户体验和容量都依赖成功样本数,分位数要和分母一起展示。用 Prometheus 经典直方图时,跨实例先聚合桶再求分位数。以下的指标名是示例,假定实例使用一致的桶边界,耗时单位为秒,范围向量需要按采集间隔和窗口调整。
1 | |
le 是经典直方图的桶上界,合并时必须保留。先对原计数器调用 rate 可以处理各实例的计数重置。所得 p99 在桶内插值,精度与桶配置有关。直接平均各实例的 p99 会把分位数当成可加的量。若验收关心 2 秒门槛,应在业务完成直方图设置对应桶,或用明确计数记录及时完成。Prometheus 桶值不能自己回答超时后迟到的逻辑订单怎样归属,业务分母仍需按批次确定。Prometheus 直方图 · Prometheus 查询函数
用对照试验验证瓶颈假设
假设 60 秒内每秒有 80 条事件进入队列,稳定只完成 68 条,积压约增 720。对这个现象,可以沿证据逐步排查。
- 对齐发布确认、broker 入队、处理成功和业务终态。确认是否有重复投递、失败重试及未推进的分区。比如 RabbitMQ 的 publisher confirms 和 consumer acknowledgements 是两套独立机制,前者不能代表消费成功。RabbitMQ acknowledgements and confirms
- 查消费者忙碌时间、数据库连接等待及锁。若单个热门 SKU 对应分区的最老消息年龄持续上升,其他分区不涨,要同时看分区流量和库存行等待,从最早发生变化的等待点提假设。
- 在隔离环境保持订单总量、应用版本和存储配置,只改变热点分布以检验一个假设。记录积压斜率、每分区完成量和锁等待是否一起变化。再用相同热点做二次实验,例如改变库存事务持锁时间,区分分区并行度和热行的影响。
若只加消费者,有效吞吐可能不变,数据库连接等待却上升。在确认新增实例实际分得工作后,这轮结果会削弱「消费者实例总数是唯一约束」的假设。继续查共享下游或串行分区。若队列在升压后先涨、锁等待在随后才变,再查最初的入口偏斜和已有事务,用对照试验验证从时间序列中得到的线索。
一页归因记录应能重放
归因记录保存运行编号、负载阶段、观察窗、假设、改动的一处变量和两轮结果。旧文的 JVM、DB、MQ、缓存、搜索监控清单适合用来找候选资源。能检验因果的最小对照,才让一组旁路指标变成可行动的瓶颈结论。压力测试需要关注的注意事项
系列导航
| 上一篇 | 系列目录 | 下一篇 |
|---|---|---|
| 升压、稳压、过载和恢复 | 深入压测 | 怎样签出可复验的容量结论 |