
git 难点知识汇总
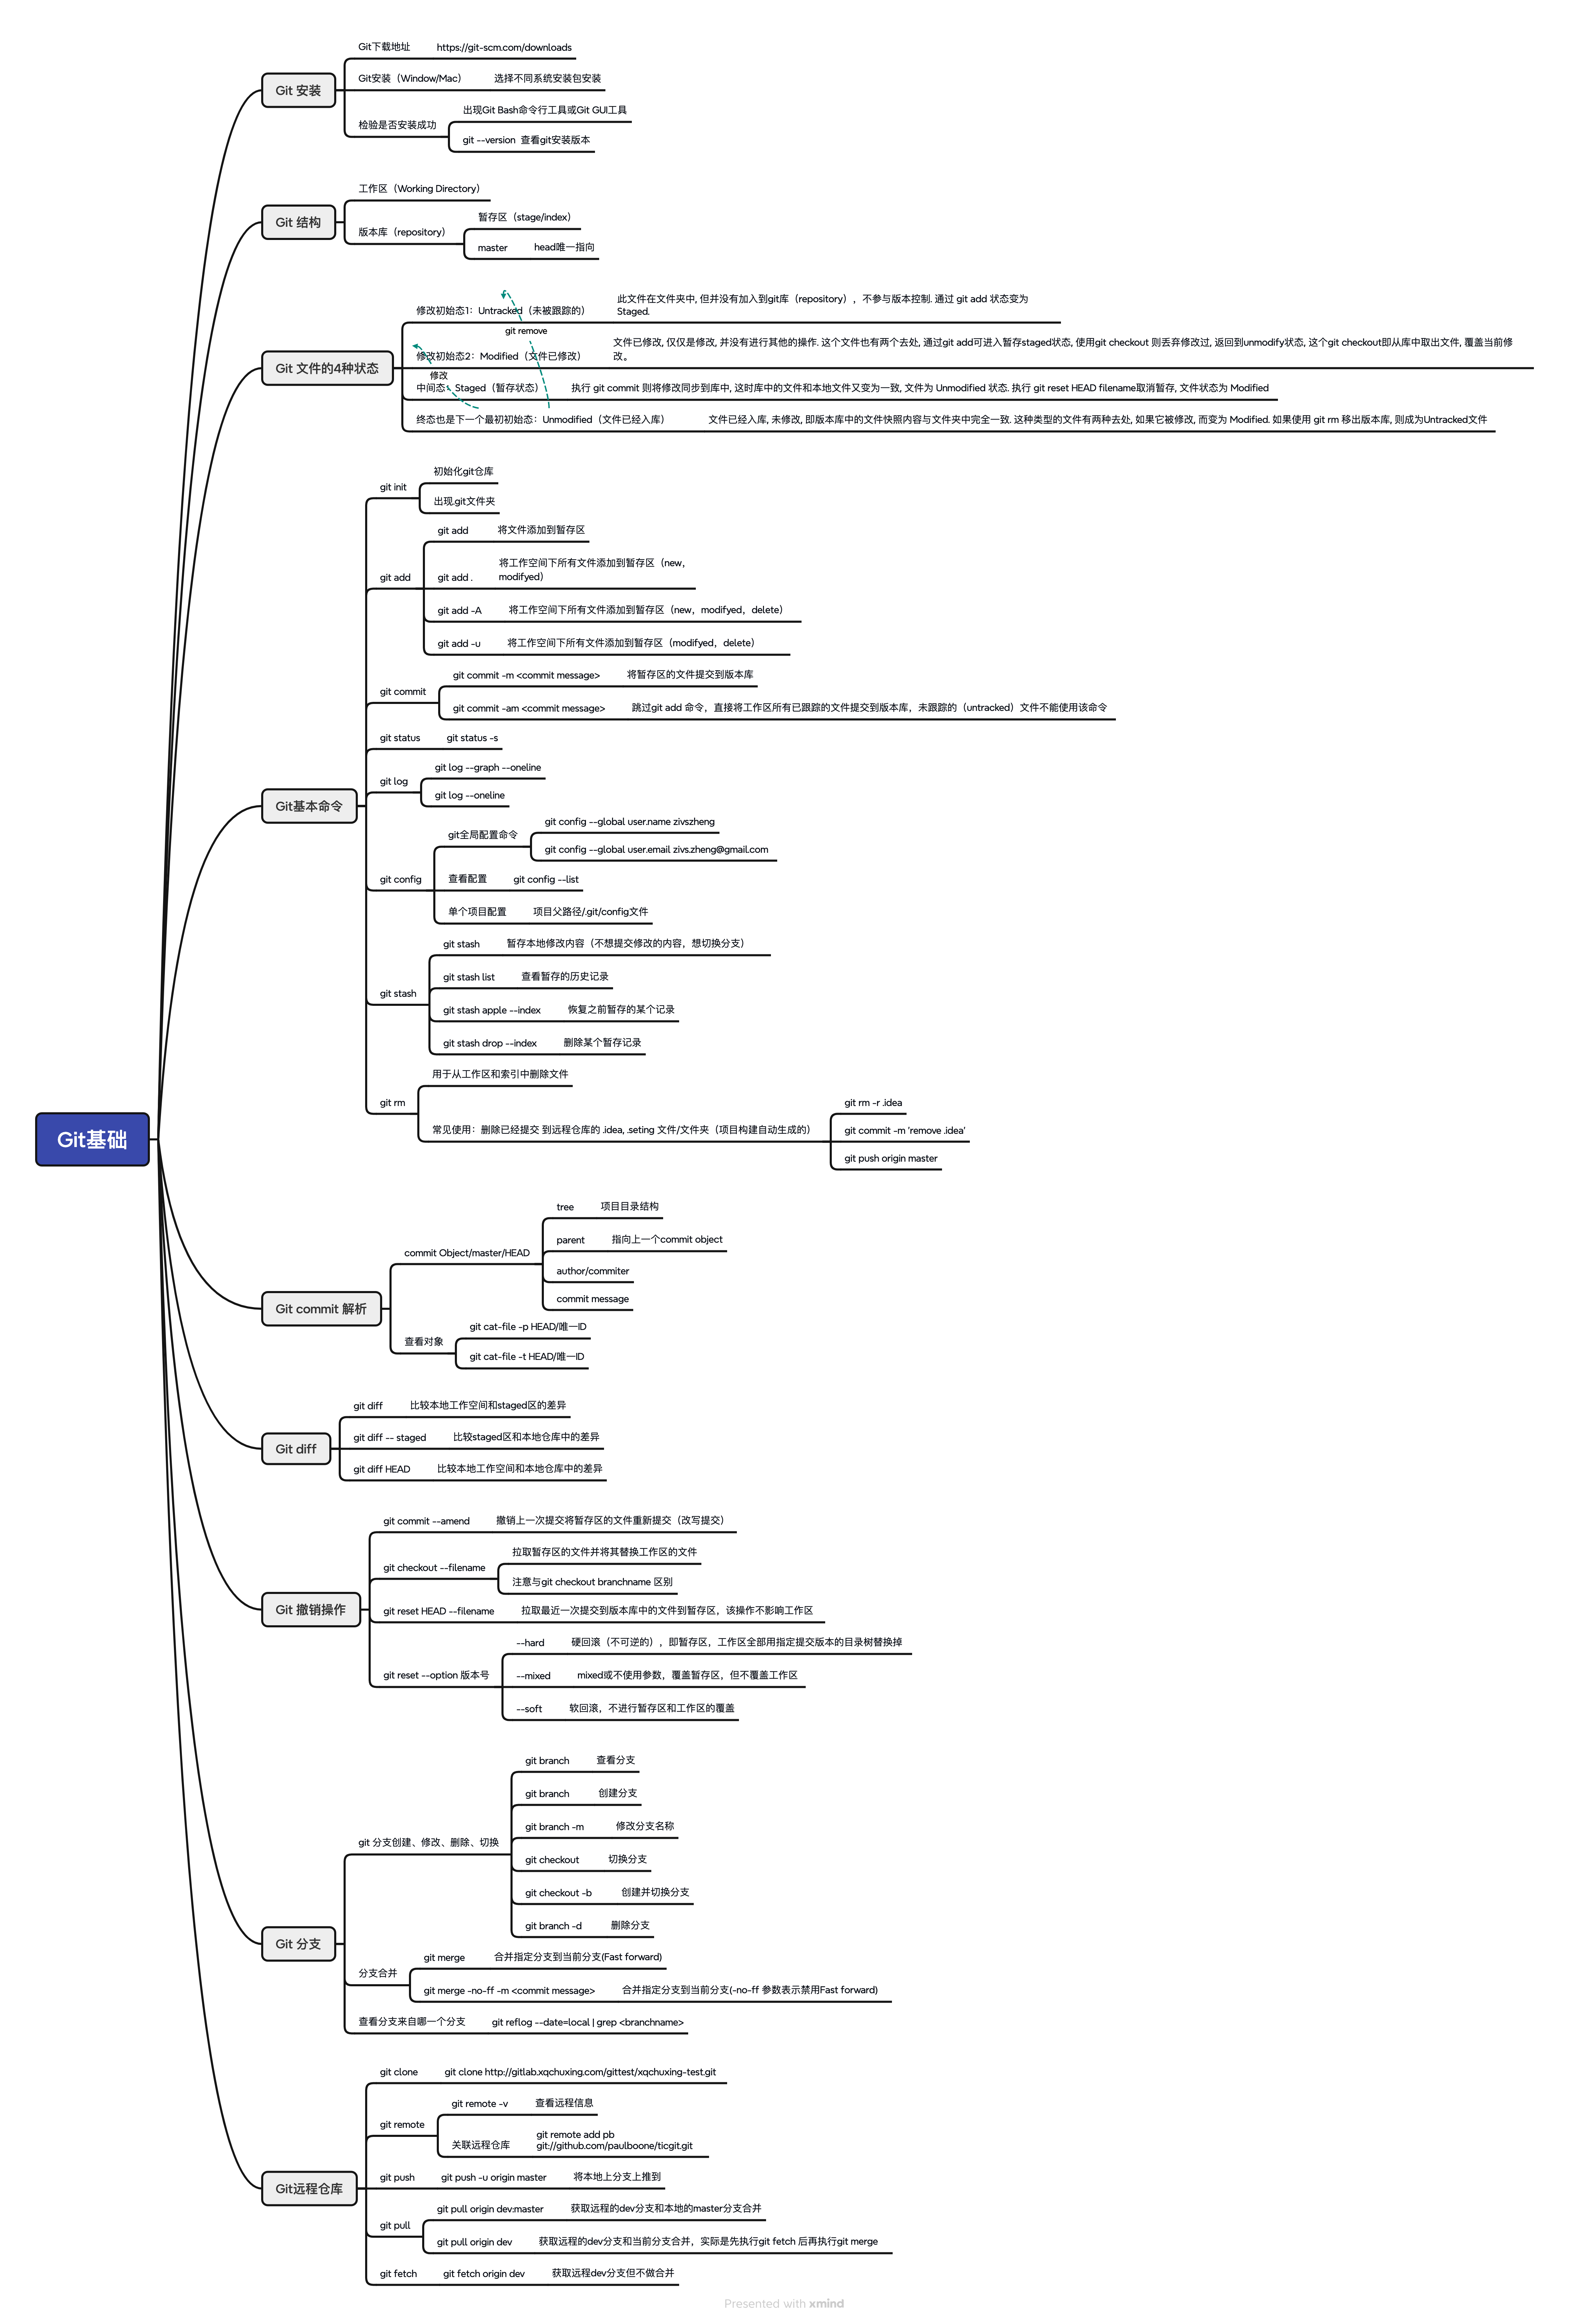
初始化命令
配置用户、remote 和 branch
1 | |
凭空产生空的 git repo
1 | |
变换remote repo
1 | |
把已经存在的 repo push 上 remote
1 | |
areas
-
已修改表示修改了文件,但还没保存到数据库中。
-
已暂存表示对一个已修改文件的当前版本做了标记,使之包含在下次提交的快照中。
-
已提交表示数据已经安全地保存在本地数据库中。
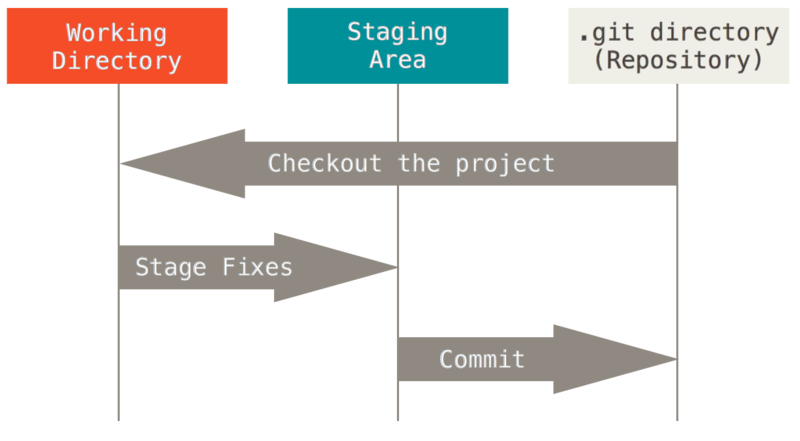
staging area 也叫 index。add 就是把文件 index/staging 的过程。git 里经常混用 index 这个单词。
工作目录是实际编辑文件的目录;索引和对象数据库通常存放在 .git 下,linked worktree 则有独立索引和共享对象库。普通完整 clone 获取所选引用可达的历史,不保证复制远端未公开引用、不可达对象、reflog、hooks 或服务端配置;浅克隆和部分克隆还会进一步限制历史或对象。git 在概念模型上是 snapshot-based(基于快照)的版本控制系统,而不是像 SVN 那样 delta-based(基于差异)的版本控制系统——每次提交都保存项目所有文件的完整快照(Pro Git §1.3 Getting Started - What is Git?)。但在底层存储优化上,Git 会通过 packfiles 使用 delta compression 来节省磁盘空间(Pro Git §10.4 Git Internals - Packfiles),在实际使用过程中也相当轻量级。
文件状态与存储区域是两组概念。文件可以处于 untracked、unmodified、modified 或 staged 状态;同一已跟踪文件也可以同时有已暂存和未暂存的修改:
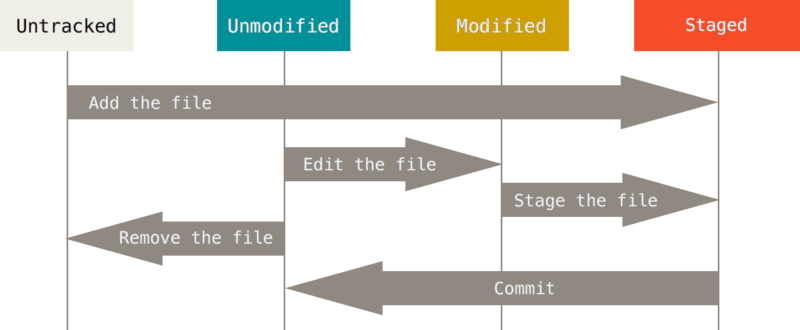
Working Directory = Working Tree,指当前检出的文件系统目录,其中包含未跟踪、已跟踪、已修改或未修改的项目文件。
- Untracked files:尚未进入索引、未被当前版本跟踪的文件。匹配忽略规则的未跟踪文件默认不出现在 status 中;忽略规则不会让已跟踪文件停止跟踪。
- Tracked files:当前索引中的文件,以及 HEAD 中有记录、正在暂存删除的文件。仅存在于旧历史中的文件不一定仍被当前版本跟踪。
Git 与 CVS、SVN、Perforce 的协作模型
Git 和 CVS、Subversion、Perforce 的差别主要落在三个方面:历史存在哪里,分支怎样表示,以及冲突由谁在什么时候处理。是否支持分支、是否使用文件锁,并不能直接划出分布式与集中式版本控制的边界。
集中式版本控制常见的工作方式,是让团队围绕中央仓库中的 trunk 开发。每个人从 trunk 取出工作副本,修改后再把变更提交回中央仓库。工作副本只是文件和元数据的本地视图,不等于一个分支;把目录 checkout 到本地,也不会自动创建一条新的提交历史。SVN 和 CVS 都支持分支。SVN 的分支通常是仓库中的目录复制,CVS 用分支标签和分支修订号表示。它们创建、切换、合并分支以及管理权限的成本与 Git 不同,因此不少团队选择少建分支、围绕 trunk 集成。
Perforce 默认允许并发开发。无法可靠合并的二进制文件、设计文件或特定目录,可以通过文件类型 +l 或服务器策略启用独占打开。SVN 默认采用 copy-modify-merge,svn lock 是针对特定文件的额外机制,常用于不能合并的文件。CVS、SVN、Perforce 的具体命令和策略不同,但集中式版本控制并不要求所有 checkout 都加锁。参见 Git 关于集中式与分布式版本控制的说明、SVN 的 copy-modify-merge 与 locking、Perforce 的独占打开。
三个正交维度
| 维度 | Git | CVS / SVN | Perforce |
|---|---|---|---|
| 仓库位置 | clone 通常包含本地历史和对象,可离线提交 | 中央仓库保存主历史,工作副本主要保存当前检出内容 | 中央 depot 保存主历史,workspace 保存本地视图和打开状态 |
| 日常提交 | 先 commit 到本地,再 push 到远端;push 时检查远端引用是否仍是祖先 |
修改工作副本后直接 commit 到中央仓库 |
p4 edit 标记文件后修改,p4 submit 提交到 depot |
| 分支含义 | 分支是指向提交的可变引用,创建和切换很轻量 | 分支存在,但常以仓库复制、路径或标签表达,合并与权限流程更重 | 分支、stream 和 workspace 由中央服务管理,成本取决于 depot 与团队策略 |
| 冲突处理 | 本地分支之间 merge/rebase;远端拒绝覆盖非快进历史 | 中央提交时发现新版本,按工具规则更新并合并;文本通常可并行修改 | submit/integrate 时按 depot 状态整合;不可合并文件可启用独占打开 |
| 锁的范围 | 本地 index.lock 只保护一次索引写入;远端仍有引用更新的原子检查 |
svn lock 是特定文件的显式锁,不是所有 checkout 的必需步骤 |
+l 或服务器策略才对特定文件启用独占打开 |
三类动作分属两条不同的线:
1 | |
分支回答“这组提交属于哪条历史线”,锁回答“此刻谁可以写这个资源”。两者可以独立出现。Git LFS 的文件锁定、SVN 的不可合并文件和 Perforce 的 +l 文件,都可能在 trunk 工作流中需要独占写入。
两种典型工作流
集中式 trunk 工作流通常是:
1 | |
这里 checkout 或 update 取得的是某个版本的工作副本,不是在两个分支之间同步。多人同时修改同一个可合并文本文件时,后提交者通常需要先 update、merge 再提交;只有文件类型或服务器策略要求独占时,才会在编辑前取得锁。
Git 的常见分支工作流是:
1 | |
Git 把提交、分支和合并的大部分操作放到本地,因此可以频繁创建短命分支、离线提交,再选择合适的时机集成。远端仍然是协作边界:两个开发者同时 push 同一远端分支时,后一个 push 不会静默覆盖前一个 push,通常需要先 fetch 并整合。
容易混淆的四个词
- 工作副本 / working copy:某个集中式仓库版本在本地的文件视图,可能包含本地修改,但本身不是分支。
- Git branch:指向某个提交的可变引用;提交仍保存在对象图中,分支只是给这条历史线提供一个会移动的名字。
- checkout / update:把指定版本或引用的内容取到工作区;它描述的是工作区同步,不自动表示“创建分支”。
- lock:限制某个资源的并发写入;它解决的是同时编辑不可合并资源的问题,不负责表达提交历史。
不少集中式团队确实长期围绕 trunk 和本地工作副本开发,但这是团队采用的流程,不是工具本身没有分支。锁也只在文件无法可靠合并或服务器策略要求独占时才有必要;文本文件通常先并发修改,再在提交或集成时合并。Git 的轻量分支和本地历史降低了分支协作的成本,并发问题仍会在 merge、push 和索引更新时出现。
下图将文件内容的复制与引用的移动分开表示。比如 restore --staged 默认从 HEAD 恢复索引,不会把索引内容写入工作目录。

git worktree 可以在同一个 Git 仓库中创建多个工作树。每个工作树独立检出不同的分支或提交,适合并行处理多个分支,避免频繁切换。
分支
本节内容主要参考 Pro Git §3.1 Git Branching - Branches in a Nutshell。
提交通过父提交引用构成有向无环图(DAG),合并提交可以有多个父提交。分支是指向某个提交的可变引用,不是独立的链表。通常 HEAD 是指向当前分支的符号引用,因此通过分支间接定位当前提交。
创建新分支并不会切换分支,HEAD 仍指向当前分支。
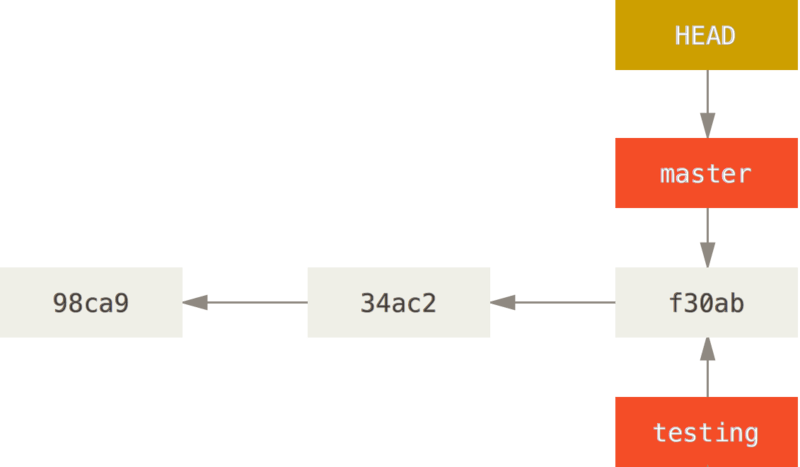
但切换分支后 HEAD 指向的是新分支了。
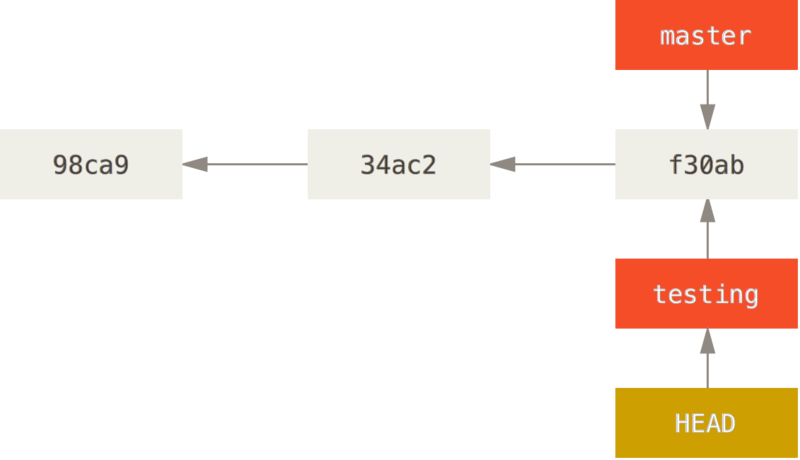
HEAD 表示当前检出位置。正常提交会移动 HEAD 所指向的分支;在 detached HEAD 状态下,HEAD 直接指向提交,提交只推进 HEAD,不会自动创建分支。
修改提交
查看历史
普通的历史
用git log可以查看提交历史,以便确定要回退到哪个版本。
只有本地才能看到的历史
git reflog 记录本地引用的移动历史,可以据此找回 reset、rebase 或 checkout 之前的位置。
输出是一系列按时间排列的位置,如 HEAD@{0}、HEAD@{1},并标注 checkout、rebase、commit 等操作。
Git Tools - Revision Selection 说明了如何使用 log 和 reflog 查询一个或多个分支在不同区间内的提交记录。
1 | |
Pro Git 用 shell 历史记录类比 reflog:
将引用日志想作 Git 版的 shell 历史记录
如果你有 UNIX 或者 Linux 的背景,不妨将引用日志想作 Git 版的 shell 历史记录, 重点在于仅与你和你的会话相关,而与他人无关。
reflog 不会随 push 传到远端,只保存在本地仓库。它记录引用的移动,而 git log 遍历提交历史,因此 reflog 能帮助找回 reset 或 rebase 后不再被分支引用的提交。
另一种双点
b7ba61b5..ecee4f91 main -> origin/main
git pull让 main 从 b7ba61b5 进展到 ecee4f91,而这一更新来自 origin/main。
reset
本节内容主要参考 Pro Git §7.7 Git Tools - Reset Demystified。
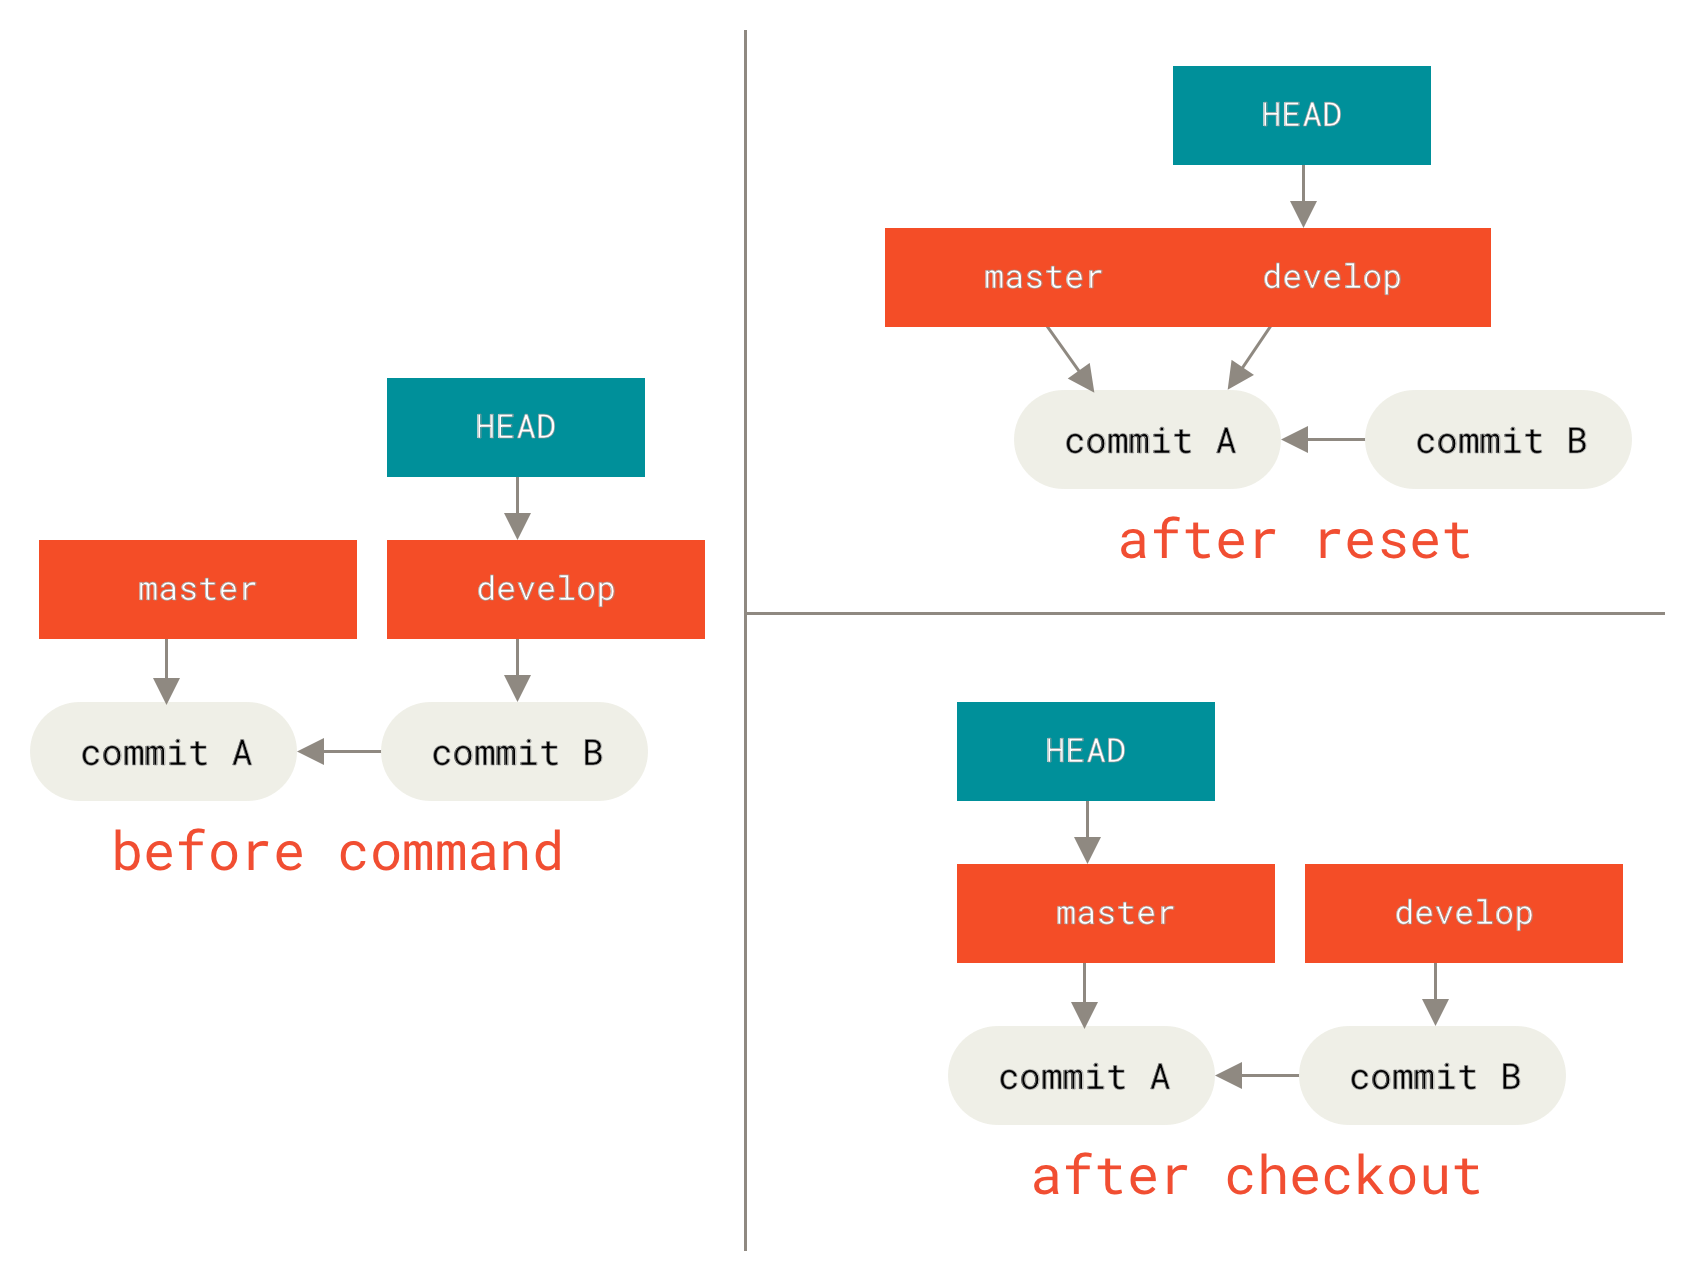
不带路径的 git reset <mode> <commit> 将当前分支移到目标提交;detached HEAD 下只移动 HEAD。带路径的 git reset <commit> -- file.txt 则只恢复对应索引条目,不移动 HEAD 或分支。
| 模式 | 引用 | 索引 | 工作目录 |
|---|---|---|---|
--soft |
移到目标提交 | 保留原状 | 保留原状 |
--mixed(默认) |
移到目标提交 | 恢复为目标快照 | 保留原状 |
--hard |
移到目标提交 | 恢复为目标快照 | 恢复已跟踪内容,丢弃相关本地修改 |
--keep |
检查通过后移到目标提交 | 重置 | 更新目标与原 HEAD 间变化的文件;若会覆盖这些文件的本地修改则中止 |
--soft 不会执行 add,只保留原有索引。若执行前索引与 HEAD 一致,git reset --soft HEAD~2 后再次 commit 可以合并最近两次提交;原先已有的暂存修改也会进入新提交。
--mixed 保留工作目录,并把索引恢复到目标快照。例如取消一个文件的暂存:
1 | |
--hard 可丢弃尚未提交的已跟踪文件修改,也可能删除阻挡目标文件写入的未跟踪文件或目录,但不会清理所有未跟踪文件。git reset --hard HEAD~ 会回退当前分支并丢弃相关本地修改;撤销已共享的提交通常应使用 revert。

这些模式的区别在于更新哪些状态,不是简单的“回退程度”。索引始终是下一次提交的候选快照,不是提交历史的另一份列表。详见 git reset 官方文档。
强制对齐远程分支
确认当前分支就是要重置的分支,保存需要保留的修改,并先 fetch 更新远程跟踪引用:
1 | |
reset 对齐的是已跟踪内容;clean 删除未跟踪内容,默认保留被忽略文件,两者用途不同。
checkout
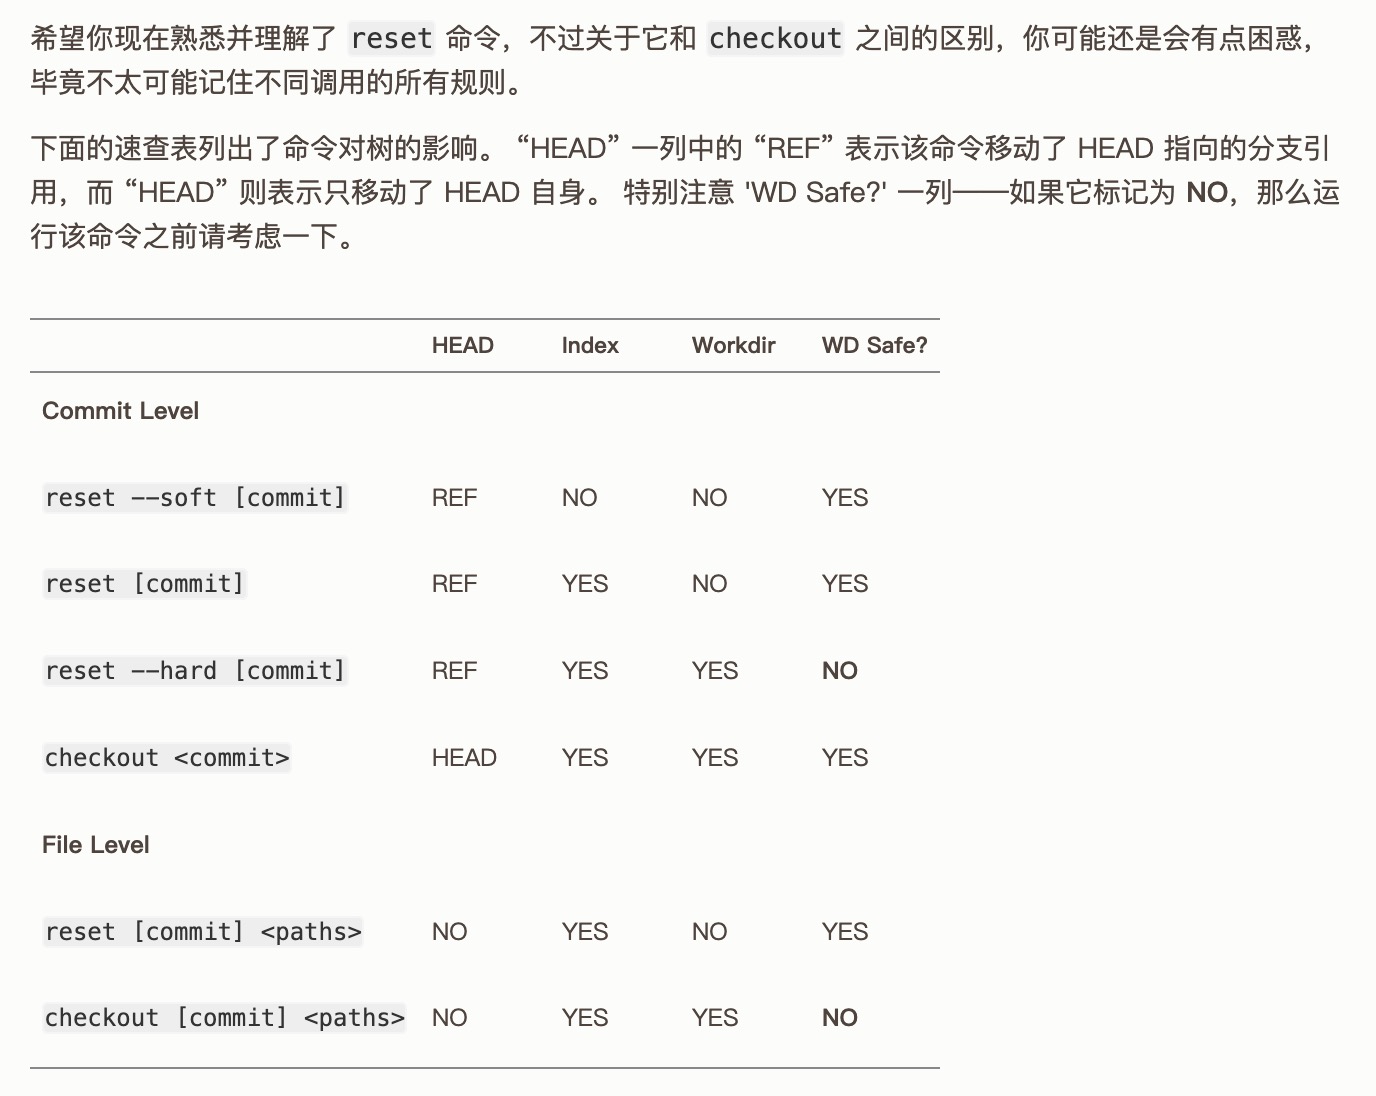
checkout 既能切换分支或提交,也能恢复文件。查看差异用 git diff(工作目录对索引)、git diff --cached(索引对 HEAD)或 git diff HEAD(工作目录对 HEAD)。
对分支和提交
git checkout feature 使 HEAD 指向 feature,通常不移动任何分支引用。可兼容的本地修改会保留;如果切换会覆盖修改,Git 通常拒绝操作。--force 会放弃这层保护。
按提交 ID 检出会进入 detached HEAD,即使该提交恰好也是某个分支的顶端。detached HEAD 可以用于检查旧版本,也可以产生提交;要长期保留这些提交,应创建分支:
1 | |

分支创建后,提交就有了稳定引用。reflog 可帮助找回最近离开的提交,但会过期,不能替代长期保留的分支。
对文件
不指定来源时,git checkout -- file 从索引恢复工作目录。指定提交时,git checkout <commit> -- file 同时更新索引和工作目录。两者都不移动 HEAD,都可能覆盖对应文件的本地修改。
1 | |
revert
1 | |
产生一个反 commit。这样可以提交反操作,而不丢失正操作的 commit。这样做的好处是,commit 历史是 append only 的,不会被修改。
在这里要重新解释三个区域:
| 区域 | 用途 |
|---|---|
| HEAD | 当前检出位置:通常是指向 refs/heads/ 下分支的符号引用,detached 时直接指向提交。 |
| Index(staging area) | 扁平文件:预期的下一次提交的快照,生成树对象的源泉,write-tree从这里把变更生成树对象,commit-tree 再(不从这里)把树对象提交成 commit 对象。有人把这个地方叫 index tree(不如 working tree 流行),这个叫法似乎是错的 |
| Working Directory(WD) | 沙盒,平凡文件系统。有些文献把这个地方叫 working tree |
git status 在干净状态下仍会显示分支和 working tree clean 等信息;git status --porcelain 无输出表示在其检查范围内没有需要报告的变更,忽略文件默认不报告。
撤销合并提交时,-m 指定用哪个父提交作为计算逆向补丁的基准:
git revert -m 1 HEAD
[master b1d8379] Revert “Merge branch ‘topic’”
-m 1 指定父节点 1 为主线。执行 git merge topic 后,合并提交有两个父节点:第一个是原 HEAD(C6),第二个是被合入分支的顶端(C4)。revert 会撤销相对父节点 1 由父节点 2 引入的修改。
1 是指 #1
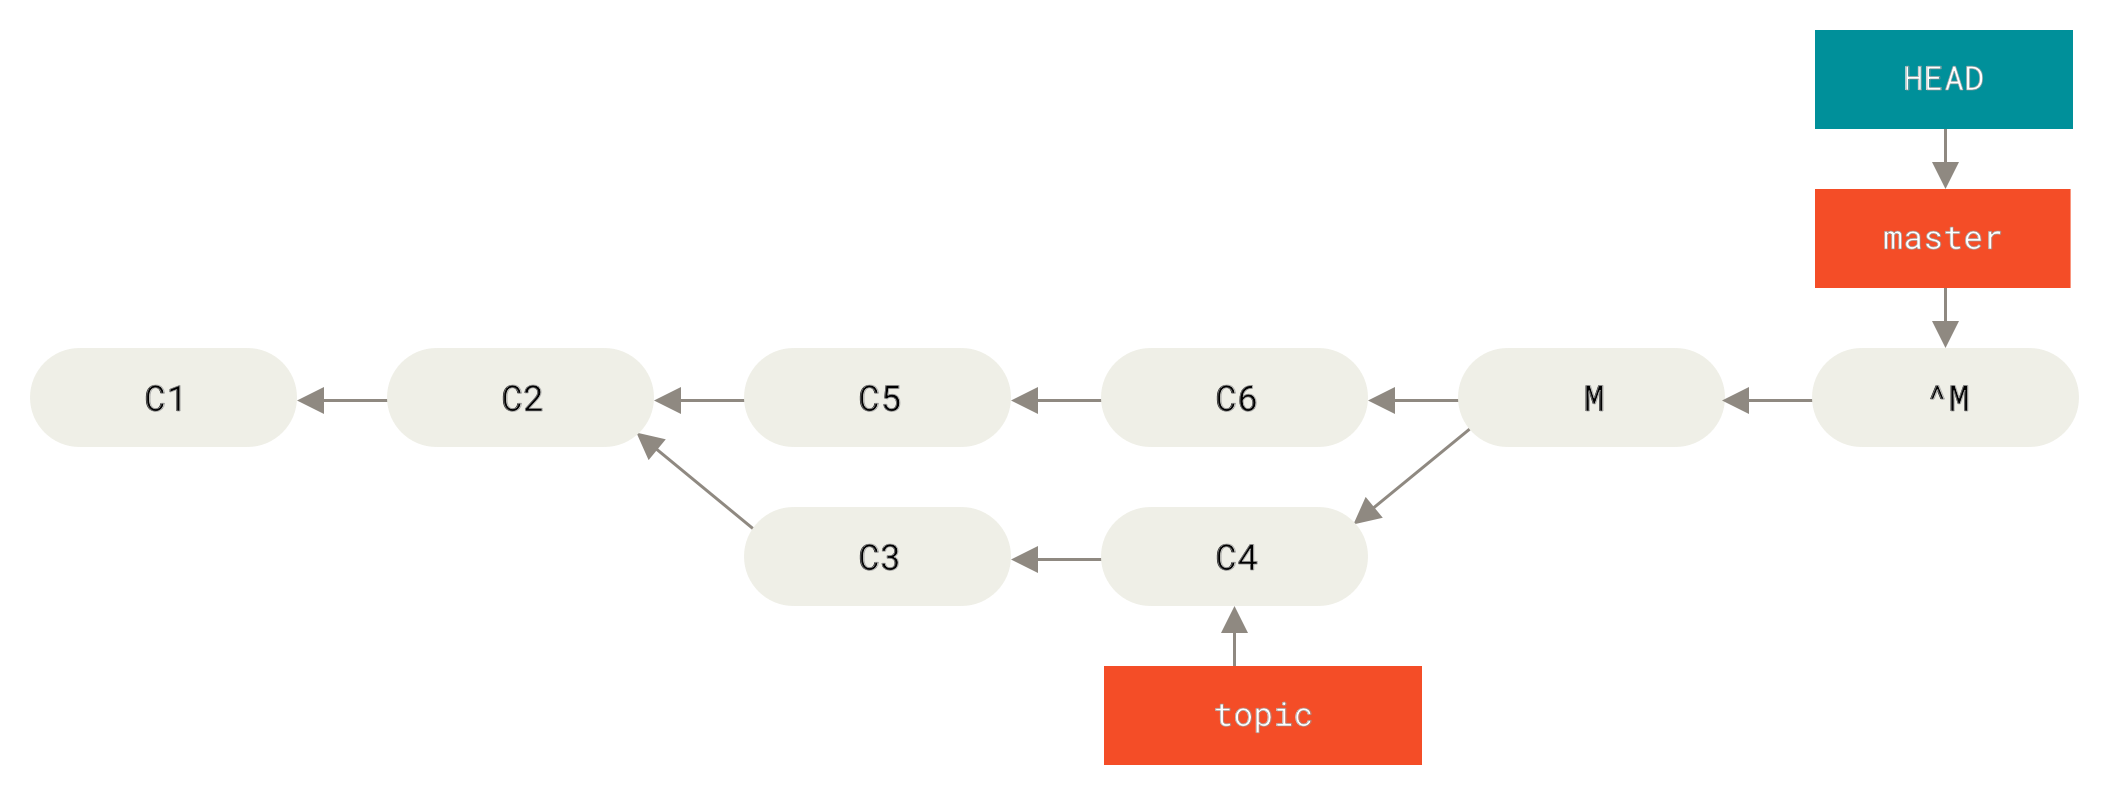
如果合并后没有其他修改,撤销合并得到的树可以与第一父提交 C6 相同,但原合并提交仍在祖先历史中。topic 没有新提交时,再次 merge 会显示 Already up-to-date;有新提交时也只合入新部分,不会自动恢复已撤销的旧改动。

需要恢复整组改动时,可以在确认内容仍适用后撤销先前的 revert 提交,再合入后续修复。详见 git revert 官方文档。
amend
amend 会用新的 commit2 替换原来的 commit1;提交信息、文件快照或两者都可能变化:
1 | |
restore
对于误删除的文件:
1 | |
主要命令
merge
merge 将指定提交的历史合入当前分支。多个参数表示多个待合并的头,不是“源分支、目标分支”。
要把 master 的代码合并入 feature。
1 | |
同一个起点上,merge 保留两侧祖先关系,rebase 重放选定提交,squash 生成单父提交,cherry-pick 复制选定补丁。带撇号的节点表示新的提交对象。

非快进合并
两侧历史分歧时,普通 merge 会创建合并提交。若有冲突,需要先修改冲突文件并暂存,再完成提交。团队可以要求 feature 先整合目标分支并通过测试,但目标分支随后继续变化时,最终合并仍可能产生冲突。
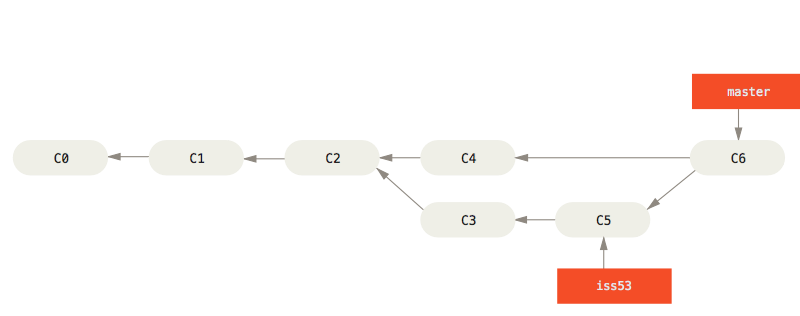
这种非快进合并按照 mergify 的说法,应该也叫做 three-way merges(the current main branch, your commits to be merged, and a common ancestor of the two)。
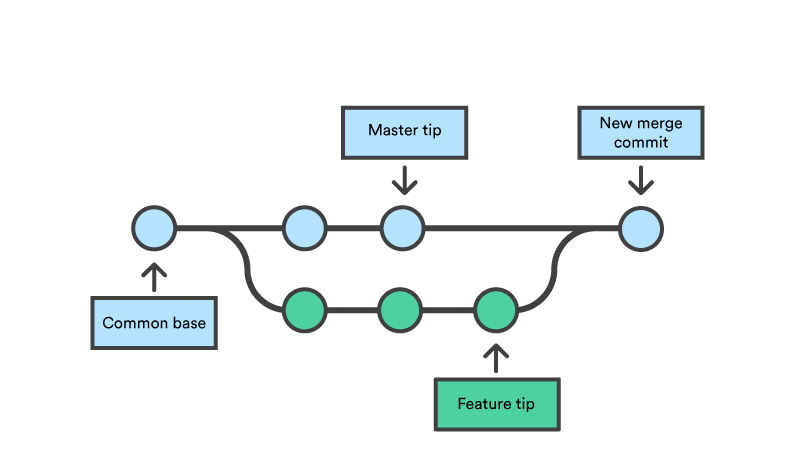
这里的 tip 是尖端的意思。
快进合并
快进合并即 Fast-forward merge,是一种特殊的合并方式,用于将一个分支的提交直接应用到另一个分支,而不会创建一个新的合并提交——效果类似 rebase。如分支 a 有c1c2c3提交,分支 b 有c1c2c3c4c5提交,checkout a 然后 merge b,就是把 a 指向 b。ff 只会发生在 a 是 b 的子集前提下,这样3-way就变成2-way。
快进合并后删除分支 b,历史中不会留下分支 b 曾经存在的结构,因为分支只是可移动引用。
配置快进
1 | |
- true(默认值):允许快进合并。
- false:禁止快进合并,总是创建一个新的合并提交。
- only:只允许快进合并,如果不能进行快进合并,则拒绝相应操作。
压缩合并
1 | |
rebase
本节内容主要参考 Pro Git §3.6 Git Branching - Rebasing。
本节最重要的标准流程是应该是 feature rebase onto master,然后 master merge from feature。
在 feature 上执行 git rebase master,会把选定的 feature 提交重放到 master 指定的位置,再移动 feature;master 本身不会因此移动。随后切换到 master 合并 feature,才更新 master。
变基的主流程是:
- 先找到共同祖先。
- 选择当前分支中需要在新基底上重放的提交。
- 在新基底上重放选定提交,并将当前分支移到重放后的顶端。
1 | |
rebase 的本质,顾名思义,是改变当前分支的 branch out 的位置。即,把当前 feature 整个移动到 master 的 ALIAS 之后(尽量不 branch out),即所谓的 rebase onto。
以下是最基础的分支演进过程:
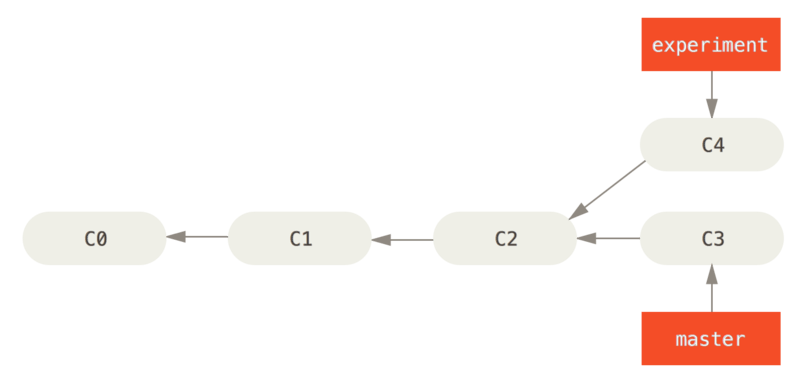
其中一种整合方式是 merge:
The easiest way to integrate the branches, as we’ve already covered, is the merge command.
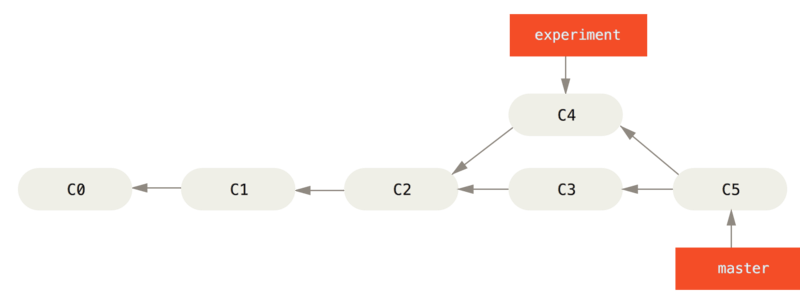
本例普通 rebase 将 experiment 的选定提交排到 master 之后。它不会消除仓库中的其他分支或已有合并结构;--rebase-merges 还会尝试重建所选范围内的合并拓扑。
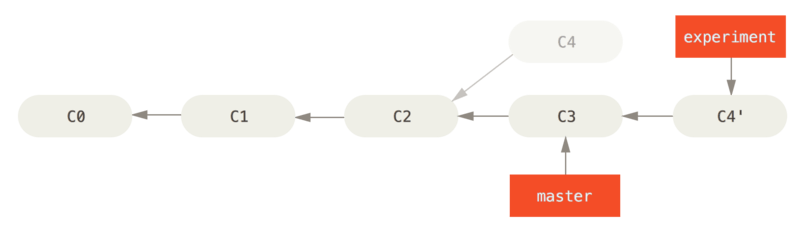
这里被变基的是 experiment。它把自己的提交重放到 master 之上,随后 master 可以快进合并 experiment;不应反过来让 master 变基到 experiment。
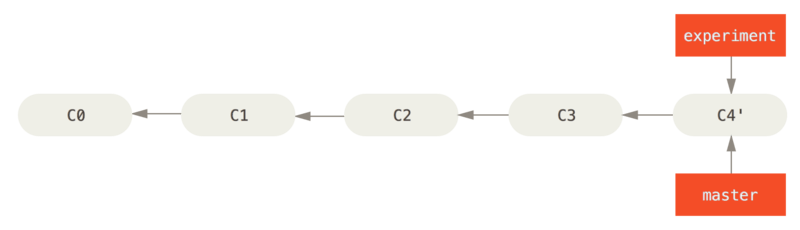
这个故事的完整操作是:
git checkout experiment
git rebase master
First, rewinding head to replay your work on top of it…
Applying: added staged command git
git checkout master
git merge experiment
rebase 会改写提交历史,适合尚未共享的实验分支。已经被他人作为开发基线的公共提交不应随意变基。
交互式变基 git rebase -i master 可以在共享前整理当前分支的提交。
强制推送会毁灭推送历史
如果 rebase 使远端分支顶端不再是本地顶端的祖先,普通 push 会因非快进更新被拒绝;这与文件内容是否冲突不同。--force 可请求非快进更新,但不能绕过服务端保护:
1 | |
该命令会让远端 master 匹配本地变基后的历史。其他成员若仍基于旧提交开发,就会同时看到内容相同但提交 ID 不同的两套历史。公共提交存在下游依赖时,不应执行这类强制更新。
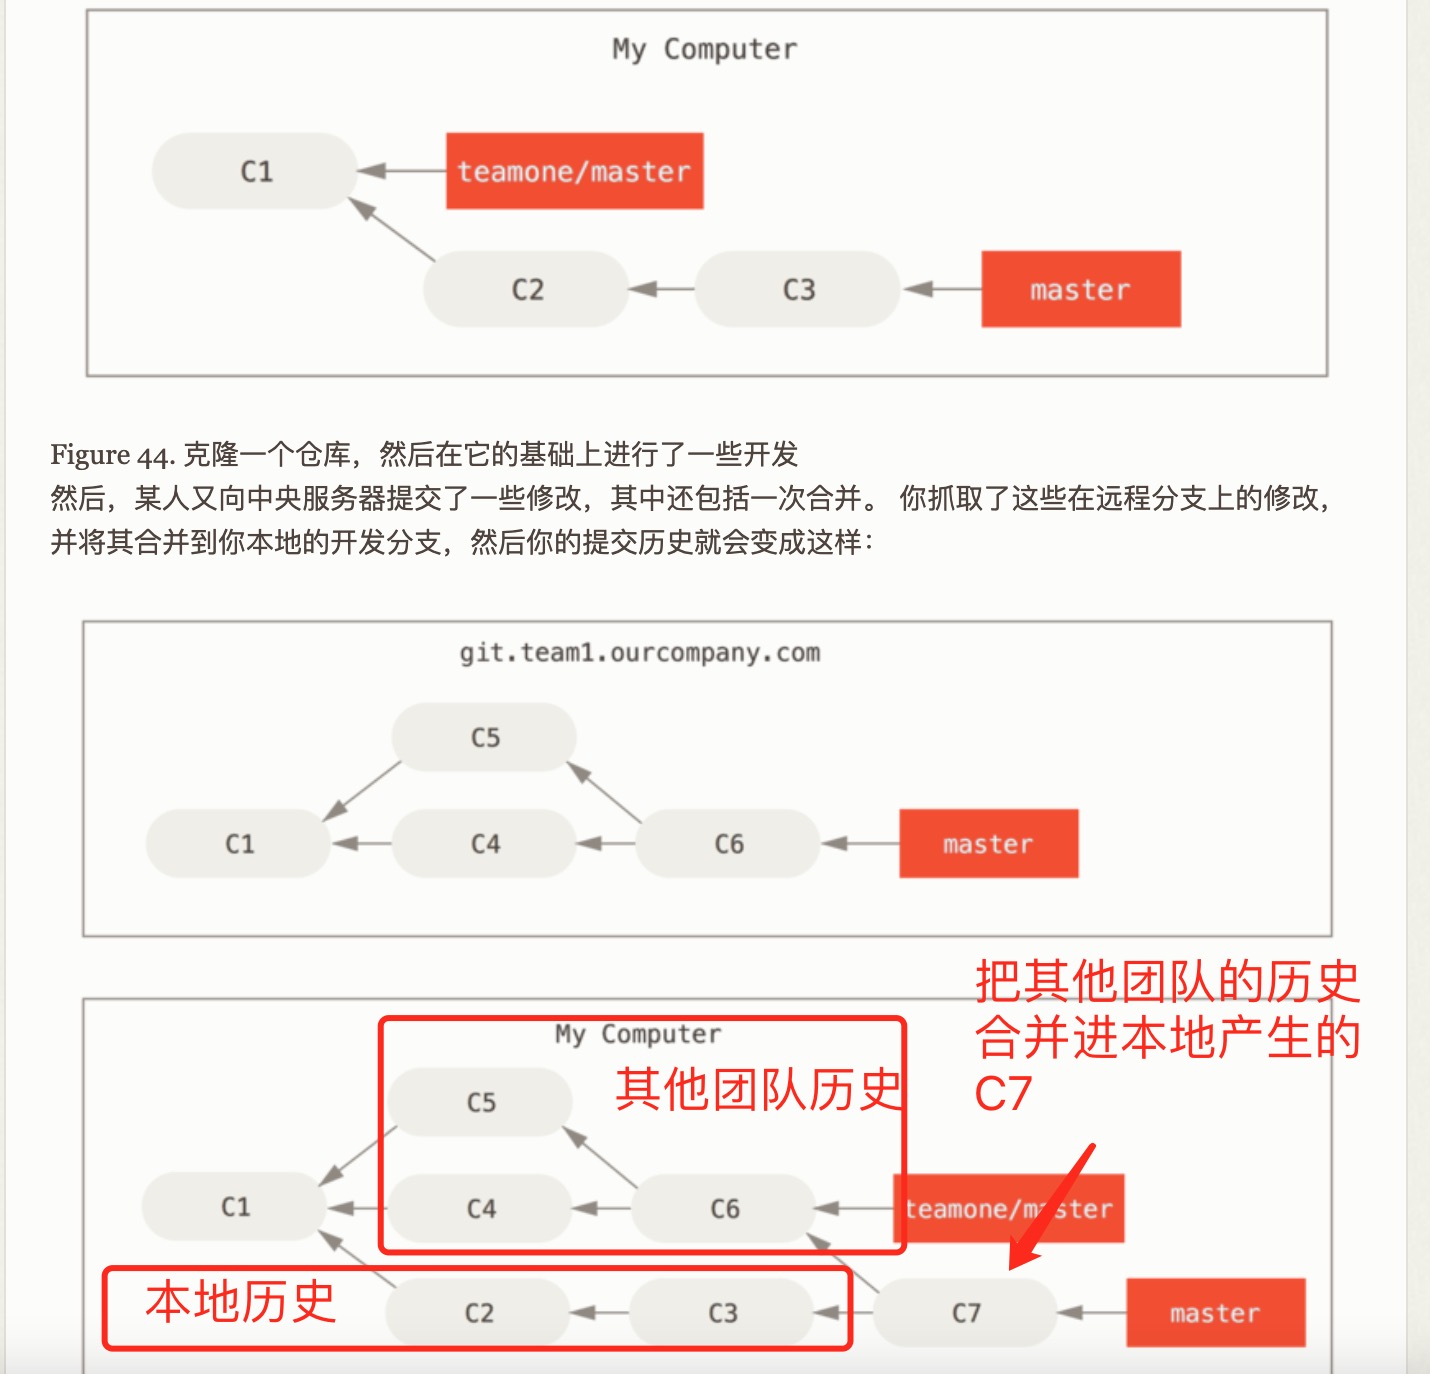
这时候 team1 rebase 丢弃一些分支,就会产生意想不到的后果。
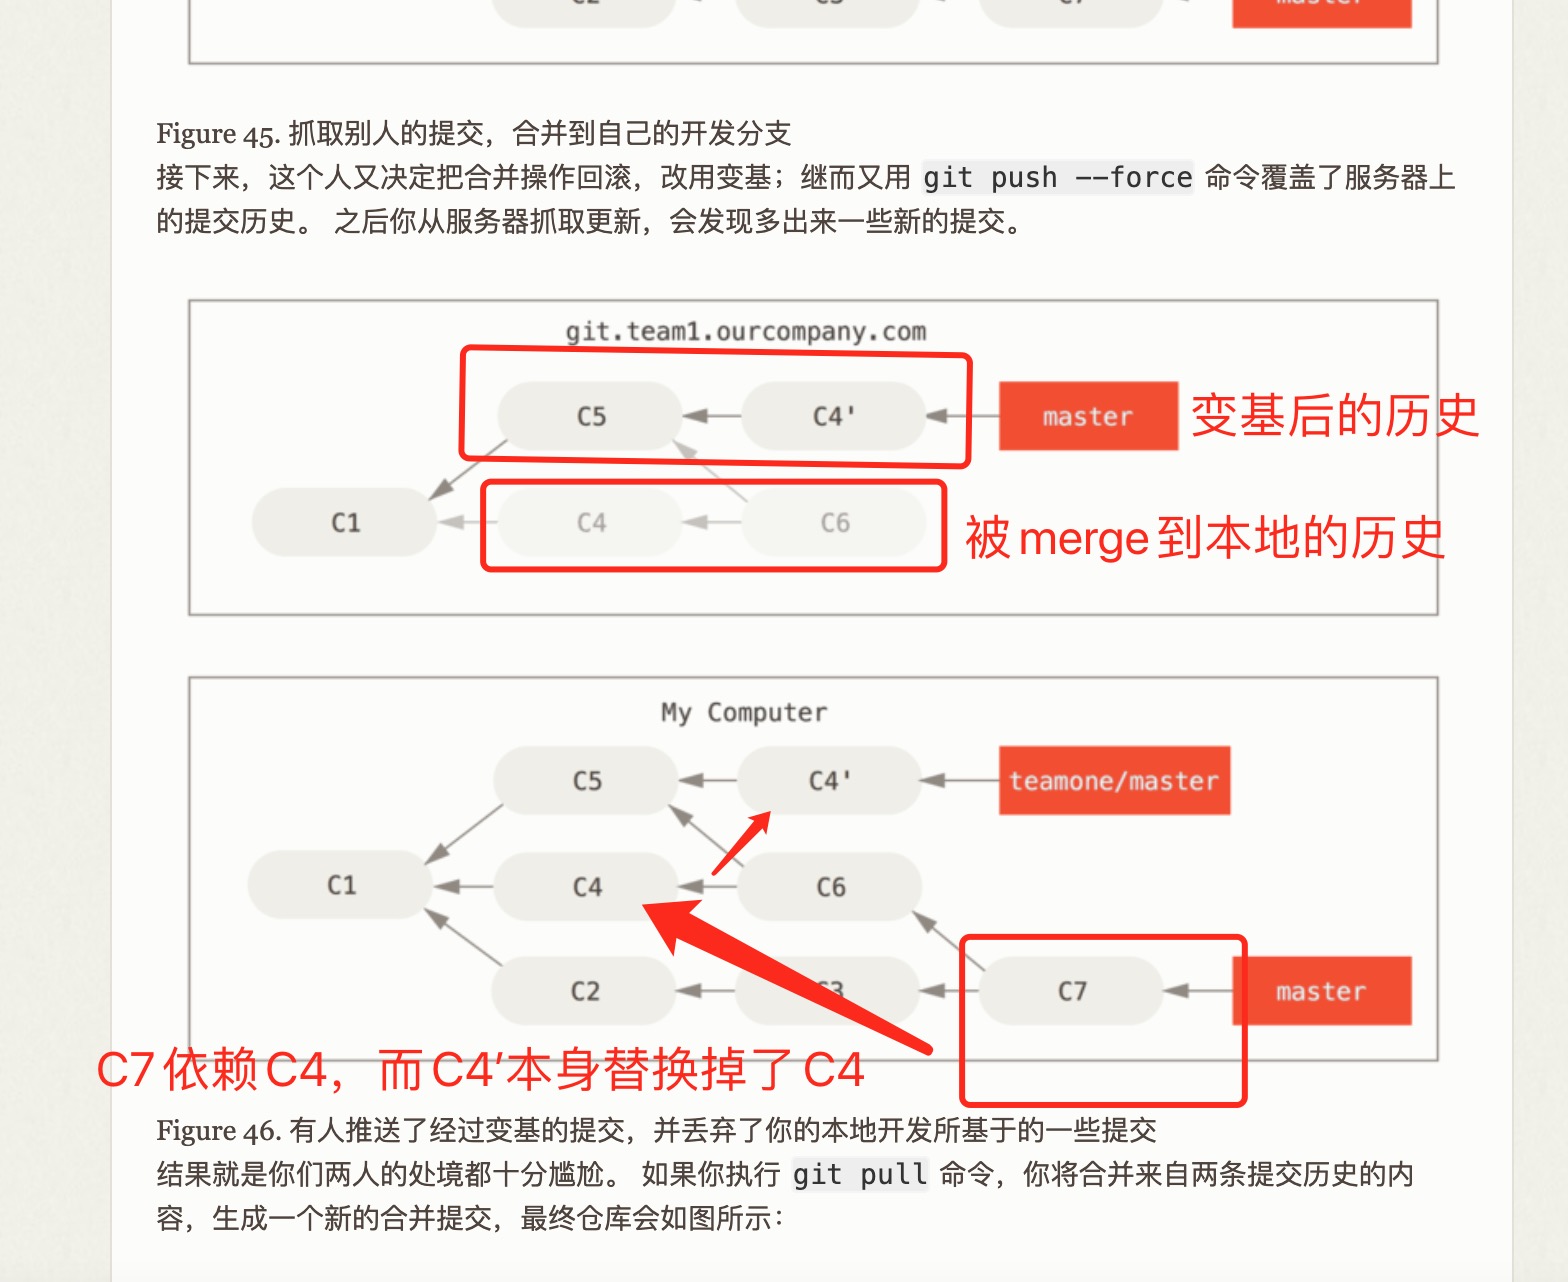
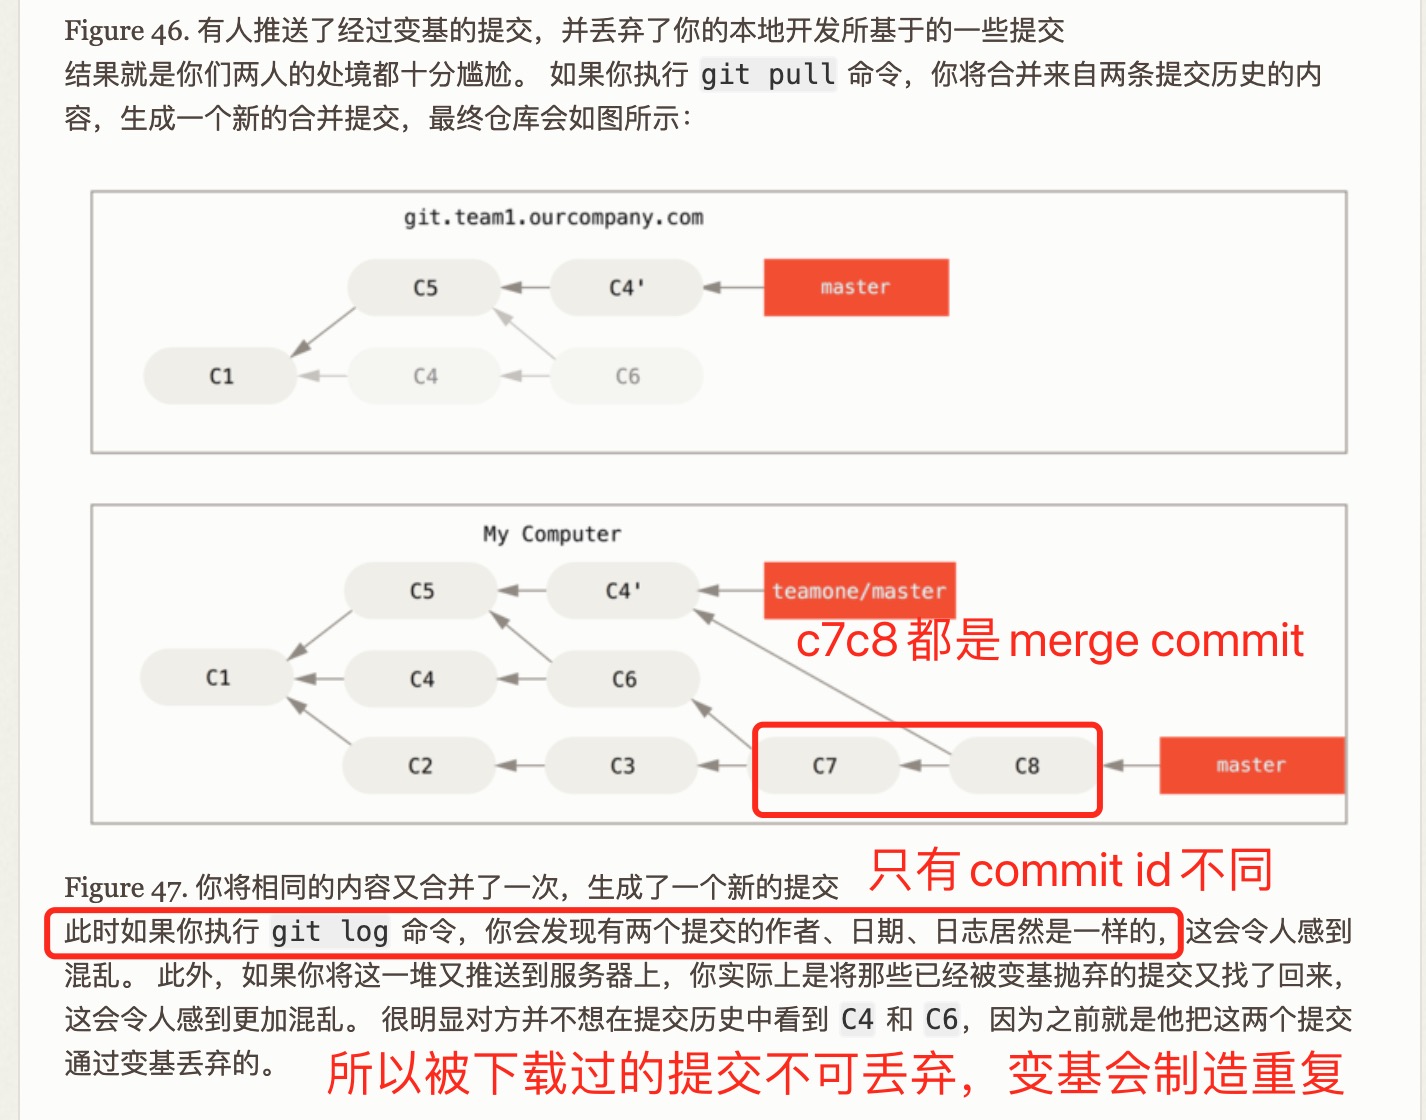
变基只能整理被变基分支及其后续集成历史,无法改写其他人此前已经拉取的分支。旧提交和新提交可能内容、作者、时间相同,但提交 ID 不同。
1 | |
上游重写历史后,rebase 可以在简单场景中识别等价补丁并跳过,但不能保证所有重复提交都会自动消除。上游 squash、修改或删除提交后,直接重放还可能重新引入已删除的改动。应先保存本地分支、确定旧上游边界,只重放本地新增提交;例如 git rebase --onto origin/master <old-upstream-tip> <local-branch>。参见 Recovering from upstream rebase。
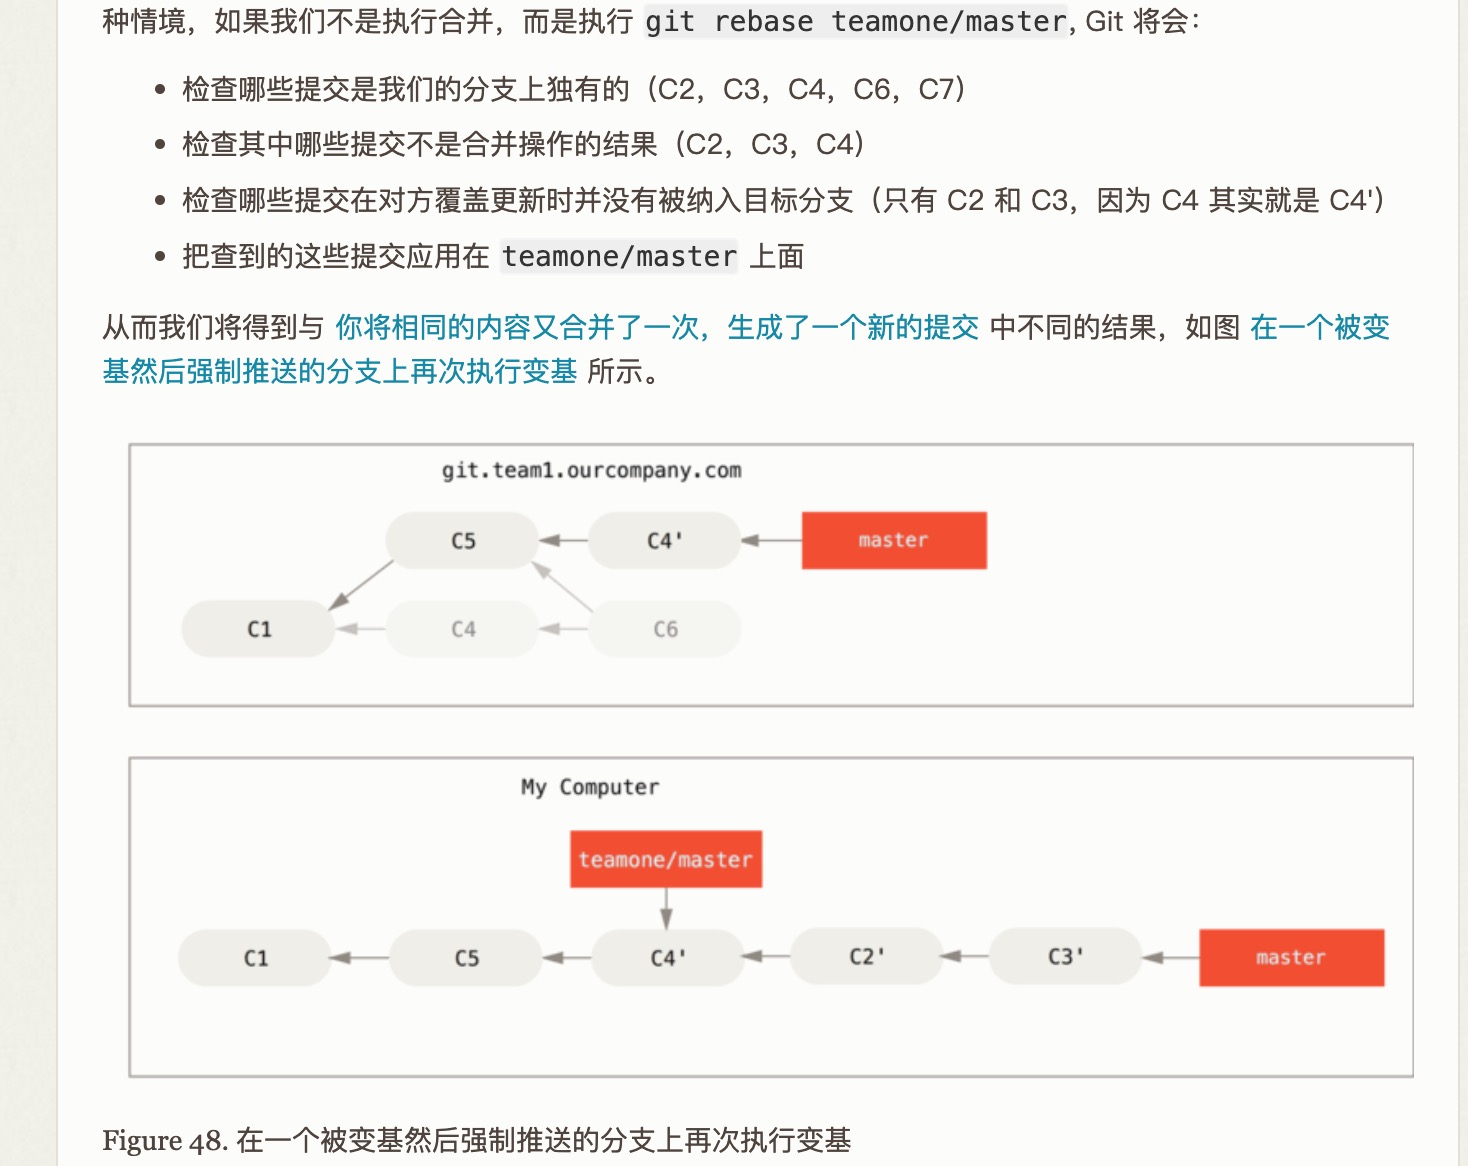
历史分歧可以选择 merge 或 rebase;共享分支的处理方式应与协作者约定。
补丁式 onto(在三个分支上变基)
1 | |
这是一个三分支的变基操作。
以上命令的意思是:“取出 client 分支,找出它从 server 分支分歧之后的补丁, 然后把这些补丁在 master 分支上重放一遍,让 client 看起来像直接基于 master 修改一样”。
编辑冲突文件、删除冲突标记并确认结果后,暂存已解决的文件,再按正在执行的操作继续:
1 | |
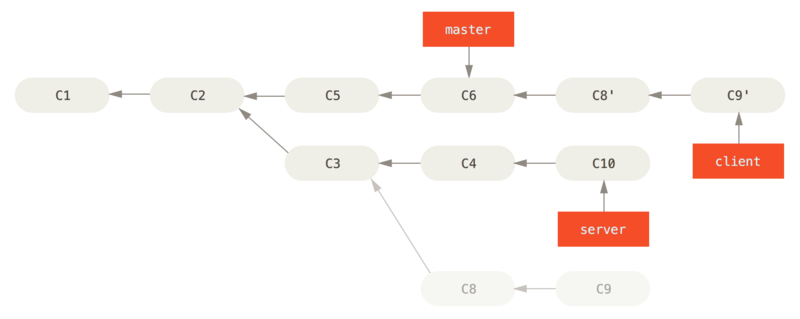
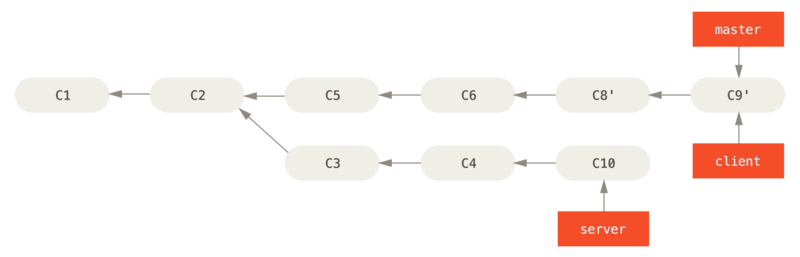
重新创建的提交会因父提交或元数据变化获得新 ID。默认通常保留作者信息和 author date,并更新 committer date;相应选项可以改变日期处理。若无需重放,Git 也可能直接复用已有提交;已在上游存在的等价补丁可能被跳过,因此不能断言每个提交都会重建。
fetch 与远程同步
git fetch 下载所选引用需要的对象,并按 refspec 更新本地引用;通常不修改当前工作目录或索引。拉取范围由命令参数与 remote.<name>.fetch 配置决定,不保证获取所有分支或标签。普通 clone 常配置 +refs/heads/*:refs/remotes/origin/*,而 single-branch clone 的范围可能更窄。
1 | |
git pull 先 fetch,再根据参数和配置合并或变基;--ff-only 在历史分歧时拒绝整合。git merge origin/main 只使用本地已知的 origin/main,不包含 fetch。

远端 main、远程跟踪引用 origin/main、本地 main 是三个不同位置。远端有新提交不会自动移动另外两个;本地 commit 也不会更新 origin/main。
1 | |
push 成功更新某个远端引用后,若存在对应 fetch 映射,Git 也会更新相应的本地远程跟踪引用。push 的结果应逐个引用判断:非原子多引用推送可能部分成功,连接中断也不能证明服务端没有更新。服务端支持时,git push --atomic 可要求引用全部成功或全部不更新;结果不明时可重新 fetch 或用 git ls-remote 查询。
| 操作 | 本地 main | origin/main | 远端 main |
|---|---|---|---|
| 在 main 上 commit | 推进 | 不变 | 不变 |
| fetch origin | 通常不变 | 按 refspec 更新 | 不变 |
| merge origin/main | 整合已知历史 | 不变 | 不变 |
| pull --no-rebase | fetch 后尝试 merge,受 ff 策略约束 | 按 refspec 更新 | 不变 |
| push main 成功 | 不变 | 有对应映射时更新 | 更新 |
| push 出错 | 不变 | 需按各引用结果判断 | 需按各引用结果判断 |
显式 refspec 还可更新非当前本地分支,例如 git fetch origin develop:develop;这不同于默认更新 origin/* 的配置。详见 fetch、pull 和 push 官方文档。
两个分支
master 是本地分支。
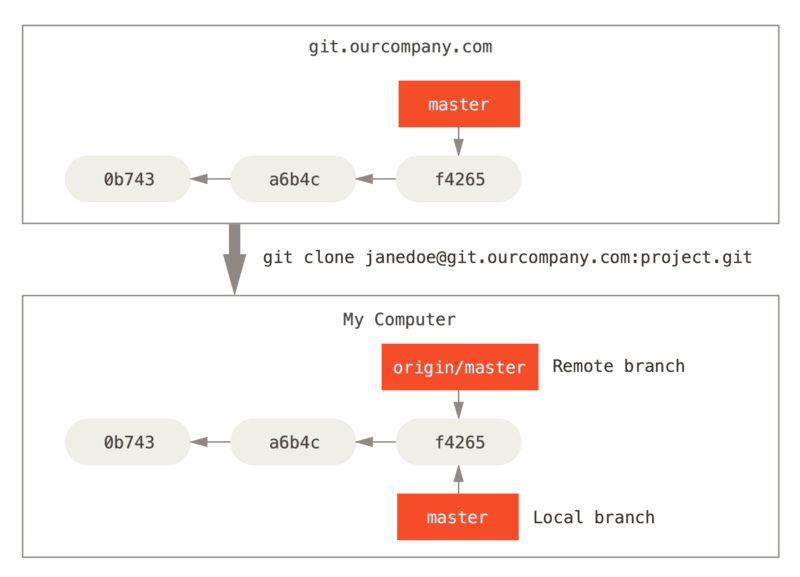
origin/master 是远端 master 在本地的远程跟踪引用。它不会自动更新,需要通过 git fetch 刷新。
1 | |
要整合最新远端状态,可以先 git fetch origin 再 git merge origin/master;也可以用 git pull --no-rebase origin master 连续完成获取与合并,仍受快进策略配置约束。
remote
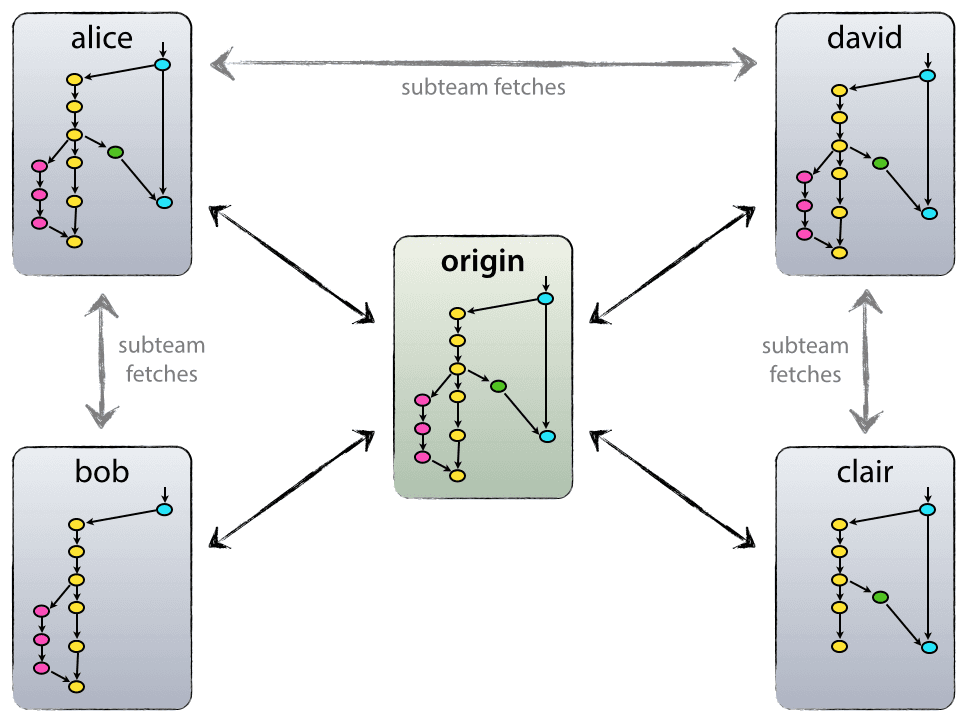
Note that this repo is only considered to be the central one (since Git is a DVCS, there is no such thing as a central repo at a technical level)。
Git是一个分布式版本控制系统(DVCS),而之前的系统大多是集中式的。分布式模型允许每个开发者拥有完整的代码库副本,这为轻量级分支和合并提供了基础。
在Git之前,版本控制系统的设计更多地关注于集中式管理和简单的线性开发模型。随着开源项目和分布式团队的兴起,对更灵活的分支和合并需求变得更加迫切。
Technically, this means nothing more than that Alice has defined a Git remote, named bob, pointing to Bob’s repository, and vice versa.
1 | |
如果 refspec 覆盖 serverfix,git fetch origin 会在本地创建或更新远程跟踪引用 origin/serverfix。要在其基础上开发,可以用 git switch -c serverfix origin/serverfix 创建本地分支。
commit
1 | |
rm
1 | |
(命令)别名
别名可以为常用组合命令提供更短的入口。例如,可以为取消暂存添加 unstage:
1 | |
以下两个命令等价:
1 | |
Git 别名只能展开 Git 子命令;需要组合任意 shell 命令时,直接使用 shell alias 更合适。
特殊技巧
交互式提交
1 | |
update 暂存整个文件,patch 按补丁块选择要暂存的行。暂存两个文件后,交互界面会显示:
Update>>
updated 2 paths
updated 2 paths 表示两个路径已经进入索引。完整示例见7.2 Git 工具 - 交互式暂存。
储藏
在 git 术语里,暂存(stage)和储藏(stash)有很大不同。
git stash 大致上等于 git stash push。按顺序压入栈。
1 | |
这里的 WIP 是 work in progress 的意思,有编号意味着可以从命令里引用。
1 | |
stash 默认就记录索引状态;apply/pop 的 --index 会尝试连同暂存状态一起恢复,遇到冲突时可能无法恢复。
1 | |
Stash 高级用法
1 | |
Stash 最佳实践
- 总是添加描述信息:使用
-m参数为 stash 添加有意义的描述,方便后续识别 - 定期清理:使用
git stash clear或git stash drop清理不再需要的 stash - 使用 --index:恢复时若需要还原暂存区状态,在 apply/pop 上使用
--index选项 - 避免过度使用:stash 是临时解决方案,如果修改很重要,应该创建分支而不是 stash
怎样把一些 commit 从当前分支(通常是 master)移到另一个分支
1 | |
怎样把当前分支的提交直接复制到其他分支
一共有三类补丁操作 cherry-pick/rebase(git rebase 命令基本是是一个自动化的 cherry-pick 命令。 它计算出一系列的提交,然后再以它们在其他地方以同样的顺序一个一个的 cherry-picks 出它们)/revert(git revert 命令本质上就是一个逆向的 git cherry-pick 操作)
1 | |
基于某一个分支压缩本分支上的修改
1 | |
旧资料可能使用 –preserve-merges;当前命令应使用 --rebase-merges,它可以与 --interactive 结合使用。重建合并提交时,原有的人工冲突解决可能需要重新应用。
怎样彻头彻尾地 ignore 不需要的文件(但仍把它保留在 WD 里)
参考 gitignore.io(原 gitignore.io 已迁移至 toptal.com/developers/gitignore)。
- Edit .gitignore to match the file you want to ignore
git rm --cached /path/to/file从索引中移除文件,但保留工作目录中的文件;提交后 Git 将不再跟踪它。
处理经典的双提交冲突
问题:
On branch main Your branch and ‘origin/main’ have diverged, and have 1
and 3 different commits each, respectively. (use “git pull” to merge
the remote branch into yours)nothing to commit, working tree clean
一般的冲突文件格式是:
1 | |
a merge b 遇到冲突,下方就是b的文件,而上方是 a 的文件。
两侧各有独有提交时,fast-forward 已不可能。可以选择 git pull --rebase 重放本地提交,或 git pull --no-rebase 合并历史;若配置了 pull.ff=only,合并方案需要显式选择允许非快进的策略。
然后
1 | |
完成整合后不需要再次执行 pull;先检查状态和测试结果,再决定是否推送。
稀疏检出
1 | |
这样会产生这样的 .git/info/sparse-checkout
1 | |
配置了稀疏检出 (sparse checkout) 之后,git fetch的行为在拉取 commit 和 commit 历史方面,与没有配置稀疏检出时基本没有区别。
git fetch 仍按 refspec 请求引用及所需对象;普通完整克隆中,稀疏检出不会因此减少 fetch 的网络对象范围。partial clone 的过滤配置可以另外限制对象下载。
稀疏检出主要减少工作目录中的文件,影响 checkout、reset 等操作需要更新的路径。cone mode 除选定目录外也会保留相关祖先目录中的文件。它可减少工作目录空间与部分文件扫描成本,但不应据此推断对象数据库或网络传输量一定下降。
Shallow Clone(浅克隆)
Git 有一些额外的优化,如部分克隆(partial clone),可以进一步减少初始下载的数据量。
- 定义:按指定深度截断提交历史,深度为 1 时才只保留所选分支顶端的一层提交。
- 特点:
- 通过 --depth 参数指定克隆的深度,例如 git clone --depth 1 <仓库地址> 只克隆最近一次提交。
- 适用于不需要完整历史记录的场景,可以显著减少克隆时间和存储空间。
- 无法查看或操作克隆深度之外的提交历史。
- 适用场景:
- 快速获取最新代码。
- CI/CD 构建环境中,不需要完整历史记录。
partial clone
- 定义:通过对象过滤延迟获取部分对象;分支选择和工作目录选择分别由引用范围与 sparse checkout 控制。
- 特点:
- 通过 --filter 参数实现,例如 git clone --filter=blob:none --no-checkout <仓库地址>
- 服务器支持过滤时,
blob:none初始不下载 blob;--no-checkout避免立即检出触发文件内容下载。 - 文件内容在需要时按需下载(称为 “lazy fetch”)。
- 适用于大型仓库,可以减少初始克隆的时间和存储空间。
- 适用场景:
- 大型仓库中只关注部分内容。
- 需要按需加载文件的场景。
文件系统优化
btrfs 和 overlayfs 可以加速 git clone。
如果对机器进行内存标签负载均衡,可以降低构建耗时。
使用git调试
git diff 的输出
1 | |
这段 git diff 输出展示了 hello.rb 的 combined diff。两个分支修改了同一文件的同一区域,文件仍处于冲突状态。
这段输出可逐行拆解:
diff --cc hello.rb:这是 Git 使用的 combined diff(合并差异)格式,用于显示文件 hello.rb 中的合并冲突。index 0399cd5,59727f0..0000000:0399cd5 和 59727f0 是两个父版本的 blob 对象 ID。全零值表示合并结果尚未形成可引用的普通 blob,不是实际对象 ID。--- a/hello.rb:这表示冲突发生前的一个版本-旧版本。+++ b/hello.rb:这表示当前工作区中的版本-新版本。@@@ -1,7 -1,7 +1,11 @@@:这是 diff 的统一格式,显示了冲突发生的位置。-1,7 表示在旧版本中从第1行到第7行,-1,7 表示在新版本(另一个合并分支)中也是从第1行到第7行,+1,11 表示在当前工作区中从第1行到第11行。- 符号表示旧版本中的行范围。+ 符号表示**新版本(当前工作区)**中的行范围。在合并冲突的情况下,Git 会在文件中插入冲突标记,这些标记会导致行数增加。因此,合并后的行数(+1,11)通常大于或等于原始行数(-1,7 和 -1,7),因为冲突标记占用了额外的行。#! /usr/bin/env ruby:这是 Ruby 脚本的 shebang 行,告诉系统这个文件应该用 Ruby 来执行。def hello:这是 Ruby 方法的定义。+<<<<<<< HEAD:这是 Git 合并冲突的起始标记(marker),其后的代码块来自 HEAD(当前分支)。+ puts 'hola world':这是 HEAD 分支中的代码,打印 “hola world”。+=======:这是 Git 合并冲突的分隔符,分隔后的代码块来自另一个分支。+ puts 'hello mundo':这是另一个分支中的代码,打印 “hello mundo”。+>>>>>>> mundo:这是 Git 合并冲突的结尾标记,表示另一个分支的代码块结束。end:这是 Ruby 方法的结束。
在正常合并的情况下,顶部(<<<<<<<)显示您的本地更改,而底部(>>>>>>>)显示项目上游所做的更改。当在尝试重新定基期间发生冲突时,顶部将显示您的上游更改,而底部显示主题分支更改。
解决冲突时,需要选择其中一个版本,或手工合并两个版本。修改完成后使用 git add 标记文件已解决,再继续合并或提交。
文件标注(IDEA 中的 Annotate,即 blame)
元数据的三大要素:作者、时间和提交hash。
1 | |
搜索
1 | |
二分查找
1 | |
Bisect 高级用法和最佳实践
1 | |
Bisect 最佳实践
- 编写可靠的测试脚本:确保测试脚本能够准确判断当前版本是否有问题
- 标记好的起始点:选择一个确定没有问题的版本作为 good 标记点
- 跳过无法测试的提交:遇到编译失败或其他无法测试的情况,使用
git bisect skip - 使用可视化工具:使用
git bisect visualize查看当前搜索进度 - 及时记录:找到问题提交后,立即记录并分析问题原因
工作流
本文一部分也参考《Git之GitFlow工作流 | Gitflow Workflow(万字整理,已是最详)》、《一文弄懂 Gitflow、Github flow、Gitlab flow 的工作流》。
git 的横空出世改变了人们对分支和合并的想法。在其他工具里,分支和合并在工具书的最后一章,像要咬人一样。而 git 则把分支和合并放在第三章,因为这些操作非常廉价:
- Git的分支是非常轻量级的,因为它们本质上只是指向提交对象的指针。这使得创建和删除分支非常快速且占用资源少。
- 在Git中,分支操作几乎是瞬时的,不需要复制文件或目录。
相比之下:
- CVS的分支和合并操作相对复杂且容易出错,因为它依赖于文件锁和手动合并。
- SVN的分支是通过复制整个目录结构实现的,这使得分支操作相对笨重。虽然SVN改进了合并支持(如合并信息记录),但合并过程仍然可能涉及大量手动干预。
- Perforce的分支模型较为复杂,通常需要更多的配置和管理。合并操作可能涉及复杂的工作流和权限管理。
Git really changed the way developers think of merging and
branching。git 提倡本地分支,git 提倡分支间合并。For example, in CVS/Subversion books,
branching and merging is first discussed in the later chapters (for
advanced users), while in every Git book, it’s already covered in
chapter 3 (basics).
常见的工作流都是流水的形式,比喻项目像水流那样,顺畅、自然地向前流动,不会发生冲击、对撞、甚至漩涡,而且都采用”功能驱动式开发”(Feature-driven development,简称FDD)。
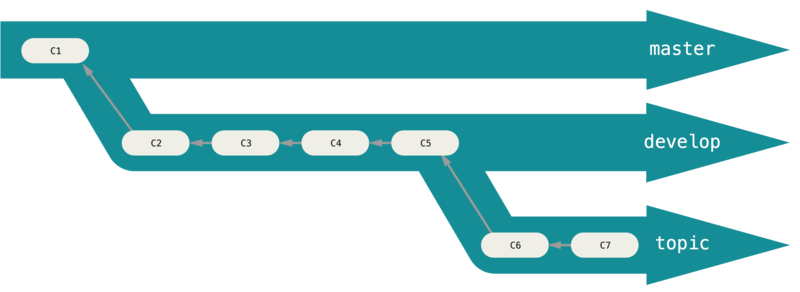
master 通常落后于其他分支,分支的滞后意味着稳定(稳定的代价就是落后)。
GitFlow
GitFlow 源自《A successful Git branching model》,适合需要多个版本并行开发、发布和维护的软件。持续交付的网站通常不需要同时维护 master 与 develop 两条长期分支,因为代码合入和部署之间没有独立的版本发布阶段。
GitFlow 的作者后来补充说明:这个模型面向需要明确版本、同时维护多个版本的软件。持续交付且很少回滚的 Web 应用通常更适合 GitHub Flow 等简化流程。工作流应由发布方式决定,不应把 GitFlow 当作所有项目的默认答案。
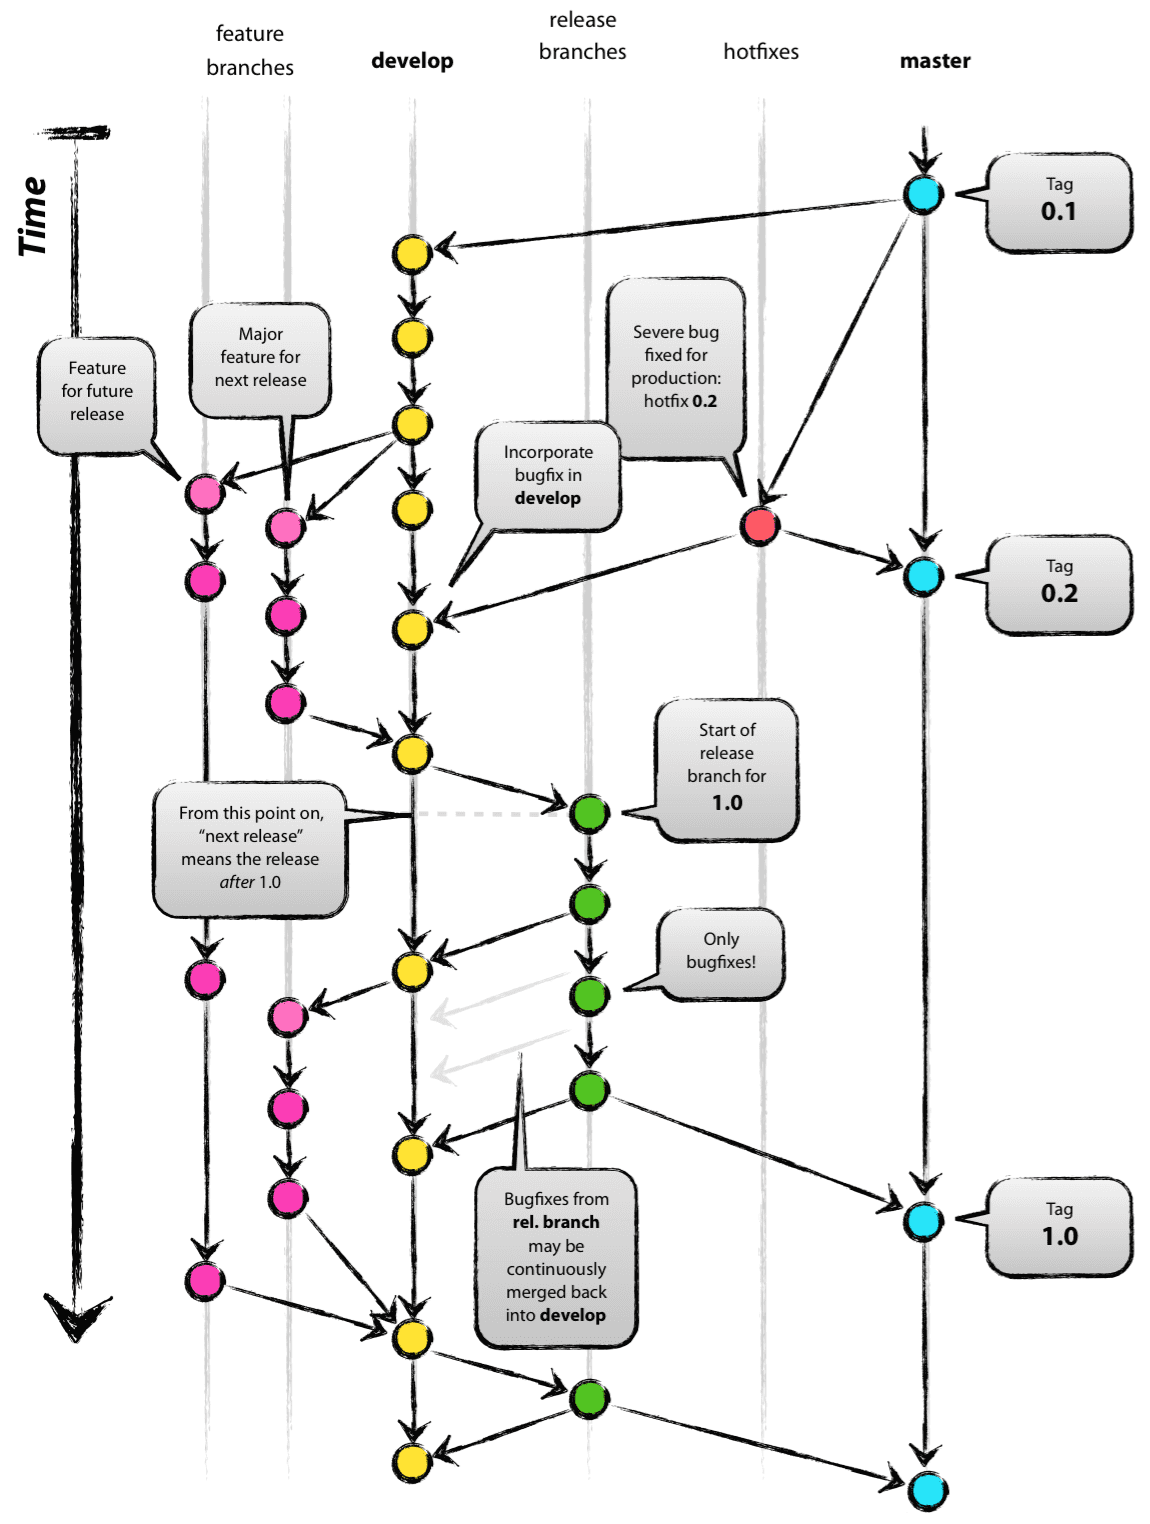
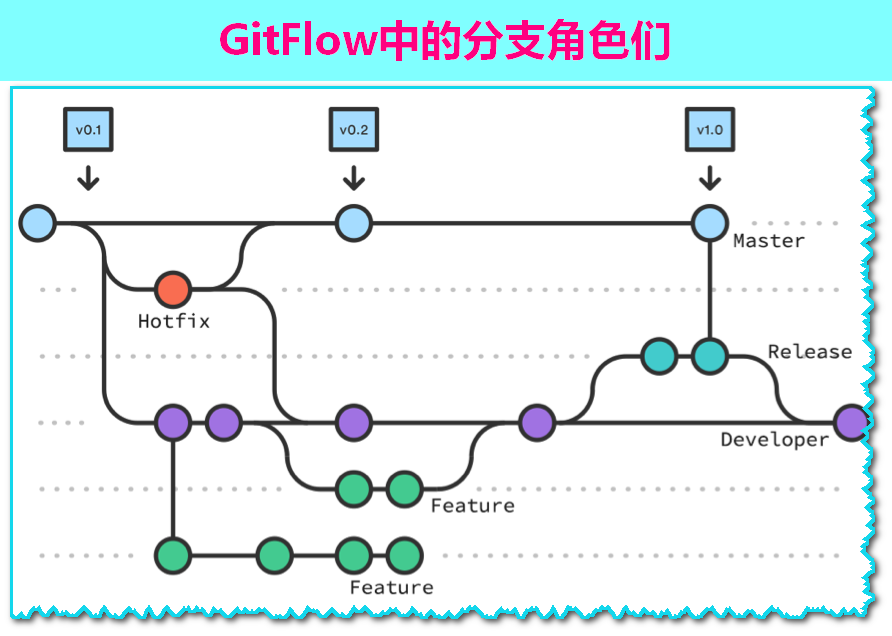
develop 是 feature 分支的起源,release 分支是 develop 到 master 的缓冲。feature 在合并以前都是半成品,branch out 隔离了两条主干。
| 分支名称 | 分支说明 |
|---|---|
| Production | 生产分支,即 Master分支。只能从其他分支合并,不能直接修改 |
| Release | 发布分支,基于 Develop 分支创建,待发布完成后合并到 Develop 和 Production 分支去 |
| Develop | 主开发分支,包含所有要发布到下一个 Release 的代码,该分支主要合并其他分支内容 |
| Feature | 新功能分支,基于 Develop 分支创建,开发新功能,待开发完毕合并至 Develop 分支 |
| Hotfix | 修复分支,基于 Production 分支创建,待修复完成后合并到 Develop 和 Production 分支去,同时在 Master 上打一个tag |
分支
主分支
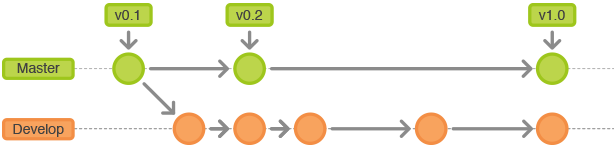
The central repo holds two main branches with an infinite lifetime:
- master-用于生产发布的分支
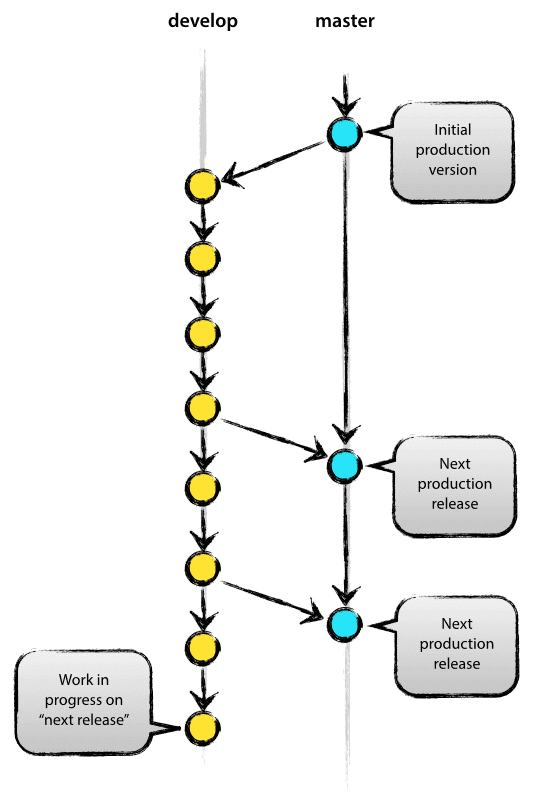
- develop-用于集成构建的分支,这个分支是最繁忙的分支,从 master拉取,所有其他分支都往她这里 merge back,而且除了 hotfix,全部分支都 branch off 这个分支。hotfix 不从 develop 拉取是因为 develop 拥有未经验证的 feature。
这两个分支最好永远处于可编译、可运行状态。develop分支将包含项目的所有历史,而master会是一个缩减版本。
We consider origin/master to be the main branch where the source code of HEAD always reflects a production-ready state. origin/master 的 HEAD 始终对应可用于生产的状态。
任何人不允许在主要分支上进行代码的直接提交,只接受其他分支的合入。原则上主要分支上的代码必须是合并自经过多轮测试及已经发布一段时间且线上稳定的预发分支。master 分支只存放历史发布(release)版本的源代码。即用于存放对外发布的版本,任何时候在这个分支获取到的都是稳定的已发布的版本。各个版本通过 tag 来标记。
We consider origin/develop to be the main branch where the source code of HEAD always reflects a state with the latest delivered development changes for the next release. origin/develop 的 HEAD 包含下一版本最新交付的开发变更,因此也常被称为“集成分支”;自动夜间构建从这里产生。
开发分支是主开发分支,其上更新的代码始终反映着下一个发布版本需要交付的新功能。当开发分支到达一个稳定的点并准备好发布时,应该从该点拉取一个预发分支并附上发布版本号。也有人称开发分支为集成分支,因为会基于该分支和持续集成工具做自动化的构建。
在有些方法论里,这两个分支是不能被主动修改,只应该被合并的,但有些示例里,有人在 develop 里做新的提交:
支持分支
除 master 和 develop 外,GitFlow 还使用支持分支承载并行开发、功能跟踪、发布准备和线上热修复。支持分支生命周期有限,完成任务后即被删除。
- Feature branches
- Release branches
- Hotfix branches
每类支持分支都有固定的起始分支和合并目标。
GitFlow 中的 release 和 hotfix 若不配合版本标签使用,就难以准确标识发布边界。
支持分支只承载特定阶段的工作,合并或废弃后即可删除。
特性分支
Feature branches (or sometimes called topic branches) are used to develop new features for the upcoming or a distant future release. When starting development of a feature, the target release in which this feature will be incorporated may well be unknown at that point. The essence of a feature branch is that it exists as long as the feature is in development, but will eventually be merged back into develop (to definitely add the new feature to the upcoming release) or discarded (in case of a disappointing experiment).功能分支(有时称为主题分支)用于为即将发布或遥远的未来版本开发新功能。开始开发某个功能时,该功能将包含在哪个目标版本中可能还不得而知。功能分支的本质是,只要该功能处于开发阶段,它就会存在,但最终会被合并回去 develop (以明确将新功能添加到即将发布的版本中)或丢弃(以防实验令人失望)。
Feature branches typically exist in developer repos only, not in origin.功能分支通常仅存在于开发人员存储库中,而不存在于origin。
May branch off from:
develop
Must merge back into:
develop
Branch naming convention:
anything except master, develop, release-*, or hotfix-*
开发团队大部分时候做的是从 master 直接拉取 feature,而标准的工作流是从某个特定的 tag 拉取 develop,然后从 develop 拉取 feature。
1 | |
功能完成后由 develop 合并 feature。开发期间若 feature 依赖 develop 上的新变化,可以定期把 develop 整合进 feature;这与最终的合并方向并不矛盾。
合并完就可以删除 feature 分支了,而不是发布以后。
使用 --no-ff 的好处
The --no-ff flag causes the merge to always create a new commit object, even if the merge could be performed with a fast-forward. This avoids losing information about the historical existence of a feature branch and groups together all commits that together added the feature. 该–no-ff标志使合并始终创建新的提交对象,即使合并可以通过快进执行。这避免了丢失有关功能分支历史存在的信息,并将所有共同添加该功能的提交分组在一起。比较:
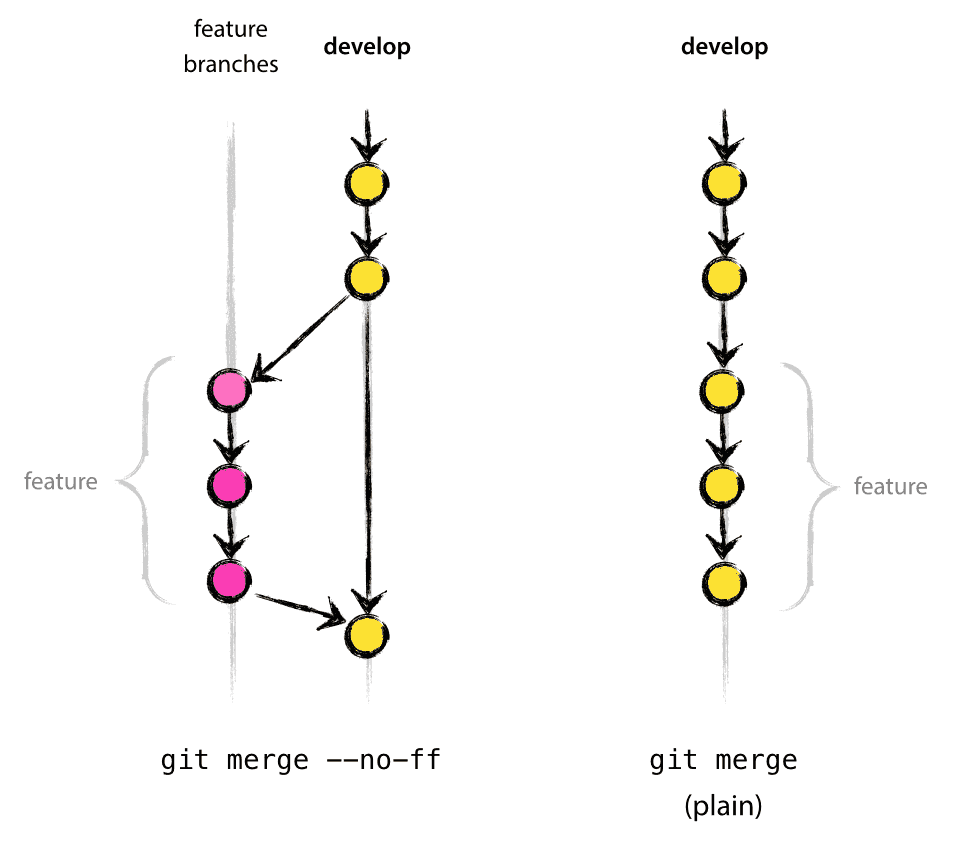
在后一种情况下,无法从 Git 历史记录中看到哪些提交对象一起实现了某个功能 — 您必须手动读取所有日志消息。在后一种情况下,恢复整个功能(即一组提交)确实是一件令人头疼的事情,而如果 --no-ff使用该标志,则可以轻松完成。
是的,它会创建更多(空)的提交对象,但收益远远大于成本。
结论:如果单分支开发 merge,尽量快进合并-甚至使用 rebase;如果跨分支合并,在会删除feature的情况下,保留一个 merge commit 是好的-在回滚的时候尤其如此。
比较痛苦的是多个开发者使用同一个特性分支,这会产生大量的 merge commit:Merge branch 'feature/20241218_aaa' into feature/20241218_bbb。
两个人同时在远端同一分支开发时,反复执行默认的 pull 可能产生多个 Merge branch 'origin/feature/aaa' into feature/aaa 合并提交。提交信息相同,但每次合并对应的本地历史位置不同,仅看日志标题很难分辨。
发布分支
在有的中文翻译里这是预发分支。
May branch off from:
develop
Must merge back into:
develop and master 可以往两个长期分支合并
Branch naming convention:
release-*
发布分支支持准备新的生产版本。它们允许在最后一刻进行细枝末节的完善。此外,它们还允许修复小错误并为版本准备元数据(版本号、构建日期等)。通过在发布分支上完成所有这些工作,该develop 分支就可以接收下一个大版本的功能。
bugfix 在release 上而不是在 feature 上是很多公司会忽略的事情,很多研发人员会直接在 feature 上 fix 而不是在 release 上 fix,这样 release 只是测试用,而合并回 master 的是 feature-这样就让 feature 对 master 的影响更大了。
从 develop 中生成(branch out)出新发布分支的关键时刻是当开发(几乎)反映了新发布所需的状态时。至少所有针对即将构建的发布的功能都必须在此时合并进 develop 。所有针对未来发布的功能可能不会合并 - 它们必须等到生成发布分支之后。
正是在发布分支开始时,即将发布的版本才会被分配一个版本号 — 而不是更早。在此之前,分支develop 反映了“下一个版本”的变化,但在发布分支启动之前,尚不清楚“下一个版本”最终会是 0.3 还是 1.0。该决定是在发布分支开始时做出的,并由项目的版本号提升规则执行。
1 | |
可以说 feature 的分支名带有功能名,而 release 分支带有版本号。
测试在 release 上做,fix 在 release 上做,merge 回 develop-为什么不merge 回 feature?因为feature 分支在上一步删除了。
release分支不是一个放正式发布产品的分支,你可以将它理解为“待发布”分支。
我们用这个分支干所有和发布有关的事情,比如:
- 把这个分支打包给测试人员测试
- 在这个分支里修复bug
- 编写发布文档
所以,在这个分支里面绝对不会添加新的特性。
当和发布相关的工作都完成后,release分支合并回develop和master分支。
单独搞一个release分支的好处是,当一个团队在做发布相关的工作时,另一个团队则可以接着开发下一版本的东西。
GitFlow 允许 feature 开发与 release 收尾并行进行。release 完成后必须合回 develop,避免发布修复只留在 master。正式发布仍按版本顺序推进;一个 release 尚未完成时,不再从 develop 创建新的 release。
热修复分支
May branch off from:
master
Must merge back into:
develop and master 可以往两个长期分支合并
Branch naming convention:
hotfix-*
热修复分支用于计划外的生产修复。需要维护多个已发布版本时,应从对应版本标签创建 hotfix;只维护最新线上版本并采用前滚策略时,通常从 master 的最新提交创建。修复完成后同时合回 master 与 develop,避免后续版本再次引入同一缺陷。
本质(essence)是团队成员(在develop分支上)的工作可以继续,而另一个人正在准备快速生产修复。
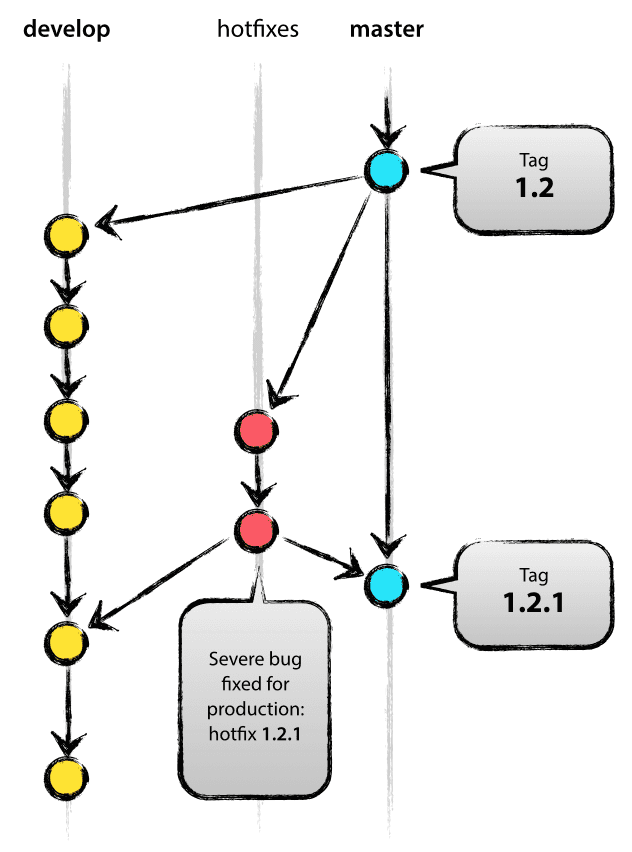
1 | |
hotfix 分支也是带有分支名的。
此处规则的一个例外是, 当当前存在发布分支时,修补程序更改需要合并到该发布分支,而不是develop。将错误修复合并到发布分支最终会导致 develop 在发布分支完成时将错误修复也合并到。如果develop立即需要此错误修复并且不能等待发布分支完成,现在您也可以安全地将错误修复合并到develop。
工具推荐
GitFlow 工具推荐 | 配套工具 列出了命令行和 SourceTree 等实现,腾讯 leflow 也采用了相近的流程封装。
GitHubFlow
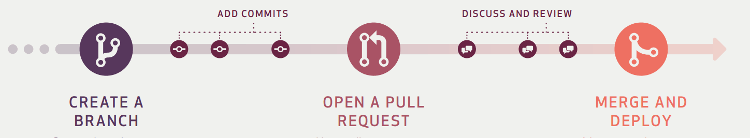
早期自由软件社区中的 fork 常指项目分裂;GitHub 把这个词用于个人命名空间里的仓库副本,使修改和发起贡献请求成为常规操作。
GitHubFlow 只有 master 和其他分支,合并都是通过 PR,不做任何隔离分支-这是大部分公司的最常见的工作模式。
- 派生一个项目
- 从 master 分支创建一个新分支
- 提交一些修改来改进项目
- 将这个分支推送到 GitHub 上
- 创建一个拉取请求
- 讨论,根据实际情况继续修改
- 项目的拥有者合并或关闭你的拉取请求
- 将更新后的 master 分支同步到你的派生中
Github flow 的最大优点就是简单,对于”持续发布”的产品,可以说是最合适的流程。
问题在于它的假设:master分支的更新与产品的发布是一致的。也就是说,master分支的最新代码,默认就是当前的线上代码。
可是,有些时候并非如此,代码合并进入master分支,并不代表它就能立刻发布。比如,苹果商店的APP提交审核以后,等一段时间才能上架。这时,如果还有新的代码提交,master分支就会与刚发布的版本不一致。另一个例子是,有些公司有发布窗口,只有指定时间才能发布,这也会导致线上版本落后于master分支。
上面这种情况,只有master一个主分支就不够用了。通常,你不得不在master分支以外,另外新建一个production分支跟踪线上版本。
merge request vs pull request
from gitlab’s perspective:
Merge or pull requests are created in a git management application and ask an assigned person to merge two branches. Tools such as GitHub and Bitbucket choose the name pull request since the first manual action would be to pull the feature branch. Tools such as GitLab and Gitorious choose the name merge request since that is the final action that is requested of the assignee. In this article we’ll refer to them as merge requests.
维护者对应 assigned person。pull request 的名称来自接收方执行的 pull,merge request 则直接描述请求接收方完成的最终动作;两者都用于请求负责人审查并合并两条历史。
实践中,PR 常用于从 fork 仓库合入上游仓库,MR 常用于同一仓库内的分支合并,但这不是两种名称的硬性边界。
In my point of view, they mean the same activity but from different perspectives:
Think about that, Alice makes some commits on repository A, which was forked from Bob’s repository B.
When Alice wants to “merge” her changes into B, she actually wants Bob to “pull” these changes from A.
Therefore, from Alice’s point of view, it is a “merge request”, while Bob views it as a “pull request”.
中文的解释:
很多人可能会问,提交代码通常是commit或者push,拉取代码才是pull,为什么GitHubFlow中提交代码提出的是“Pull
Request”。因为在GitHubFlow中,PR是通知其他人员到你的代码库去拉取代码至本地,然后由他们进行最终的提交,所以用“pull”而非“push”。
前面说过,Pull Request本质是一种对话机制,你可以在提交的时候,@相关人员或团队,引起他们的注意。
Gitlab flow
Gitlab flow 是 Git flow 与 GitHub flow 的结合。Gitlab flow 的最大原则叫做”上游优先”(upsteam first),即只存在一个主分支master,它是所有其他分支的”上游”。只有上游分支采纳的代码变化,才能应用到其他分支。
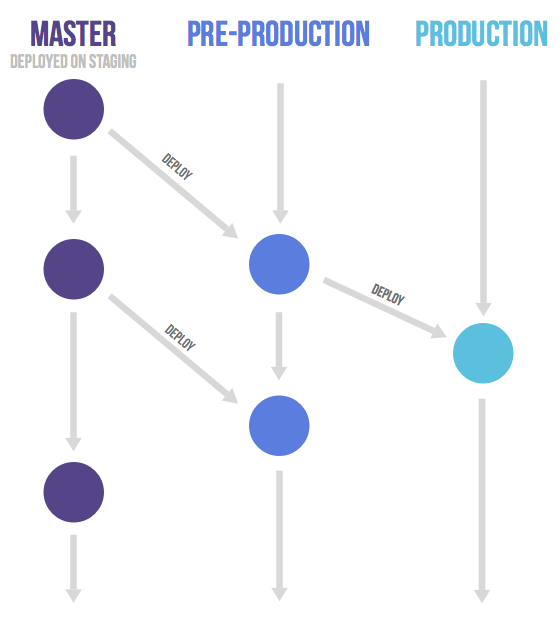
对于”持续发布”的项目,它建议在master分支以外,再建立不同的环境分支。比如,”开发环境”的分支是master,”预发环境”的分支是pre-production,”生产环境”的分支是production。
开发分支是预发分支的”上游”,预发分支又是生产分支的”上游”。代码的变化,必须由”上游”向”下游”发展。比如,生产环境出现了bug,这时就要新建一个功能分支,先把它合并到master,确认没有问题,再cherry-pick到pre-production,这一步也没有问题,才进入production。
只有紧急情况,才允许跳过上游,直接合并到下游分支。
Linux 内核开发也存在主线、子系统维护树与厂商树之间的上游关系;具体补丁提交路径由子系统维护流程决定,不能将它等同于固定的环境分支发布顺序。
版本发布
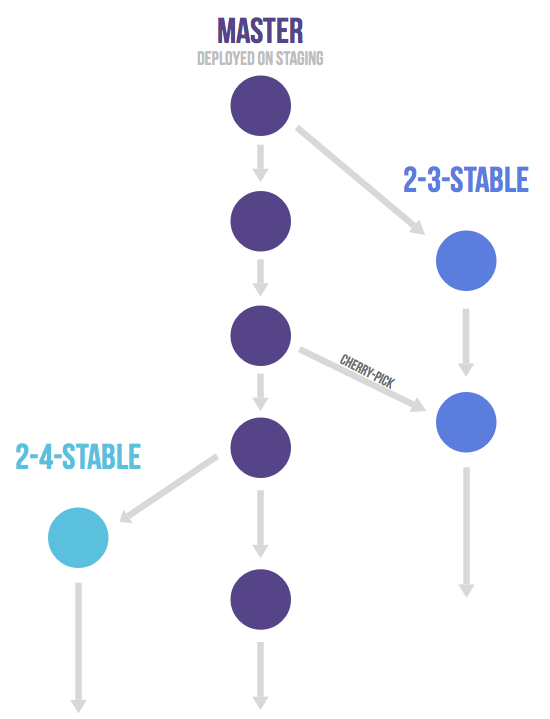
对于”版本发布”的项目,建议的做法是每一个稳定版本,都要从master分支拉出一个分支,比如2-3-stable、2-4-stable等等-在这里,待发布分支就类似版本 tag。
以后,只有修补bug,才允许将代码合并到这些分支,并且此时要更新小版本号。
搭建自己的服务端
github
service and hook
service
GitHub 的旧 “Add Service” 集成已停止服务;新集成应使用 Webhooks 或 GitHub Apps。
hook
Webhook 将所选事件发送到配置的 HTTP 地址。接收端必须先对原始请求体验证 X-Hub-Signature-256,确认事件类型,再解析和处理 payload;还需处理重投递与幂等性。参见 GitHub Webhook 签名验证。
以下代码只展示已验签 push payload 的字段筛选,不是可部署的 HTTP 接收器:
1 | |
push payload 的 commits 列表有数量上限,分支删除也不等同于普通提交更新。需要完整变更集的处理程序应根据事件的 before/after 对象 ID 查询提交,不能把这个筛选示意当成完整审计。
本地 Git Hooks 常见用法
Git hooks 存储在 .git/hooks/ 目录中,分为客户端 hooks 和服务端 hooks。客户端 hooks 在本地操作时触发,服务端 hooks 在服务器端操作时触发。
常用的客户端 Hooks
1. pre-commit(提交前)
- 在运行
git commit命令后,在获取提交消息之前触发 - 常用于代码风格检查、运行测试、检查文件大小等
- 如果返回非零退出码,提交将被中止
1 | |
这个示例检查新增或修改文件的暂存 blob,NUL 分隔能保留空格和换行文件名。按项目需要另接 lint;直接检查工作目录的 lint 不自动等价于检查暂存快照。
2. commit-msg(提交消息)
- 在提交消息创建后触发
- 常用于验证提交消息格式是否符合规范
1 | |
3. pre-push(推送前)
- 在运行
git push命令后,但在实际推送之前触发 - 常用于运行完整的测试套件、检查是否包含敏感信息等
1 | |
敏感信息检测必须检查将推送的提交内容。pre-push 的标准输入逐行提供 <local-ref> <local-oid> <remote-ref> <remote-oid>,扫描器需要据此计算待发送的提交范围,并处理新分支、删除、强推和中间提交;git diff --cached 只看暂存区,提交后通常为空,无法承担这项检查。应接入经过验证的 secret scanner,并在服务端执行必要的检查;本地 hook 可被跳过。
4. post-merge(合并后)
- 在成功合并后触发
- 常用于更新依赖、清理缓存等
1 | |
Hooks 最佳实践
- 使用版本控制管理 hooks:将 hooks 脚本放在仓库的
.githooks/目录中,然后使用符号链接或配置指向它们 - 使 hooks 可执行:确保所有 hooks 脚本具有可执行权限 (
chmod +x) - 提供清晰的错误消息:当 hook 失败时,提供清晰的错误消息说明原因
- 不要阻塞太久:hooks 应该快速执行,避免影响开发体验
- 允许跳过 hooks:在必要时提供跳过 hooks 的选项 (如
git commit --no-verify) - 文档化 hooks:在 README 中说明项目使用的 hooks 及其用途
配置自定义 hooks 目录
1 | |
跳过 Hooks
在必要时,可以使用 --no-verify 选项跳过 hooks:
1 | |
注意:跳过 hooks 应该谨慎使用,仅在特殊情况下使用。
子模块
一个项目有时需要包含另一个独立维护的项目,例如第三方库或由多个父项目复用的内部组件。两个仓库需要保持独立历史,同时又要在同一工作树中协作。
例如,网站需要生成 Atom 订阅时,可以通过 CPAN、Ruby gem 等包管理方式引入现有库,也可以直接复制源码。
包管理方式便于升级,却不适合直接定制源码,并要求部署环境能取得依赖。复制源码便于本地修改,但后续很难继续合并上游变化。
子模块把一个 Git 仓库挂载为另一个仓库的子目录。父仓库只记录子模块仓库的 URL、路径和目标提交,两套提交历史彼此独立。
submodule 可以理解为源码级依赖:父项目引用的是子仓库的特定提交,而不是编译后的库文件。
1 | |
这会改写.gitmodules文件,内容通常是:
1 | |
这样产生的项目在一般的 clone 里是没有子模块内容,而空有目录的,需要执行以下命令:
1 | |
然后在子模块目录中运行git fetch和git merge origin/master
Worktree(多工作树)
Git 2.5 引入的 worktree 功能允许同一个仓库把多个分支同时检出到不同工作目录,适合并行处理多个分支。
使用场景
- 同时修复不同分支的 bug:master 上仍有未完成修改时,可以另建 worktree 修复 release 分支,无需 stash 当前工作。
- 并行开发多个功能:在大型项目中,可能需要同时在多个分支上进行开发或测试。
- 代码审查:可以在另一个工作目录中审查 PR,而不影响当前的工作目录。
- 构建和测试:在一个 worktree 中运行长时间的构建或测试,同时继续在其他 worktree 中开发。
基本用法
1 | |
高级用法
1 | |
注意事项
- worktree 共享对象库和普通引用,包括
refs/stash;各自拥有 HEAD、index 等工作状态。 - stash 可跨 worktree 访问,应用时仍需检查目标工作树是否兼容。
- Git 默认拒绝在多个 worktree 检出同一分支;
--force可覆盖这项检查,但会增加状态混乱风险。 git worktree remove默认拒绝删除含未提交或未跟踪文件的工作树;先保存需要的内容。直接删除目录会绕过保护,prune 也不能恢复文件。
Submodule vs Subtree
Git 提供了两种管理子项目的方式:submodule 和 subtree。它们各有优缺点,适用于不同的场景。
Submodule(子模块)
优点:
- 子模块是完全独立的仓库,有自己的提交历史
- 可以独立更新和管理子模块
- 多个父项目可以共享同一个子模块
- 子模块的提交不会被父项目的提交历史污染
缺点:
- 克隆时需要额外的步骤(
git submodule init和git submodule update) - 子模块的更新需要在子模块目录中单独进行
- 容易出现"detached HEAD"状态
- 团队成员容易忘记更新子模块
- CI/CD 需要特殊配置来处理子模块
适用场景:
- 第三方库或公共组件,需要独立版本控制
- 多个项目共享的通用代码库
- 需要频繁独立更新的子项目
Subtree(子树)
优点:
- 对主仓库的用户透明,不需要额外的克隆步骤
- 子项目的代码直接包含在主仓库中
- 可以在主仓库中直接修改子项目的代码
- 不需要特殊的 CI/CD 配置
- 团队成员使用更简单
缺点:
- 默认会导入子项目历史;使用
--squash时以压缩提交记录更新 - 更新子项目时需要手动合并
- 多个父项目可同步同一个上游,但每个父仓库都保存自己的代码副本并维护同步
- 仓库会保存子项目内容;是否包含完整历史取决于是否使用
--squash - 难以追踪子项目的原始提交
适用场景:
- 项目内部的可复用组件
- 不需要独立版本控制的子项目
- 需要在主仓库中频繁修改的子项目
- 希望简化团队成员使用流程的项目
基本用法对比
Submodule:
1 | |
Subtree:
1 | |
选择建议
- 如果子项目是独立的、需要独立版本控制的第三方库,使用 submodule
- 如果子项目是项目内部的可复用组件,需要频繁修改,使用 subtree
- 如果需要简化团队使用流程,减少配置,使用 subtree
- 如果需要精确控制子项目的版本和历史,使用 submodule
底层与上层命令
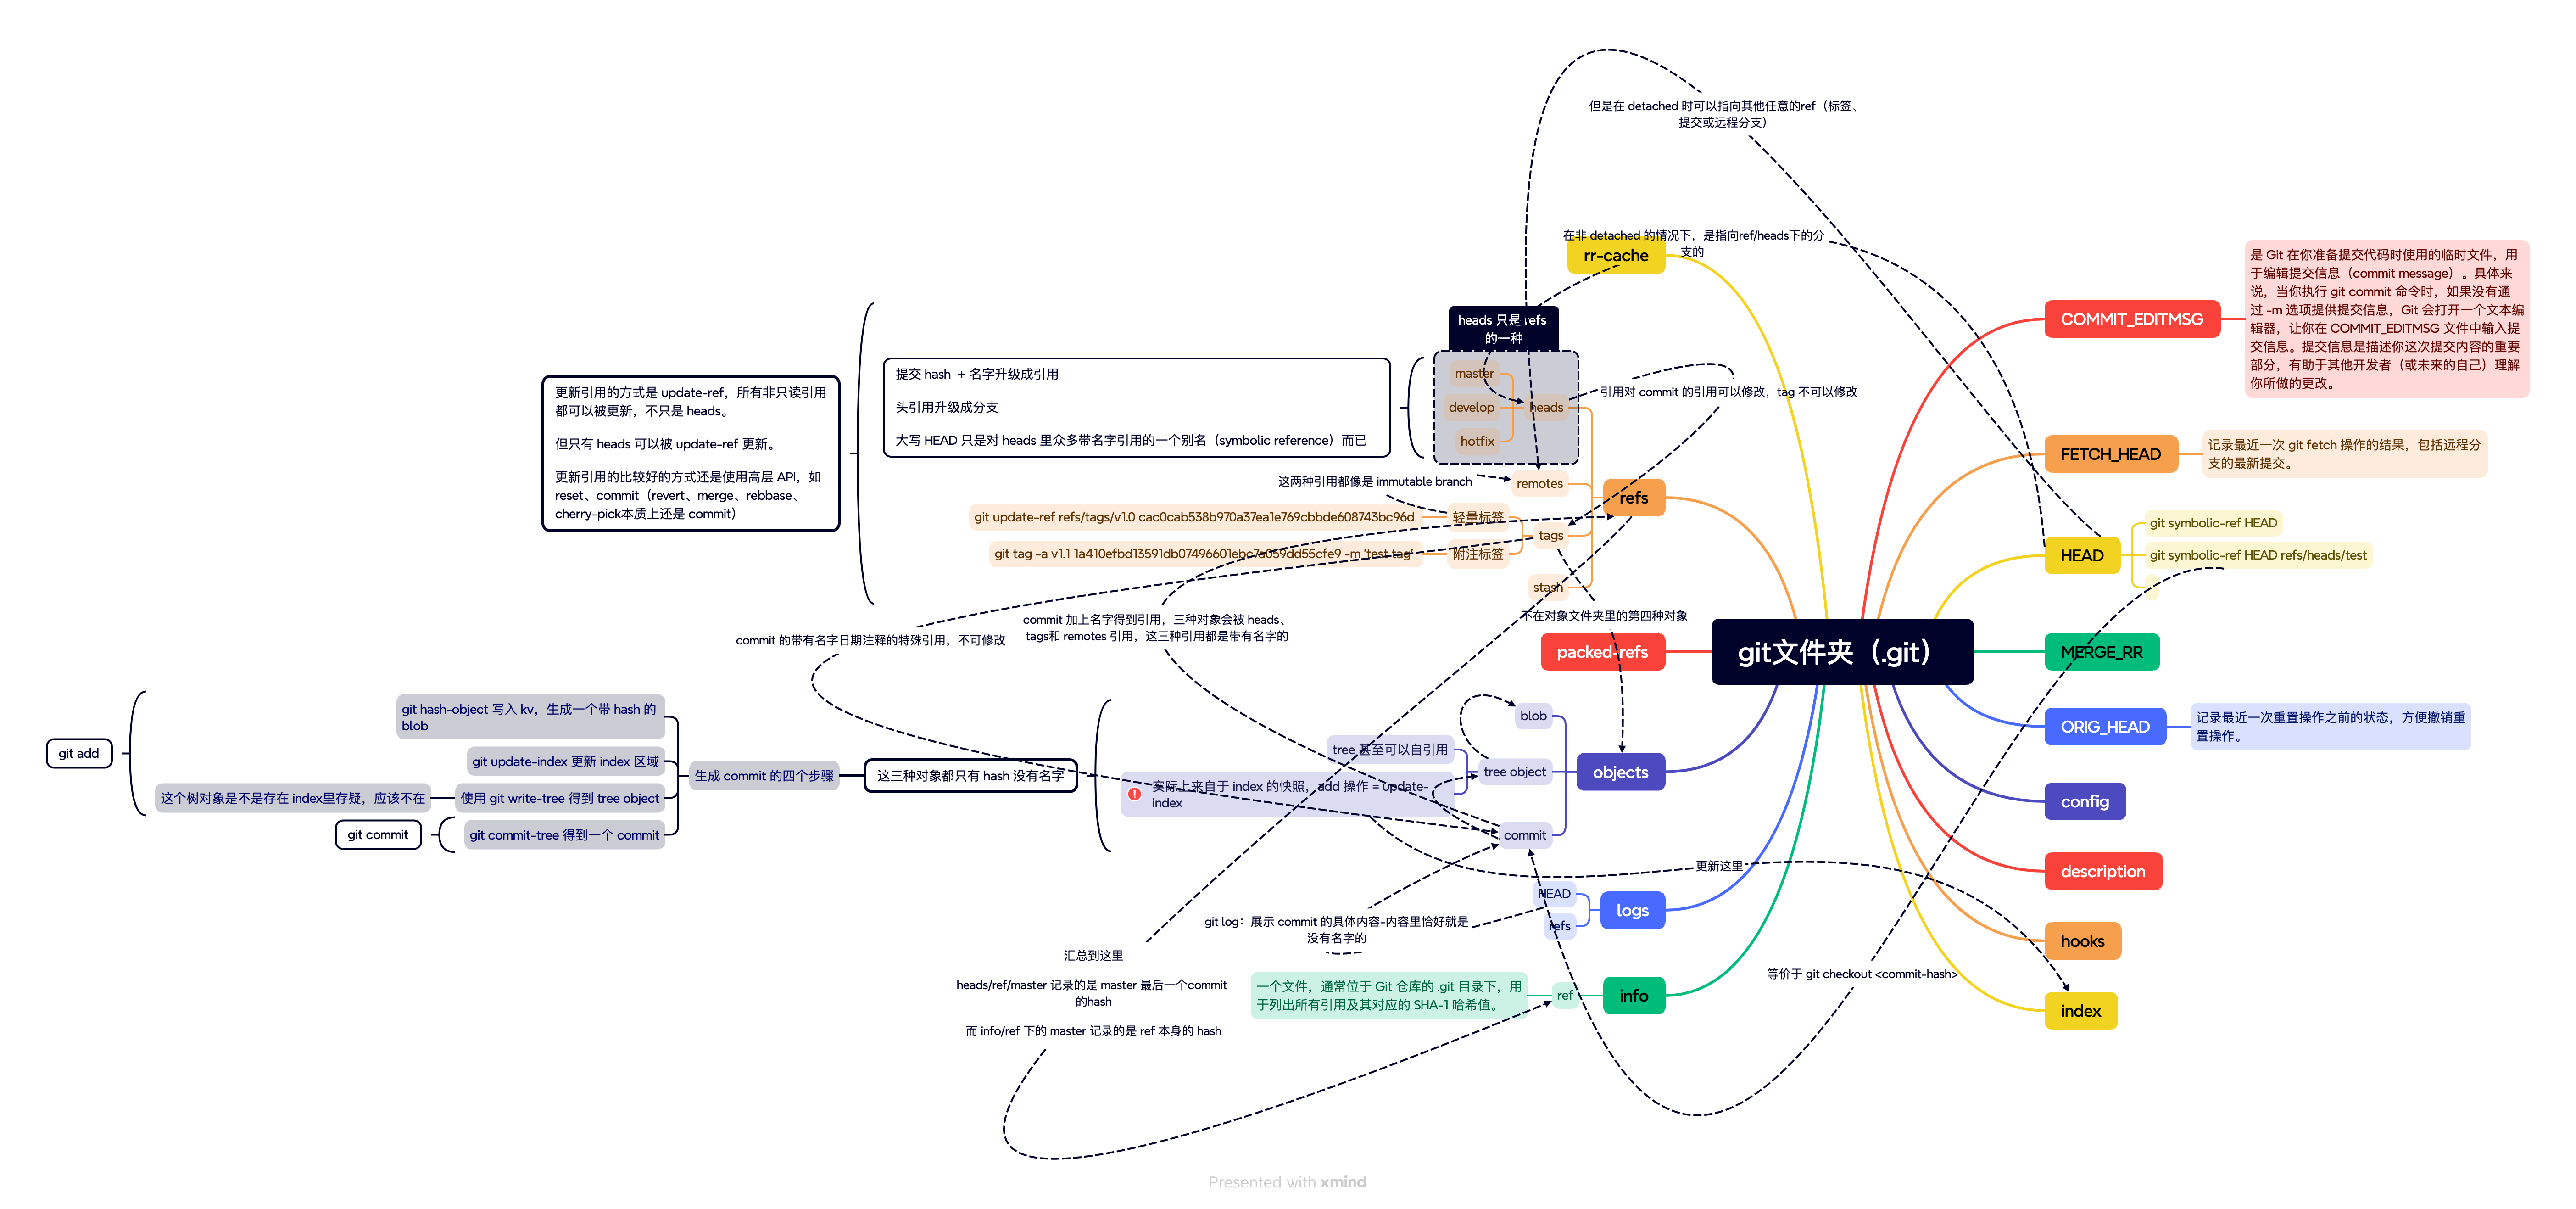
四大关键目录
Git 的底层是内容寻址文件系统,上层再提供版本控制所需的命令界面。
早期 Git,尤其是 1.5 之前的版本,更接近一组操作内容数据库和引用的工具,命令界面也更复杂。后续版本逐步补齐了面向日常版本控制的上层命令。
checkout、branch、remote 等面向日常操作的命令称为上层命令(porcelain)。直接读写对象、索引和引用的命令称为底层命令(plumbing),适合脚本组合,也构成上层命令的基础。
.git 中常见的文件和目录包括:
COMMIT_EDITMSG
FETCH_HEAD
HEAD
MERGE_RR
ORIG_HEAD
config
description
hooks
index
info
logs
objects
packed-refs
refs
rr-cache
不重要的目录:
description文件供 GitWeb 等工具显示仓库描述,日常使用很少直接修改。- config 文件包含项目特有的配置选项。
- [core]
- [submodule]
- [remote “origin”]
- url = git@git.xx.com:groupa/projecta.git
- fetch = +refs/heads/:refs/remotes/origin/
- [branch “feature/migrate-to-spring”]
- remote = origin
- merge = refs/heads/feature/migrate-to-spring
- vscode-merge-base = origin/master
- [pull]
- ff = false
- info 目录包含一个全局性排除(global exclude)文件, 用以放置那些不希望被记录在 .gitignore 文件中的忽略模式(ignored patterns)。
- hooks 目录包含客户端或服务端的钩子脚本(hook scripts)。
重要的目录:
- objects 目录存储所有数据内容;
- refs 目录存储指向数据(分支、远程仓库和标签等)的提交对象的指针;
- HEAD 文件指向目前被检出的分支;
- index 文件保存暂存区信息。
index.lock:暂存区更新的锁与临时文件
.git/index 保存暂存区,index.lock 用于协调它的更新。执行需要写入索引的操作时,Git 排他地创建锁文件,将新索引写入其中,再把它原子重命名为 index。锁同时承担并发写入保护和临时文件的作用,内容不一定为空,也不是记录进程 PID 的文件。
1 | |
在文件系统支持原子重命名的前提下,读取者看到完整的旧索引或新索引,不会看到正在写入的中间版本。Git 在正常退出和可处理的信号退出时会清理未完成的锁;kill -9、断电等无法执行清理的情况可能留下残留文件。机制参见 Git lockfile API。
锁存在不等于仓库损坏。终端、IDE、Git GUI 和自动化代理同时操作同一个工作区,都可能争用索引。即使是 git status,默认也可能刷新文件状态缓存并写回索引;后台状态轮询可使用 git --no-optional-locks status 减少这种竞争。这个选项不会取消 git add 等操作必需的写锁。参见 git-status 的后台刷新说明。
按报错区分原因
| 报错 | 含义 | 排查方向 |
|---|---|---|
Unable to create .../index.lock: File exists |
排他创建失败,锁路径已存在 | 正在运行的操作或遗留锁 |
Permission denied / Operation not permitted |
创建锁被权限或安全策略拒绝 | 目录权限、ACL、沙箱限制 |
Read-only file system / No space left on device |
文件系统不可写或空间不足 | 挂载状态、磁盘空间 |
后两类错误不以已有锁为前提,删除锁通常不能解决。应先检查报错中的实际路径和执行环境,不要通过反复删锁或用 sudo git 掩盖原因。
排查与清理残留锁
先暂停 IDE、GUI 和自动化任务的后台 Git 操作,检查终端里是否仍有 add、commit、checkout、merge 或 rebase 等命令运行。长时间不变的修改时间只是线索,不能证明锁已经失效。
在出问题的工作区定位实际索引,再检查对应锁路径。linked worktree 的 .git 可能是一个指向管理目录的文件,不能假定索引总在工作区的 .git/index 中;自定义 GIT_INDEX_FILE 也会改变索引位置。git rev-parse --git-path 会考虑这些路径差异。
1 | |
lsof 无输出不能单独证明锁可删除:持锁进程可以关闭文件描述符后继续保留锁,进程可见性也可能受权限限制。需要结合运行中的命令、IDE 任务状态及日志,确认没有操作仍在使用该索引。不要仅凭进程名批量终止所有 Git 进程。
只有确认原操作已结束、后台操作已暂停且锁为残留时,才在同一 shell 中执行:
1 | |
删除残留锁不会自动恢复尚未完成的索引更新,清理后应核对暂存内容,并按需要重新执行失败的命令。若 status 显示仍处于 merge 或 rebase 中,应按对应流程继续或中止;删除 index.lock 不会结束这些操作。
锁刚删掉又出现时,应回到并发操作排查,统一同一工作区的写入入口。独立任务可以使用不同 worktree,各自使用独立索引;它们仍共享对象库和部分引用,不能据此认为所有 Git 写操作都互不影响。
二进制对象数据库
本节内容主要参考 Pro Git §10.2 Git Internals - Git Objects 和 §10.3 Git Internals - Git References。
下图展示了 Git 四种对象类型及引用之间的关系:

内容寻址系统
Git 的核心可以看作一个按内容寻址的键值数据库。写入任意内容后,Git 返回由对象内容计算出的键;只要对象仍存在,就能通过该键取回内容。
写入、读取文件
可以通过底层命令git hash-object来演示上述效果——该命令可将任意数据保存于 .git/objects 目录(即 对象数据库),并返回指向该数据对象的唯一的键。
1 | |
最简单的 git hash-object 只计算并返回对象 ID。-w 让命令同时把对象写入数据库,--stdin 则从标准输入读取内容;不使用 --stdin 时,需要在命令末尾提供文件路径。
对象写入后的目录结构如下:
1 | |
版本控制
同一个文件的多个版本可以分别写入对象数据库。先创建文件并保存第一个版本:
1 | |
接着,向文件里写入新内容,并再次将其存入数据库:
1 | |
对象数据库会同时保留该文件的两个版本,先前写入的内容仍然存在:
1 | |
现在可以在删掉 test.txt 的本地副本,然后用 Git 从对象数据库中取回它的第一个版本:
1 | |
或者第二个版本:
1 | |
版本控制是通过存储多个版本来实现的,没有任何覆盖。
几种对象
blob 数据对象
然而:
- SHA-1:记住文件的每一个版本所对应的 SHA-1 值并不现实;
- 名字:这个简单系统只保存文件内容,没有保存文件名。
这种对象称为数据对象(blob object)。给定对象 ID,git cat-file -t 可以显示对象类型:
1 | |
tree object 树对象
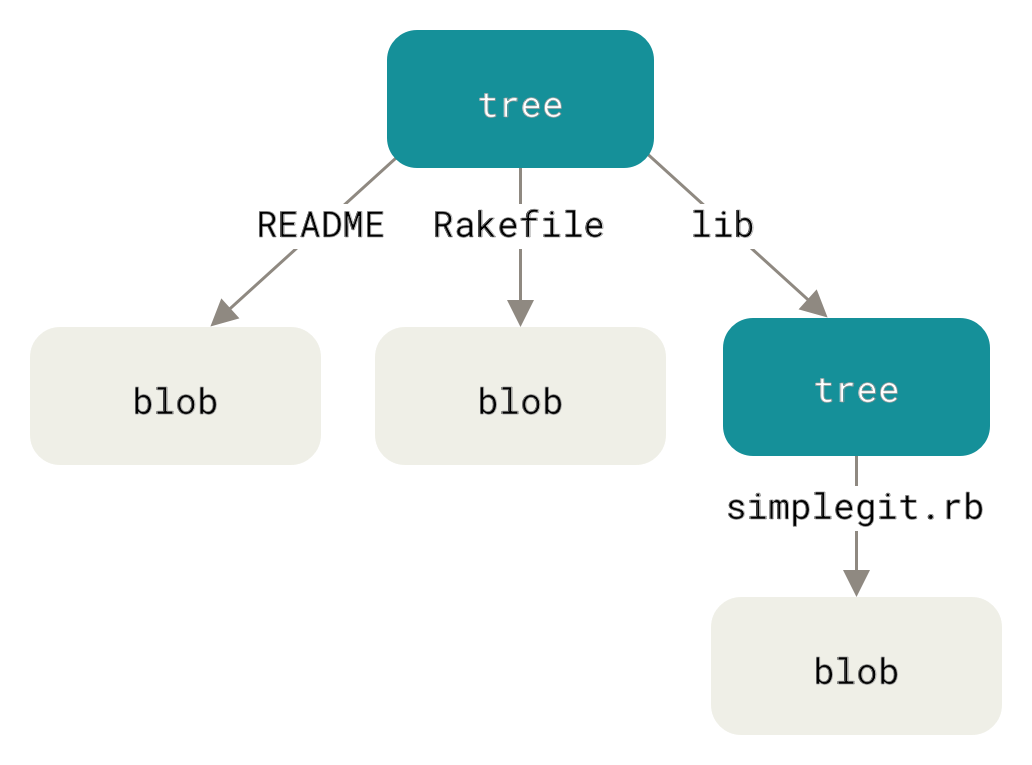
树对象(tree object)负责保存文件名并组织目录结构。Git 采用类似 UNIX 文件系统的简化模型:树对象对应目录,数据对象保存文件内容。树对象包含一条或多条记录,每条记录保存对象 ID、模式、类型和文件名,并指向 blob 或子树。例如:
树对象通过多条 tree entry 指向其他 tree 或 blob,是这里出现的第一种容器对象。
1 | |
master^{tree} 语法表示 master 分支上最新的提交所指向的树对象。 请注意,lib 子目录(所对应的那条树对象记录)并不是一个数据对象,而是一个指针,其指向的是另一个树对象:
1 | |
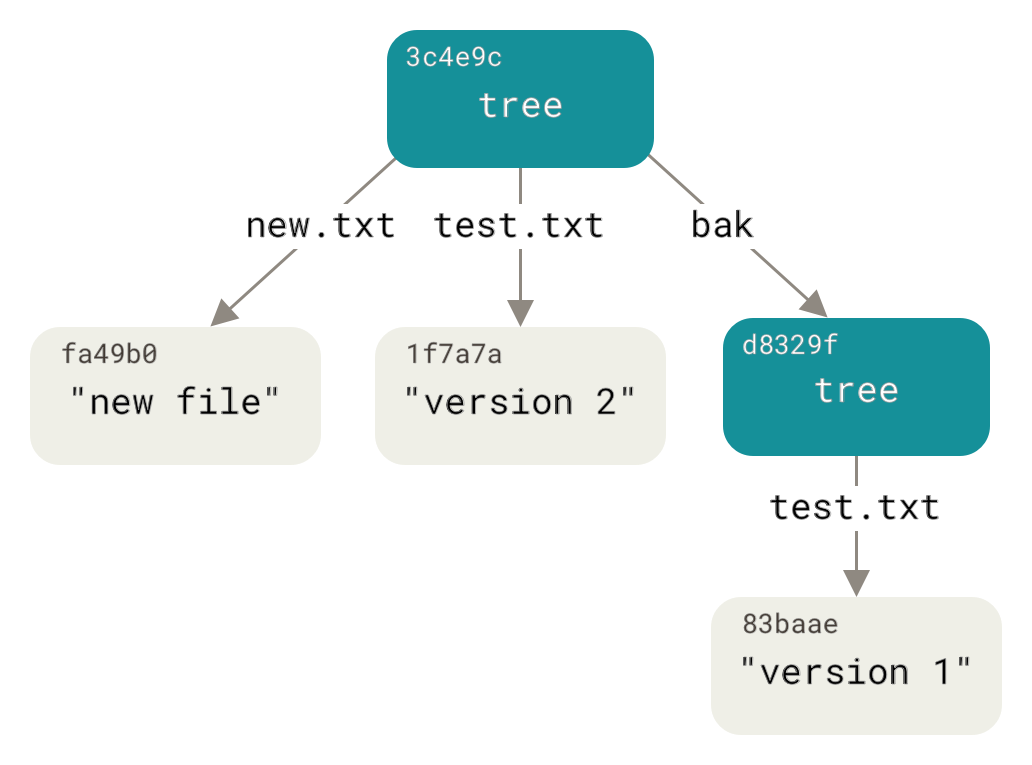
Git 通常根据某一时刻的索引状态创建树对象。索引内容变化后再次写树,就会得到新的目录快照。
因此,为创建一个树对象,首先需要通过暂存一些文件来创建一个暂存区。index 是很多树的源泉,一个个树对象是 index 区的快照,但是 index 不是 tree object!
底层命令 git update-index 可以把 test.txt 的首个版本加入索引。该文件此前不在索引中,因此需要 --add;对象已经位于 Git 数据库而不是当前目录,因此还需要 --cacheinfo,并显式提供文件模式、对象 ID 与文件名:
1 | |
文件模式 100644 表示普通文件,100755 表示可执行文件,120000 表示符号链接。Git 的文件模式取自 UNIX 模式的一个有限子集;目录项和子模块另有对应模式。
现在,可以通过 git write-tree 命令将暂存区内容写入一个树对象。 此处无需指定 -w 选项——如果某个树对象此前并不存在的话,当调用此命令时, 它会根据当前暂存区状态自动创建一个新的树对象:
1 | |
git cat-file 可以验证该对象的类型:
1 | |
下面创建第二个树对象,其中包含 test.txt 的新版本和一个新文件:
1 | |
暂存区现在包含了 test.txt 文件的新版本,和一个新文件:new.txt。 记录下这个目录树(将当前暂存区的状态记录为一个树对象),然后观察它的结构:
1 | |
新的树对象包含两条文件记录,test.txt 指向更新后的对象。git read-tree --prefix 还能把已有树对象作为子树读入索引:
1 | |
这个新树的根目录包含两个文件和一个 bak 子目录,bak 引用最初的树,包含 test.txt 的第一个版本。这是本例第三次调用 write-tree;第二次生成的树没有 bak,第三次才加入该子树。
提交对象
以上操作产生了三个树对象,分别代表不同的项目快照。树对象本身没有父子关系,也不记录作者、时间和原因;这些信息由提交对象(commit object)保存。
commit-tree 根据树对象 ID 和可选的父提交创建提交对象。以下命令从第一个树对象开始:
1 | |
创建时间和作者数据参与对象内容计算,因此实际得到的对象 ID 会与示例不同。git cat-file 可以查看新提交对象:
1 | |
提交对象首先记录代表项目快照的顶层树对象,其后是零个或多个父提交,再后是作者、提交者与时间戳。空行之后保存提交信息。
再创建两个提交对象,并让它们分别引用前一个提交作为父提交:
1 | |
三个提交对象分别指向先前创建的三个树对象快照。对最后一个提交运行 git log,即可遍历这条提交历史:
1 | |
这些底层命令构成了可被 log 遍历的提交历史,但 commit-tree 不自动移动分支引用。普通 git add 对应下面的 1–2 步;git commit 根据索引生成 tree 和 commit,并更新当前分支或 detached HEAD:
git hash-object将被改写的文件保存为数据对象git update-index更新暂存区git write-tree记录树对象git commit-tree最后创建一个指明了顶层树对象和父提交的提交对象
数据对象、树对象和提交对象起初都以 loose object 的形式单独保存在 .git/objects 下,后续可能被打包进 packfile。
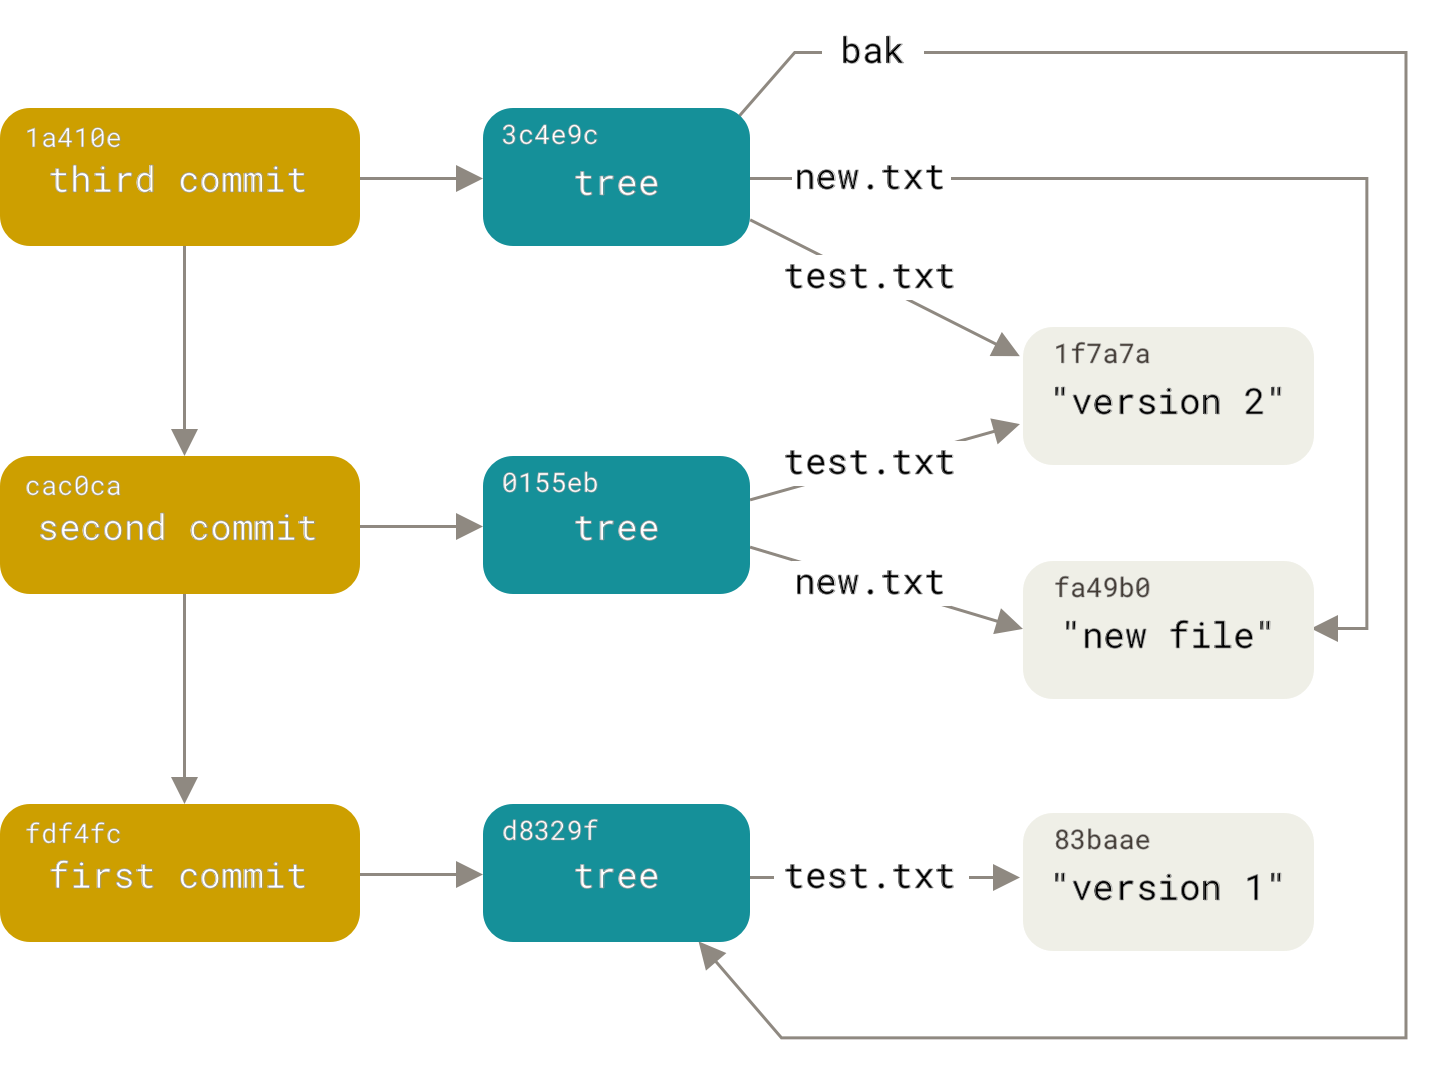
第一列是 commit 对象,第二列是树对象,第三列 blob。
git diff commit1 commit2 会先把两个提交解析到各自的树对象,再比较两棵树。
引用
引用不是 object。
git log 1a410e 可以从指定提交开始遍历历史,但直接记忆对象 ID 很不方便。引用用一个有意义的名字保存对象 ID,命令便可使用名字代替哈希值。
ref 是对象 ID 的可读名称。提交对象本身按内容寻址,分支名和标签名都由引用提供。
从技术上说,创建引用只需写入目标对象 ID:
1 | |
此后 Git 命令可以使用引用名代替对象 ID:
1 | |
直接编辑引用文件容易破坏并发写入。git update-ref 会加锁并原子地创建或更新 heads、tags、remotes、stash 等引用:
1 | |
这基本就是 Git 分支的本质:一个指向某一系列提交之首(头指针、head)的指针或引用。 若想在第二个提交上创建一个分支,可以这么做:
1 | |
这个分支将只包含从第二个提交开始往前追溯的记录:
1 | |
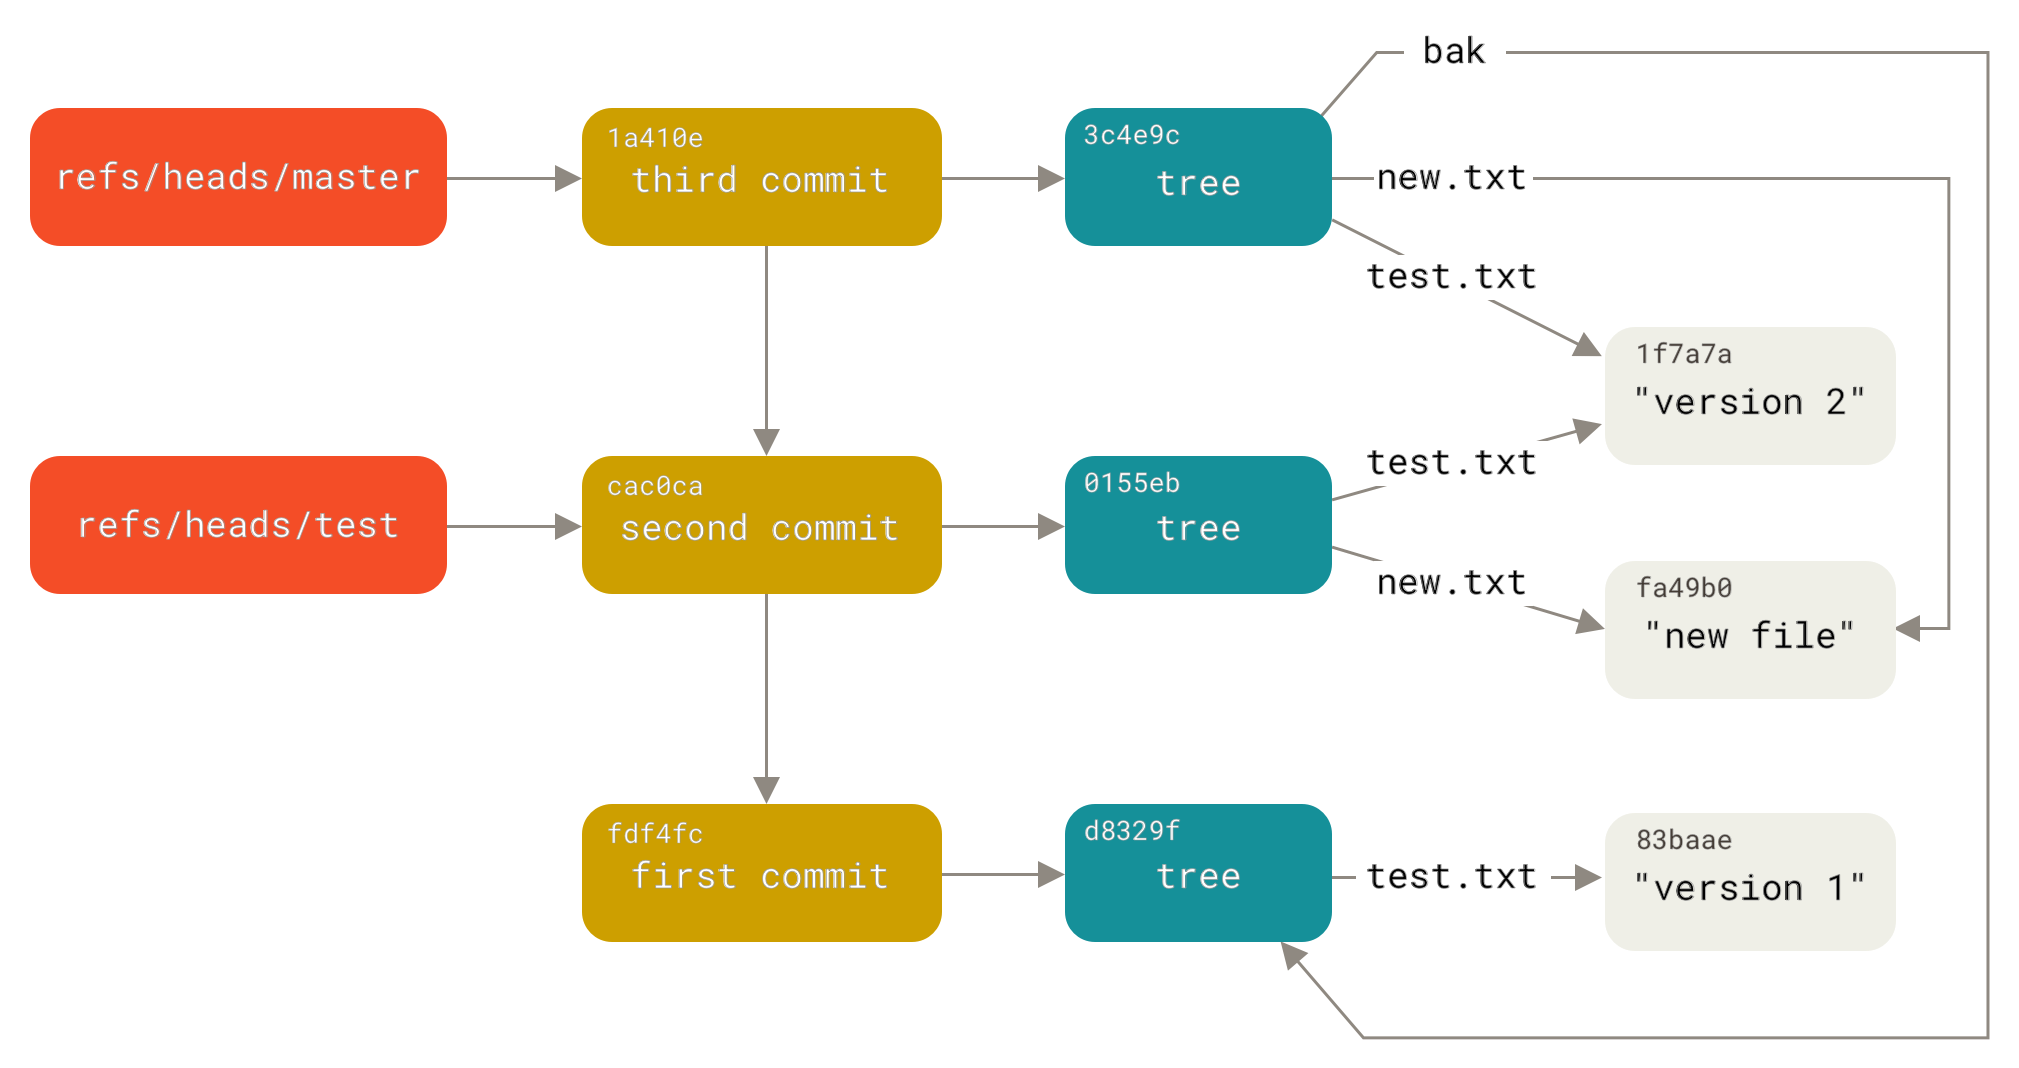
红色的引用,同样也是分支。
HEAD 引用
HEAD 文件通常是一个符号引用(symbolic reference),指向目前所在的分支。 所谓符号引用,表示它是一个指向其他引用的指针。
在 detached HEAD 状态下,HEAD 文件直接包含提交对象 ID。直接检出标签、提交或远程跟踪引用时会进入这种状态。
HEAD 的两种状态如下:
- HEAD 在非 detached 状态下,通常是指向
refs/heads/下分支的符号引用。 - detached HEAD 直接保存提交对象 ID,不是指向任意其他引用。
正常分支状态下,HEAD 包含符号引用。例如:
1 | |
执行 git checkout test 后,HEAD 更新为:
1 | |
执行 git commit 时,Git 创建提交对象,并把 HEAD 最终解析到的提交设为父提交。
git symbolic-ref 可以安全地读取或更新 HEAD 的符号引用,无需手工编辑文件:
1 | |
同样可以设置 HEAD 引用的值:
1 | |
checkout 的本质
直接签出提交 b 时,可以使用以下任一写法:
1 | |
1 | |
两条 checkout 命令都会让 HEAD 直接指向提交 b,这就是 detached HEAD:HEAD 指向具体提交,而不是命名分支。
如果从提交 b 继续创建 e、f,需要创建引用保存这条历史,避免它在失去其他引用后被垃圾回收:
1 | |
离开提交 f 后,可以先通过 reflog 找回它的对象 ID,再为它创建引用。以下任一命令都能查看 HEAD 最近两次移动:
1 | |
回到已经离开的提交,需要先取得该提交的对象 ID。
git reflog -2 HEAD显示 HEAD 最近两次移动,即使已经切换到其他分支或提交,也能据此找回先前位置。- git log -g -2 HEAD会显示HEAD最近的两次移动,格式类似于git log的输出。
然后git checkout <commit-hash>
标签引用
默认的 git push 不会自动传送标签。共享标签需要显式执行 git push origin <tagname>,或按需要使用 --tags、--follow-tags。
1 | |
除数据对象、树对象和提交对象外,Git 还有标签对象(tag object)。它保存标签创建者、日期、注释以及目标对象 ID。
附注标签对象存储在 .git/objects 目录中(与数据对象、树对象、提交对象一样),但标签的引用存储在 .git/refs/tags/ 目录下。
标签对象通常指向提交,也可以指向 tree、blob 或另一个 tag 对象。对象内容不可变,标签引用则可以通过 git tag -f 替换;发布后的标签通常按约定保持不变。
轻量标签(lightweight)
轻量标签直接引用目标对象,通常是某个提交;它没有独立的标签对象及标签元数据。
1 | |
这就是轻量标签的全部内容——一个固定的引用。
附注标签(annotated)
附注标签在对象数据库中有独立的标签对象,包含创建者、电子邮件、时间和注释,并可使用 GPG 签名。正式发布通常使用附注标签;临时标记可以使用不带独立对象和元数据的轻量标签。
若要创建一个附注标签,Git 会创建一个标签对象,并记录一个引用来指向该标签对象,而不是直接指向提交对象。
1 | |
下面是上述过程所建标签对象的 SHA-1 值:
1 | |
现在对该 SHA-1 值运行 git cat-file -p 命令:
1 | |
标签对象的 object 条目保存目标对象 ID。目标不必是提交,也可以是 tree、blob 或另一个 tag。Git 源码仓库曾把维护者的 GPG 公钥保存为 blob 并为其添加标签,可通过以下命令查看:
1 | |
Linux 内核仓库也存在不指向提交的标签对象:最早的标签对象指向初始导入源码对应的树对象。
远程引用
远程跟踪引用记录本地最后已知的远端位置,通常由 fetch,以及存在映射时的成功 push 更新。
第三类引用是远程跟踪引用(remote-tracking reference)。Git 将最后已知的远端分支位置保存在 refs/remotes 下。以下命令添加 origin 并推送 master:
1 | |
此时,如果查看 refs/remotes/origin/master 文件,可以发现 origin 远程版本库的 master 分支所对应的 SHA-1 值,就是最近一次与服务器通信时本地 master 分支所对应的 SHA-1 值:
1 | |
远程跟踪引用不用于日常直接提交;它不是底层不可写的对象,update-ref 也能修改它。checkout 远程跟踪引用时,HEAD 直接指向对应提交,而不会指向该远程引用,因此后续 commit 不会推进远程跟踪引用。Git 把它们作为远端各分支最后已知位置的本地书签。
remote 底层的配置类似这样(很像 submodule):
1 | |
删除 git 文件
git clean 命令用于删除工作目录中的未跟踪文件(untracked files)。未跟踪文件是指那些不在暂存区中且未被 Git 跟踪的文件。要删除目录下所有未被 Git 跟踪(未添加到暂存区或仓库)的文件,具体步骤如下:
- 首先,查看将要删除的文件列表(建议先执行这一步,以防误删重要文件):
1 | |
这会以“dry run”(模拟执行)的方式显示哪些未跟踪的文件将被删除,而不实际删除它们。
如果您还有未跟踪的目录想要删除,可以使用:
1 | |
这会显示将要删除的未跟踪的文件和目录。
- 确认后,执行删除操作:
1 | |
这会删除当前目录及其范围内符合规则的未跟踪文件;默认保留被忽略文件,不会递归删除未跟踪目录。
如果还需要删除未跟踪的目录,请使用:
1 | |
- 如果您想要强制删除包括 .gitignore 中忽略的文件,可以使用:
1 | |
-x 将被忽略文件也纳入范围,但不会隐含 -d。需要包含目录时,先用 git clean -ndx 预览,再根据清单决定是否执行 git clean -fdx。
提示:
- 在执行
git clean命令前,确保您已经备份了重要的未跟踪文件。 - 使用 -i 选项可以交互式地选择要删除的文件:
1 | |
- 要了解更多关于 git clean 命令的选项,可以查看帮助:
1 | |
总结:
clean 从当前目录开始按 pathspec 清理,默认跳过忽略文件。-d 包含未跟踪目录,-x 包含忽略文件;嵌套 Git 仓库另有保护,需要第二个 -f 才可能删除。先用完全相同的范围和选项做 dry-run,再删除确认不需要的文件。
git 支持的协议
Git 支持 HTTPS、SSH、原生 git:// 和本地路径等传输方式。SSH 地址可以写成 user@server:path/to/repo.git 或 ssh://user@server/path/to/repo.git;具体服务器支持哪些协议应以其文档为准,GitHub 已停止支持未加密的 git:// 传输。
本地路径或 file:// 适合在同机或可信共享文件系统上交换仓库,性能取决于文件系统和访问方式。HTTPS 与 SSH 提供加密传输;原生 git:// 不提供认证与加密。协议性能还受网络、服务端和对象打包影响,不能仅按协议名确定速度排名。
如何清理 git 历史
- 下载 下载BFG Repo-Cleaner工具,如 bfg-1.14.0.jar。
- 把敏感信息在当前最新版本里都删除。
- 使用mirror标志克隆一个裸仓库(普通文件将处于不可见):
git clone --mirror git@git.woa.com:aaa/myproject myproject_rmhistory。 - 生成一个 rule 文件,如 rule.txt:
testpass。每一行一个敏感词。 java -jar bfg-1.14.0.jar --replace-text rule.txt myproject_rmhistory。cd myproject_rmhistory。git reflog expire --expire=now --all && git gc --prune=now --aggressive。- 发布重写后的历史前,暂停协作者写入、保留离线备份,并核对所有待更新和删除的引用。mirror clone 通常配置
remote.origin.mirror=true,普通 push 也会镜像推送全部引用,可能删除远端独有引用。先用git push --mirror --dry-run origin检查范围;只有在整个远端引用集都获准替换后,才执行git push --mirror origin。
强制推送不会关闭分支保护,也不能绕过服务器 hook 或权限限制。保护规则需要有权限的维护者单独调整。泄露的凭据应先撤销或轮换;改写 Git 历史不等于删除其他克隆、缓存或托管平台保留的副本。
IDEA 上的 Git
在 IntelliJ IDEA 中使用 Git 时,有以下要点:
- 查看 Git 命令输出:应查看"视图 → 工具窗口 → Git → 控制台面板",而不是终端面板。控制台面板会显示 IDEA 在后台执行的所有 Git 命令及其输出。
- 分支管理:右下角状态栏显示当前分支名,点击可快速切换分支、创建分支、合并分支。
- 冲突解决:IDEA 提供三路合并(three-way merge)工具,左侧为本地版本,右侧为远程版本,中间为合并结果,比命令行解决冲突更直观。
- 交互式 Rebase:通过 “Git → Rebase” 菜单可以进行交互式 rebase,支持拖拽调整 commit 顺序、squash、edit 等操作。
- Local History:IDEA 独有的本地历史功能(右键文件 → Local History → Show History),即使没有 Git commit,也能恢复文件的历史版本,是 Git 之外的额外安全网。
- Shelve vs Stash:IDEA 提供 Shelve(搁置)功能,类似
git stash但由 IDEA 管理,不依赖 Git。两者可以配合使用。 - Annotate(Blame):在编辑器左侧边栏右键 → Annotate with Git Blame,可以逐行查看每行代码的最后修改者和提交信息。
Git 核心概念速查表
| 概念 | 本质 | 存储位置 |
|---|---|---|
| blob(数据对象) | 文件内容的快照 | .git/objects/ |
| tree(树对象) | 目录结构的快照,包含 blob 和子 tree 的引用 | .git/objects/ |
| commit(提交对象) | 指向顶层 tree + 父 commit + 作者/提交者信息 | .git/objects/ |
| tag(标签对象) | 指向任意 Git 对象 + 标签元数据(仅附注标签) | .git/objects/ |
| branch(分支) | 指向某个 commit 的可变指针 | .git/refs/heads/ |
| HEAD | 指向当前分支(或直接指向 commit) | .git/HEAD |
| 远程跟踪引用 | 本地记录的远端最后已知位置 | .git/refs/remotes/ 等引用存储 |
| index(暂存区) | 下次 commit 的快照预览 | .git/index |
| reflog | HEAD 和其他已启用日志引用的更新记录(仅本地) | .git/logs/ |
表中的路径按常见 files 引用后端列举。引用也可能保存在 packed-refs,其他后端(如 reftable)布局不同;linked worktree 的 HEAD 和 index 与共享对象库分开存放。
常用操作与底层命令的对应关系
| 高级命令 | 底层操作 | 影响的区域 |
|---|---|---|
git add |
hash-object + update-index |
Working Directory → Index |
git commit |
write-tree + commit-tree |
Index → Repository |
git reset --soft |
移动 HEAD/branch 指针 | Repository(保留 Index 和 WD) |
git reset --mixed |
移动 HEAD/branch + 重置 Index | Repository + Index(保留 WD) |
git reset --hard |
移动 HEAD/branch + 重置 Index + 恢复已跟踪文件 | 可丢弃本地修改,不等于清理全部未跟踪文件 |
git checkout <branch> |
移动 HEAD(不移动 branch) | HEAD + Index + WD |
git stash |
创建临时 commit 保存 WD 和 Index | WD + Index → 临时存储 |