从规则到统计:人工智能七十年的两条路线之争
人工智能史常被讲成一场接力:符号主义退场,统计学习接棒,深度学习又取代统计学习。这个顺序很整齐,却把不同维度的概念排进了同一条时间线。符号主义和连接主义谈知识怎样表示,统计学习谈怎样从样本估计规律,监督、自监督和强化学习谈训练信号,CNN、Transformer、ResNet 谈计算结构。
| 维度 | 它在问什么 | 代表概念 | 关系怎么看 |
|---|---|---|---|
| 知识表示与智能观 | 知识放在哪里 | 符号主义、连接主义 | 两种智能建模路线,前者偏符号与规则,后者偏参数与分布式表示 |
| 统计学习与机器学习 | 如何从样本估计规律并控制泛化 | 统计学习、SVM、概率模型、神经网络 | 统计学习是一种理论视角与方法传统,与机器学习和深度学习大面积重叠 |
| 学习信号 | 什么反馈让模型更新 | 监督、自监督、无监督、强化学习 | 与上面两个维度交叉,例如“深度学习 + 强化学习” |
| 计算架构 | 模型怎样组织计算 | DNN、CNN、RNN、Transformer、ResNet | 它们是网络结构或优化设计,不与“统计学习”处在同一分类层级 |
统计学习贯穿了从 SVM 到深度神经网络的多条路线。一个 Transformer 语言模型可以同时采用连接主义的分布式表示、统计估计、自监督预训练和强化学习后训练。这些标签落在四个维度上,彼此并不冲突。
一张图先把概念摆正
人工智能(Artificial Intelligence,AI)是研究领域的总称。机器学习(Machine Learning,ML)研究怎样让模型从数据或交互中改变参数与行为。统计学习(Statistical Learning)与机器学习高度重叠,更关心样本估计、泛化误差、模型复杂度和不确定性。
深度学习(Deep Learning)属于机器学习,通常以多层神经网络学习表示。训练过程离不开损失函数、概率分布、最大似然、梯度下降、正则化和泛化分析。它延续了连接主义,也大量使用统计学习和数值优化。
flowchart LR
    subgraph REP[知识表示:知识以什么形式存在]
        direction TB
        SYMBOLIC[符号主义\n符号、规则、程序]
        CONNECTIONIST[连接主义\n连接、参数、分布式表示]
        OTHER[其他表示\n表格、树、核方法、概率图模型]
    end

    subgraph METHOD[学习与估计:怎样从经验获得参数或结构]
        direction TB
        ML[机器学习]
        STAT[统计学习\n估计与泛化]
        DL[深度学习\n多层神经网络]
        RULE[规则 / 程序学习]
        VALUE[价值函数估计]
        ML --> DL
        ML --> RULE
        ML --> VALUE
        ML -. 大面积交叠 .-> STAT
        STAT -. 与深度学习交叠 .-> DL
    end

    subgraph SIGNAL[学习信号:什么反馈让模型更新]
        direction TB
        SUP[监督学习]
        SELF[自监督学习]
        RL[强化学习]
    end

    subgraph ARCH[计算结构:模型怎样组织计算]
        direction TB
        LOGIC[逻辑程序]
        TABLE[查表 / 动态规划]
        CNN[CNN]
        TRANS[Transformer]
    end

    CONNECTIONIST -. GPT 类预训练模型 .-> DL
    DL -. GPT 类预训练模型 .-> SELF
    SELF -. GPT 类预训练模型 .-> TRANS

    CONNECTIONIST -. DQN .-> DL
    DL -. DQN .-> RL
    RL -. DQN .-> CNN

    SYMBOLIC -. 归纳逻辑程序设计 .-> RULE
    RULE -. 归纳逻辑程序设计 .-> SUP
    SUP -. 归纳逻辑程序设计 .-> LOGIC

    OTHER -. 表格型 Q-learning .-> VALUE
    VALUE -. 表格型 Q-learning .-> RL
    RL -. 表格型 Q-learning .-> TABLE
横向四栏仍是四个问题;带同一名称的虚线串起一个系统在四个问题上的取值,不表示包含关系或因果链。GPT 类预训练模型常见的组合是连接主义表示、统计学习与深度学习、自监督学习和 Transformer;后训练还可叠加奖励或偏好信号。DQN 是连接主义、深度学习、强化学习和 CNN 的组合。归纳逻辑程序设计从样本中学习规则,属于学习型的符号方法;表格型 Q-learning 会学习价值,却既不是连接主义网络,也不是用人工规则写成的符号系统。SVM、树模型和许多概率模型通常也不按符号主义与连接主义这组历史标签归类。
符号主义与连接主义争什么
符号主义把知识写成规则
符号主义把智能看成符号的表示与操作。事实、概念、关系和规则被写成逻辑表达式、语义网络或产生式规则,推理引擎再通过匹配、搜索和演绎得到结论。
这套思想早于计算机。莱布尼茨试图用通用逻辑演算表达思想,霍布斯把推理视为计算。20 世纪中叶,图灵研究计算理论,Shannon 分析逻辑电路,Newell 和 Simon 则把这些想法写成程序。符号主义由此成为可以实验的工程路线。
1976 年,Allen Newell 和 Herbert Simon 把这种立场表述为“物理符号系统假说”:物理符号系统拥有产生通用智能行为的充分且必要手段。其中的“充分”意味着,只要系统能表示并操作符号,就可能实现智能;“必要”则暗示人类认知本身也可以被理解为某种符号处理。
规则系统的强项是结构清楚。规则可以检查,推理步骤可以追踪,结论也容易解释。在边界明确、错误代价高的任务里,显式约束至今仍有价值。编译器、数据库查询、形式化验证和许多业务系统,都没有必要把判断全部交给神经网络。
代价也很直接:现实世界里的对象关系、常识、上下文和例外很难写全。规则一多,组合爆炸和规则冲突随之出现,更新还要依赖专家维护。专家系统可以在窄领域做得很好,却很难用同样的成本扩展到开放环境。
连接主义把知识分布在参数中
连接主义把智能看成大量简单单元之间的连接和权重共同产生的能力。知识不再主要以“如果 A 那么 B”的形式放在规则库里,而是分布在参数和中间表示中。
1943 年,Warren McCulloch 和 Walter Pitts 用数理逻辑描述理想化神经元。这项工作同时包含两种方向:关注神经元所实现的逻辑,可以通向符号计算;关注简单单元组成的网络,则可以通向连接主义。1949 年,Donald Hebb 用突触联系的增强解释学习,把“获得知识”改写成“调整连接”。
1957 年,Frank Rosenblatt 提出感知机。这个二分类器说明,机器的行为可以由数据和更新规则共同形成,不必全部逐条编码。媒体与资助者随后给它加上了远超技术能力的承诺。此后几十年的 AI 热潮里,这种从局部突破直接外推通用智能的做法反复出现。
感知机、反向传播、卷积网络和 Transformer 属于这条传统的不同阶段。它们共享一个基本想法:给定目标,通过调整参数降低误差,使模型从样本中形成对输入的表示和预测能力。
连接主义擅长处理图像、语音和文本等高维信号,也能从大量例子中学到难以逐条描述的模式。问题在于参数语义不透明,对分布外输入可能脆弱,精确的组合推理和可审计约束也不会自然出现。
工程上的分界很朴素:符号系统把更多知识放在程序和规则里,连接系统把更多知识交给参数与训练过程。两边都会用到表示、搜索、优化和反馈,差别在于哪些东西由人明确写出,哪些东西留给训练数据。
七十年间,几条线一直缠在一起
数据规模、计算资源、表示方法和评价任务一直在同时变化。任何只保留一条主线的年表,都会漏掉其中一半。
flowchart LR
    A[1940s-1950s\n逻辑与神经元模型] --> B[1956\nDartmouth 与符号主义兴起]
    A --> C[1957\n感知机与早期连接主义]
    B --> D[1970s-1980s\n专家系统与第一次寒冬]
    C --> D
    C --> E[1986\n反向传播重新进入主流]
    D --> F[1990s-2000s\n统计学习与概率模型]
    E --> F
    F --> G[2006\n深度信念网络与深层表示]
    G --> H[2012\nAlexNet 改写视觉基准]
    H --> I[2015\nResNet 解决深层优化瓶颈]
    I --> J[2017\nTransformer 扩展到大规模序列建模]
    J --> K[2020s\n大模型、自监督与对齐]
    A --> M[1957\nBellman 动态规划]
    M --> N[1988-1992\nTD 学习与 Q-learning]
    N --> O[2013-2015\nDQN 结合深度网络与强化学习]
    H --> O
    O --> P[2016-2020\nAlphaGo、AlphaGo Zero 与 MuZero]
    P --> K
    D --> L[持续存在\n符号约束、规划与知识表示]
    K --> L
图中的“统计学习时代”并不与连接主义对立。SVM、贝叶斯网络、隐马尔可夫模型和随机森林属于不同分支,神经网络也要做统计估计。1990 年代更实际的问题是:在小数据和有限算力下,哪种模型训练得更稳定、泛化得更可靠。
1950s-1960s:符号系统与感知机同时出现
1956 年夏天,John McCarthy、Marvin Minsky、Claude Shannon 和 Nathaniel Rochester 在 Dartmouth 学院组织研讨会。McCarthy 在提案中使用了“人工智能”这个名称。会议没有得出统一理论,却形成了早期 AI 的研究网络与问题设置。Newell 和 Simon 展示了能够证明《数学原理》中部分定理的 Logic Theorist;McCarthy 后来设计 Lisp;搜索、启发式和知识表示随之成为主线。
符号主义兴起时,Rosenblatt 的感知机也在 1950 年代末引发了巨大热情。感知机收敛定理保证,线性可分的样本可以学到一个分类超平面;同一个条件也划出了边界,单层感知机无法表达 XOR 这样的非线性函数。
1969 年,Minsky 和 Seymour Papert 在《Perceptrons》中系统分析了这些边界。这本书的严格结论针对单层感知机,但多层网络当时既没有成熟的训练方法,也没有支撑实验的数据和算力。对单层模型的批评因此被资助与学术环境扩大为对整条神经网络路线的怀疑。Rosenblatt 在 1971 年意外去世,未能看到多层网络后来的复兴。
1970s-1980s:专家系统证明了规则的价值,也暴露了规则的成本
1960 年代的通用问题求解器希望用一套通用搜索机制处理很多问题,但真实任务的搜索空间很快出现组合爆炸。研究者遂转向窄领域:与其追求一个知道一切的通用程序,不如先把医生、化学家或设备工程师的知识编成规则库。
Stanford 的 MYCIN 使用数百条产生式规则辅助诊断细菌感染并选择抗生素;DEC 的 XCON 使用数千条规则配置 VAX 计算机订单。MYCIN 把专家知识组织成了可解释的推理链,XCON 则减少了真实的配置和返工成本。专家系统确实成功过,只是这种成功很难离开原来的领域边界。
1973 年的 Lighthill 报告将英国 AI 研究的承诺与实际成果直接对照,尤其批评组合爆炸:玩具问题中可用的搜索,在状态数量指数增长时就失去可行性。英国随后大幅缩减相关资助,美国的机器翻译与通用 AI 计划也经历退潮,构成了第一次 AI 寒冬的重要背景。
1980 年代的专家系统热潮后,同类问题以更昂贵的方式再次出现。知识工程师需要长期访谈专家,而专家的直觉和情境判断并不总能写成“如果—那么”。规则数量增长后,局部修改可能引起远处冲突;产品线变化时,系统不会自动学习。专用 Lisp 机市场在通用工作站的价格和性能冲击下快速萎缩,日本第五代计算机计划也未实现原定目标。这些因素共同推动了 1980 年代末至 1990 年代初的第二次 AI 寒冬。
工程瓶颈之外,符号主义还遭遇了哲学质疑。1972 年,Hubert Dreyfus 从现象学出发,认为骑车、识别面孔、理解语境等能力依赖身体化、情境化和难以言说的默会知识。1980 年,John Searle 用“中文房间”论证区分了按规则操作符号与理解符号意义:语法操作本身不足以证明语义理解。这些论证没有在哲学上终结争论,却准确地揭示了“规则可执行”与“系统已理解”之间不能直接画等号。
1980s-2000s:连接主义复兴,统计学习兴起
反向传播也不是 1986 年凭空出现的。Seppo Linnainmaa 在 1970 年系统描述了反向模式自动微分,Paul Werbos 1974 年的博士论文讨论了它在神经网络中的用途。1986 年,David Rumelhart、Geoffrey Hinton 和 Ronald Williams 用一组清楚的实验展示多层网络怎样学到内部表示,反向传播由此进入主流。算法思想、实验说服力和研究社区在这里隔了十多年才汇合。
John Hopfield 的工作提供了另一个入口。1982 年的 Hopfield 网络把网络状态与能量函数联系起来,使记忆检索可以被理解为动力系统向稳定点演化。玻尔兹曼机又把统计力学中的能量、温度和采样带入神经网络。连接主义因此不再只是一个生物学隐喻,它与优化、概率和统计物理建立了数学联系。2024 年,Hopfield 与 Hinton 因人工神经网络的基础性发现和发明共同获得诺贝尔物理学奖。
反向传播的复兴没有立即带来深度学习的爆发。多层网络中的梯度可能在逐层回传时迅速衰减,当时的硬件无法支撑大规模实验,数字化数据也尚未形成后来的规模。模型越深,训练反而越难;理论表达能力与可训练性之间存在明显缺口。
1990 年代的条件更适合统计学习方法。Vladimir Vapnik 等人研究经验误差、模型容量与泛化的关系。支持向量机通过最大化分类间隔寻找稳定边界,核方法用隐式高维映射表达非线性关系。与此同时,隐马尔可夫模型大规模用于语音识别,概率图模型把因果假设、条件独立和不确定性编进图结构。
Vapnik 与 Alexey Chervonenkis 在 1960 年代开始发展的 VC 理论,试图对“一个模型族能表达多少种分类”给出可分析的容量刻画。1995 年,Corinna Cortes 和 Vapnik 的支持向量网络论文将这条理论线索变成实用分类算法。凸优化、最大间隔和小样本稳定性,使 SVM 在手写识别、文本分类和生物信息学中长期占据优势。那时的神经网络并非在思想上被宣判无效,而是在当时的数据与计算条件下,缺少同样可靠的训练结果。
这一时期,语音、机器翻译和信息检索逐渐从手写规则转向语料上的概率估计。研究问题也随之改变:给定已经观测的数据,哪个假设最可能成立,它对未见样本还能不能工作?
Fred Jelinek 等人在 IBM 推动的统计语音识别与机器翻译,使语言处理从手写语法逐步转向语料上的概率估计。Judea Pearl 在 1988 年的《Probabilistic Reasoning in Intelligent Systems》中系统化了贝叶斯网络,展示了符号结构与概率推理并不冲突:图中的节点和边可以表示条件依赖,数值则表示不确定性。2001 年,Leo Breiman 用“两种文化”区分了偏重解释数据生成机制的模型,与把系统当作黑箱、以预测精度为主的算法。这个分歧后来也进入了深度学习的可解释性争论。
数据规模也开始改变方法选择。2001 年,Michele Banko 和 Eric Brill 在自然语言歧义消解实验中把训练数据从百万级扩展到十亿级。多种算法都随数据增长而改善,算法之间的差距反而缩小。后来深度学习和大模型走的正是这条路:只要数据与计算继续扩展,能够吃下规模的通用方法就有机会超过为小数据精心设计的技巧。
2006-2017:深度学习把统计学习推向了规模化
1990 年代到 2000 年代前期,Hinton 仍在研究深层神经网络,但直接用反向传播训练多层网络往往不稳定。2006 年,Hinton、Simon Osindero 和 Yee-Whye Teh 提出对深度信念网络进行逐层贪心预训练:先学一层,再把该层的表示交给下一层,最后整体微调。论文报告的 MNIST 测试错误率为 1.25%,并且模型可以从学到的分布中生成手写数字样本。这套方法后来被更好的初始化、激活函数和优化技术取代,但它重新证明了“深层表示可以训练”,也让“深度学习”成为一个明确的研究方向。
2012 年的 AlexNet 构成了大规模工程转折点。Alex Krizhevsky、Ilya Sutskever 和 Hinton 用两块 GPU 训练深层卷积网络,把 ReLU、Dropout、数据增强与 ImageNet 的百万级图像结合起来。它在 ILSVRC 2012 上取得 15.3% 的 top-5 错误率,第二名是 26.2%。如此大的差距让计算机视觉社区很难再把端到端表示学习视为一次普通的榜单改进。
神经网络此时终于等到了足够的计算、数据和工程技巧,统计估计与表示学习也因此扩展到更大的模型。深度学习的成功离不开统计学习、数值优化、硬件并行和数据工程。
AlexNet 没有消除“网络越深越难优化”的问题。2015 年,Kaiming He 等人提出 ResNet,用跨层连接让模块学习残差。梯度和信息由此获得更短的传播路径,数十层乃至上百层卷积网络也变得容易训练。
2017 年,Transformer 又改变了序列模型的计算结构。RNN 需要按位置递推状态,自注意力则可以直接计算不同位置之间的关联,大幅改善并行训练。BERT、GPT 等大语言模型都建立在这一架构族上。模型的核心仍是统计估计与深层表示学习,只是数据、参数、计算和后训练流程被扩展到新的量级。
Richard Sutton 在 2019 年的《The Bitter Lesson》中概括了这段历史:长期来看,能随计算规模扩展的搜索和学习,往往超过人工编码的领域知识。围棋棋理、视觉手工特征、语音中的听觉机制模拟都曾有效;数据和计算继续增长后,通用方法留下了更大的改进空间。不过,数据、目标、网络架构和评价环境仍然来自人的设计,《The Bitter Lesson》并没有证明结构与知识从此无用。
深度学习没有离开统计学习
统计学习不等于浅层模型
在很多中文讨论里,“统计学习”常常专指 SVM、决策树、贝叶斯网络等 1990 年代常用方法,“深度学习”则专指多层神经网络。这个用法有历史背景,却不是严格的概念定义。
从方法机制看,深度学习至少包含以下统计问题:
- 用训练样本估计模型参数;
- 用损失函数定义预测目标;
- 用随机梯度下降近似求解高维优化问题;
- 用训练集、验证集和测试集评估泛化;
- 用正则化、数据增强、早停和权重衰减控制过拟合;
- 用概率分布或校准方法表达预测不确定性。
神经网络把统计估计和表示学习放在了同一个模型里,并用大规模计算承担更高的复杂度。经典统计学习通常依赖显式特征、较小样本和容易分析的模型结构;深度学习会连特征与任务映射一起学习。
“统计”一词有三种用法
“统计学习”这个词容易混淆,是因为“统计”至少可以指三件事:
- 数学工具:概率、估计、损失、梯度、泛化误差。这些工具深度学习大量使用。
- 模型传统:线性模型、核方法、概率图模型、树模型等经典统计学习方法。这些方法与深度网络在结构上不同,但不是互斥关系。
- 研究立场:优先追求可证明的泛化界、可解释假设或小样本效率。这与“把模型做大、用数据学表示”的深度学习工程路线存在取舍差异。
三种含义经常被压成一个“统计学派”,于是数学工具、模型家族和研究偏好混在了一起。
Hinton 的分歧不在“要不要统计”
Hinton 属于连接主义和深度学习传统,深度信念网络、玻尔兹曼机、反向传播和大语言模型却都建立在概率、优化和统计估计之上。他质疑的是人工特征、显式规则和小规模模型能否承载足够复杂的智能,而非统计这个数学框架。
把深度学习看成统计学习在大规模神经网络上的一条实现路线,更符合它实际使用的数学工具。研究社区、评价指标和研究风格当然会冲突,数学上却不存在一道把两者隔开的边界。
网络到底有什么差别
“深度神经网络、卷积神经网络、残差网络”经常被并列提问,原因是它们的命名不在同一层。DNN 是总称或宽泛描述,CNN 是一种连接结构,ResNet 是一种让深层网络更容易优化的架构设计。
flowchart TB
    DNN[DNN / 深度神经网络\n多层可学习变换]
    MLP[MLP / 全连接网络\n每层广泛连接]
    CNN[CNN / 卷积网络\n局部连接 + 权重共享]
    RNN[RNN / LSTM\n隐藏状态按序列传递]
    TRANS[Transformer\n自注意力建立位置间关系]
    BLOCK[残差块\n输入加残差]
    RES[ResNet\n大量残差块堆叠的深层 CNN]

    DNN --> MLP
    DNN --> CNN
    DNN --> RNN
    DNN --> TRANS
    CNN --> BLOCK
    BLOCK --> RES
DNN 只说明网络很深
DNN(Deep Neural Network)通常指包含多个可学习层的神经网络。最简单的 DNN 是多层感知机(MLP):每一层的神经元与下一层广泛连接,适合结构化特征、分类和回归等任务。
DNN 只说明网络包含多个可学习层,不说明输入有没有空间结构,也不规定序列信息怎样传递。CNN、RNN 和 Transformer 都可能是 DNN。
CNN 把空间先验写进连接方式
卷积神经网络(CNN)利用局部连接和权重共享。一个卷积核只看局部区域,同一个卷积核可以在图像不同位置复用。这样做相当于把“邻近像素更有关系、同一种局部模式可以出现在不同位置”的先验写进了结构。
局部连接和权重共享减少了参数数量,也把空间归纳偏置写进网络。模型先学习边缘、纹理和局部形状,再逐层组合出更高层特征。AlexNet、VGG、Inception 和 ResNet 都是 CNN 家族的代表。
RNN / LSTM:通过状态处理顺序
循环神经网络(RNN)把前一时刻的隐藏状态传给下一时刻,适合处理具有顺序关系的数据。LSTM 和 GRU 通过门控机制缓解长序列中的信息遗忘与梯度问题。
RNN 的结构表达了“当前处理依赖之前状态”的假设,但这种递推也限制了训练并行度。Transformer 用自注意力直接计算序列中不同位置之间的关系,因此在大规模训练中更容易利用 GPU 和 TPU 的并行能力。
ResNet 解决深层网络的优化问题
普通深层网络希望每一组层直接学习一个复杂映射 H(x)。ResNet 把目标改成学习残差 F(x) = H(x) - x,然后通过跳跃连接输出 F(x) + x。如果新增层暂时没有学到有用变换,网络至少可以保留输入信息,梯度也拥有更直接的传播路径。
经典 ResNet 是带残差块的深层 CNN。CNN 利用图像的空间结构,残差连接负责缓解深层网络的优化困难。两个名称描述的是同一个模型的不同方面。
| 名称 | 主要结构假设 | 解决的核心问题 | 常见场景 | 关系 |
|---|---|---|---|---|
| DNN / MLP | 多层可学习变换 | 从特征到输出的非线性映射 | 表格、分类、回归 | 宽泛总称,MLP 是典型实例 |
| CNN | 局部连接、权重共享 | 利用空间局部性并减少参数 | 图像、视频、局部模式 | DNN 的一种结构 |
| RNN / LSTM | 隐藏状态递推 | 表达序列顺序与历史状态 | 语音、时间序列、早期 NLP | DNN 的另一种结构 |
| Transformer | 自注意力、位置编码 | 建立长距离依赖并提高并行度 | NLP、多模态、视觉 | 与 CNN、RNN 不同的结构路线 |
| ResNet | 跳跃连接、残差学习 | 让很深的网络更容易优化 | 视觉骨干网络 | 常见形式是深层 CNN |
选择网络时,先看数据的结构和训练瓶颈。空间局部性强时 CNN 有先验优势;顺序状态重要但规模有限时 RNN 仍然有意义;需要长距离依赖和大规模并行时 Transformer 更常见;网络已经很深、优化出现退化时,残差连接是结构性修复手段。
朱松纯和 Hinton 分歧在哪里
两人的分歧集中在任务、世界模型和智能能力的来源,并非统计学习与深度学习能否共存。
Hinton 更相信从数据中学习分布式表示
Hinton 的核心贡献属于连接主义路线:让多层神经网络通过训练形成分布式表示,并利用规模化数据、计算和优化获得能力。这个路线认为,许多视觉、语言和概念结构不必先由人写成符号规则;只要训练目标、数据和模型容量合适,网络可以学到有用的内部表示。
监督学习的标签、自监督学习的预测目标、强化学习的奖励,都在给模型施加任务约束。Hinton 路线的特点,是让更多具体知识在训练中形成,而不是预先写成可读规则。
朱松纯更强调“大任务”和认知结构
朱松纯的公开研究介绍同时列出统计建模与计算、机器学习、计算机视觉、认知科学和自主机器人。他并不是“反统计”的研究者。其批评对象主要是把大量数据和一个狭窄损失函数绑定起来,训练出只能完成单一任务、难以解释和迁移的模型。
他提出的“小数据、大任务”把任务、价值、物理常识、因果关系、社会交互和身体行动都纳入智能。视觉系统除了判断像素属于哪个类别,还要理解物体能否支撑、怎样使用、为什么移动,以及其他主体想做什么。识别准确率无法覆盖这些能力,结构化世界模型、认知推理和机器人交互因此占据了更重要的位置。
这套批评针对学习目标和模型边界。朱松纯早期大量使用统计建模,也没有否定神经网络;他认为“大数据、小任务”不足以单独通向通用智能。
两种研究路线的侧重点
| 维度 | Hinton 式深度学习路线 | 朱松纯强调的认知路线 |
|---|---|---|
| 能力来源 | 数据、梯度优化、模型规模和分布式表示 | 任务、价值、环境交互、物理与社会常识 |
| 典型问题 | 如何从大规模样本中学到通用表示 | 如何从少量经验完成跨任务、因果和具身推理 |
| 知识形态 | 主要分布在参数与隐空间中 | 更重视结构化、可解释、可模拟的知识 |
| 优势 | 感知、语言、模式归纳和规模化能力 | 小样本泛化、任务迁移、世界理解和行动闭环 |
| 风险 | 幻觉、分布外脆弱、推理链难审计 | 建模成本高、任务设计难、系统工程复杂 |
这些模块可以放进同一个系统:神经网络负责感知和候选生成,世界模型负责模拟,符号系统或程序执行器负责约束和验证,强化学习负责长期行为优化。两条路线争论的是,训练得到的表示能否支撑通用任务,还要补上多少结构与环境交互。
强化学习应该放在哪里
强化学习描述序列决策问题和反馈方式。智能体观测状态、选择动作、收到奖励,再学习怎样提高长期回报。价值函数或策略可以存成一张表,也可以由线性模型、决策树或深度神经网络表示。它有自己的历史传统,却没有规定知识必须采取符号还是连接权重的形式。
从 Bellman 方程到时序差分学习
1957 年,Richard Bellman 在动态规划中建立了序列最优化的递归结构。Bellman 方程的核心可以写成:一个状态的价值,等于当前奖励与后续状态价值的折扣期望。它把一个看似需要枚举整条未来轨迹的问题,拆成当前决策与子问题。后来的价值迭代、策略迭代和 Q-learning,都可以看到这个递归结构。
1959 年,Arthur Samuel 在 IBM 发表跳棋程序研究。程序会利用对弈经验调整局面特征的权重,并通过记忆已见局面提高搜索效率,而非始终执行同一个固定评分函数。论文标题直接使用了“Machine Learning”。符号搜索、人工特征和经验更新参数,很早就出现在同一个系统里。
Bellman 的方法通常假设已知环境转移与奖励模型,而真实智能体往往只能经历一步步的交互。1988 年,Richard Sutton 系统化了时序差分学习(Temporal-Difference Learning):不必等待一整局结束,可以用“当前奖励 + 下一状态的估计”修正当前估计。它将动态规划的自举更新与蒙特卡方法的经验采样联系起来。
Christopher Watkins 在 1989 年的博士论文中提出 Q-learning。1992 年,Watkins 与 Peter Dayan 给出了离散情形下的收敛结果:在状态—动作对被反复采样等条件下,Q 值可收敛到最优动作价值。Q-learning 是无模型方法:智能体不需先建立一份完整的环境转移表,而是从动作后果中逐步学习每个状态下哪个动作更有价值。
1992 年,Gerald Tesauro 用 TD 方法训练 TD-Gammon,将神经网络的函数逼近与自我对弈结合起来,达到当时的高水平西洋双陆棋棋力。1998 年,Sutton 和 Andrew Barto 出版《Reinforcement Learning: An Introduction》,将智能体、环境、状态、动作、奖励、策略和价值函数组织成延续至今的学科框架。
DQN:用深度网络近似 Q 函数
表格式 Q-learning 遇到高维输入时会失效:仅一帧 Atari 画面就可以对应极多像素组合,不可能为每个状态单独存一行 Q 值。2013 年预印本、2015 年《Nature》论文中,DeepMind 的 DQN 用卷积神经网络直接从屏幕像素估计动作价值。经验回放打破连续样本的强相关性,目标网络降低了“一边学习、一边改写目标”带来的不稳定。
DQN 把两条已有线索接在了一起:一条从 Bellman 方程、TD 学习延伸到 Q-learning,另一条从反向传播延伸到 CNN。它是深度学习和强化学习的组合。
AlphaGo 到 MuZero:学习、搜索与模型的再组合
2016 年,AlphaGo 以 4:1 击败李世石。策略网络缩小候选落子范围,价值网络估计局面,蒙特卡罗树搜索向未来展开,监督学习与自我对弈强化学习提供不同阶段的训练信号。第二局第 37 手成为标志,因为学到的策略分布给出了人类棋谱中极少见、事后证明有效的选择。
2017 年的 AlphaGo Zero 不再使用人类棋谱训练,从规则和自我对弈开始,并在论文实验中以 100:0 击败先前公开的冠军版 AlphaGo。“Zero”指零人类对局样本,不是零先验;围棋规则、胜负奖励、网络结构和树搜索仍由人设计。
MuZero 在 2019 年公布预印本,2020 年发表于《Nature》。它不需要预先获得围棋、国际象棋、将棋或 Atari 的完整转移动力学,而是学习一个服务于规划的潜在模型,用来预测奖励、价值和策略。它缺少的是人提供的环境动力学模型,并非对游戏规则一无所知。
RLHF:奖励信号进入大模型后训练
大语言模型的预训练通常使用自监督目标:根据上下文预测被遮盖的词或下一个 token。这会学到语言和世界知识中的大量统计结构,却不直接等于“按用户意图回答”。预训练文本中可能同时包含高质量解释、错误内容、对话片段和广告,下一词预测并没有为这些内容提供明确的价值排序。
RLHF 将人类对多个候选回答的偏好比较转换为可学习的奖励模型,再用强化学习调整语言模型的输出分布。2017 年的《Deep Reinforcement Learning from Human Preferences》展示了从成对偏好中学习奖励函数的可行性。2022 年的 InstructGPT 把人工示范监督微调、人类排序训练奖励模型、PPO 优化策略串成了大模型对齐的经典流程。
预训练、奖励模型和策略优化都在估计参数,RLHF 改变的是反馈来源和优化目标。今天的大模型后训练也不限于 RLHF,偏好优化、可验证奖励和其他对齐方法都能接在自监督预训练之后。
今天的系统已经在混合这些路线
连接主义在感知和语言任务上取得了压倒性的工程成果,但它没有自动解决所有智能问题。模型是否真正理解世界、能否可靠地进行组合泛化、能否在新环境中行动、能否让结论可审计,仍然需要额外的结构和评价方法。
符号方法也没有消失。程序、搜索、规划、知识图谱、形式化证明、数据库和约束求解器仍然在需要确定性与可验证性的地方发挥作用。神经符号系统的基本做法,是让神经模型处理感知和模糊匹配,让符号或程序模块处理精确约束、组合推理和验证。
1988 年,Jerry Fodor 和 Zenon Pylyshyn 对早期连接主义提出“系统性”挑战:如果一个人能理解“甲爱乙”,通常也能理解“乙爱甲”,因为思维中的对象和关系可以重组。分布式向量表示如何稳定地支持这种组合性,一直是神经网络理论与实验的重要问题。大模型扩展了组合能力的边界,却没有使精确推理、一致性和分布外稳定性自动变成保证。
AlphaGeometry 是一个清楚的例子。神经语言模型生成可能有用的辅助构造,符号推理器再生成并检查严格的几何证明。前者压缩庞大的候选空间,后者保证每一步都成立。学习、生成、搜索和校验被分给了不同模块。
Daniel Kahneman 普及的“系统 1 / 系统 2”常被借来描述这种分工:神经模型负责快速的模式联想,符号搜索与程序执行负责较慢的明确推理。这个类比不能当作严格的认知等同,神经网络可以执行多步计算,符号系统也会使用启发式并处理不完全信息。工程上有用的部分,是把候选生成与约束检查分开。
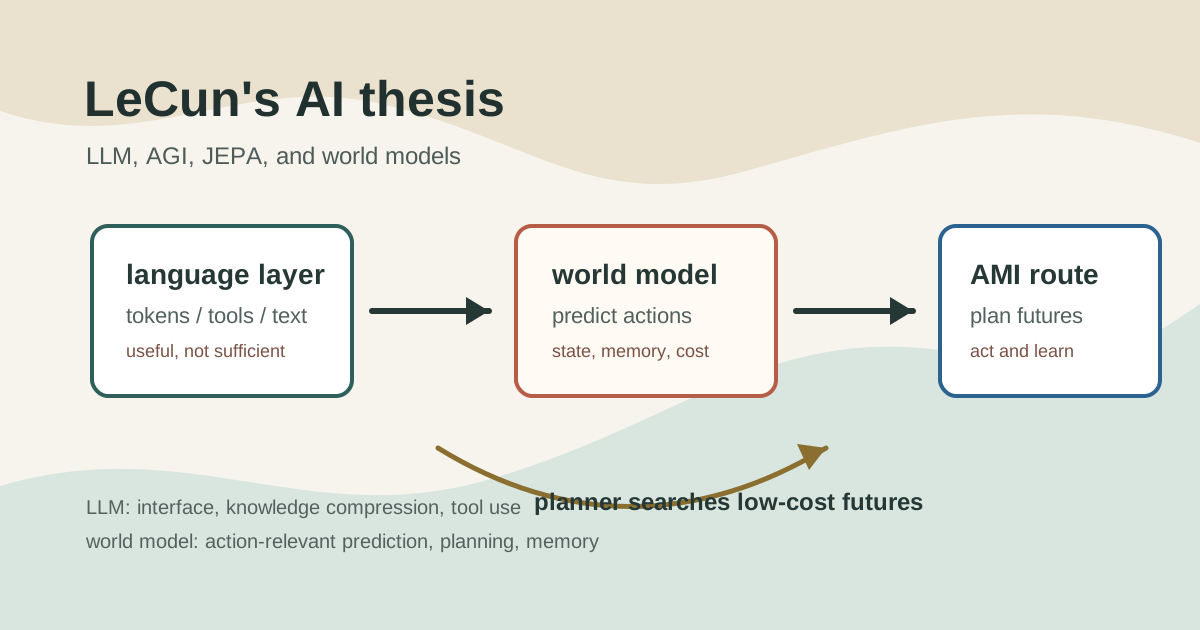
Yann LeCun 在 2022 年提出的自主机器智能架构,把世界模型、感知、行动、目标和记忆放进同一个闭环。输入到输出的静态映射无法覆盖预测行动后果、根据目标规划和从环境反馈中修正世界模型。这类系统自然会同时使用连接主义、强化学习和结构化知识。
结语
“符号主义还是连接主义”适合讨论知识如何表示;“统计学习还是深度学习”适合讨论历史传统、模型规模与研究风格,但不是严格的互斥分类;“CNN 还是 ResNet”适合讨论网络结构与优化机制;“监督学习还是强化学习”适合讨论反馈信号。
七十年的争论没有选出一个永远正确的学派,倒是留下了一组更实用的问题:任务是什么,数据从哪里来,反馈怎样定义,知识放在哪里,模型利用了什么先验,结果如何验证。把这些问题分开,许多看似冲突的名词就能落回各自的位置。
术语速查表
| 看到的词 | 先判断它在描述什么 | 一句话解释 |
|---|---|---|
| AI | 研究领域 | 让机器完成通常需要智能的任务 |
| 机器学习 | 方法类别 | 从数据或交互中学习参数和规律 |
| 统计学习 | 理论与方法传统 | 关注样本、估计、泛化和不确定性 |
| 连接主义 | 智能观与表示路线 | 能力从神经元连接和分布式表示中形成 |
| 深度学习 | 模型与训练方法 | 用多层神经网络学习表示 |
| 监督学习 | 训练信号 | 从输入—标签样本中学习 |
| 自监督学习 | 训练信号 | 从数据自身构造预测目标 |
| 强化学习 | 训练信号 | 通过动作后的奖励学习策略 |
| DNN | 网络深度的宽泛称呼 | 多层神经网络,不限定具体连接结构 |
| CNN | 网络结构 | 用局部连接与权重共享处理空间结构 |
| RNN / LSTM | 网络结构 | 用状态递推处理序列 |
| Transformer | 网络结构 | 用自注意力建立序列位置间关系 |
| ResNet | 架构设计 | 用残差连接让深层网络更容易优化 |
参考资料
- 朱松纯:北京大学智能学院个人介绍
- 朱松纯:计算机视觉应以大任务为导向
- 朱松纯:浅谈人工智能:现状、任务、构架与统一
- Connectionism - Stanford Encyclopedia of Philosophy
- Newell and Simon, Computer Science as Empirical Inquiry: Symbols and Search
- The Chinese Room Argument - Stanford Encyclopedia of Philosophy
- Fodor and Pylyshyn, Connectionism and Cognitive Architecture
- Rumelhart, Hinton and Williams, Learning representations by back-propagating errors
- Cortes and Vapnik, Support-vector networks
- Judea Pearl, Probabilistic Reasoning in Intelligent Systems
- Leo Breiman, Statistical Modeling: The Two Cultures
- Banko and Brill, Scaling to Very Very Large Corpora for Natural Language Disambiguation
- Hinton, Osindero and Teh, A Fast Learning Algorithm for Deep Belief Nets
- Krizhevsky, Sutskever and Hinton, ImageNet Classification with Deep Convolutional Neural Networks
- He et al., Deep Residual Learning for Image Recognition
- Vaswani et al., Attention Is All You Need
- The Nobel Prize in Physics 2024: Hopfield and Hinton
- Richard Sutton, The Bitter Lesson
- Richard Bellman, Dynamic Programming
- Arthur Samuel, Some Studies in Machine Learning Using the Game of Checkers
- Sutton and Barto, Reinforcement Learning: An Introduction
- Watkins and Dayan, Q-learning
- Mnih et al., Human-level control through deep reinforcement learning
- Silver et al., Mastering the game of Go with deep neural networks and tree search
- Silver et al., Mastering the game of Go without human knowledge
- Schrittwieser et al., Mastering Atari, Go, chess and shogi by planning with a learned model
- Christiano et al., Deep Reinforcement Learning from Human Preferences
- Ouyang et al., Training language models to follow instructions with human feedback
- Trinh et al., Solving olympiad geometry without human demonstrations
- Yann LeCun, A Path Towards Autonomous Machine Intelligence