MySQL 存储引擎 InnoDB 技术内幕

前言
本文以 MySQL 8.4 LTS 为当前版本基线,梳理 InnoDB 的内存结构、磁盘结构、日志、锁和事务机制。书籍中的旧版本实现仍有助于理解设计演进,但凡涉及默认值、文件布局和 SQL 能力,均以 MySQL 8.4 官方文档为准。
InnoDB 的性能不能脱离工作负载讨论。OLTP 写入、分析型扫描、热点索引和批量导入对缓冲池、日志与锁的压力完全不同,可靠的判断来自可复现测试,而不是脱离硬件和配置的吞吐数字。
Change Buffer 的前身是 Insert Buffer。它把非唯一辅助索引的部分变更延后合并,目标是减少随机 I/O;它不是通用写缓存,也不参与聚簇索引的修改。
MySQL 体系结构和存储引擎
定义数据库和实例
- 数据库:物理操作系统文件或其他形式文件类型的集合。
- 实例:操作系统后台进程(线程和一堆共享内存)。
- 存储引擎:基于表而不是基于库的,所以一个库可以有不同的表使用不同的存储引擎。
InnoDB 把表、索引、undo 等对象组织在逻辑表空间中,并通过数据文件把这些结构落到文件系统。存储引擎接口位于 MySQL Server 层与具体数据组织方式之间,因此同一实例可以同时使用不同引擎。
事务不是数据库与文件系统的唯一区别。数据库还提供结构化查询、索引、并发控制、约束、恢复和优化器等能力。即使是只读查询,也可能需要一致性视图来避免读取到不一致的中间状态。
NDB Cluster 是 shared-nothing 的分布式存储引擎,数据可分布在多个数据节点上;它与 InnoDB 的单机存储结构和恢复路径不同,不能直接套用本文章节中的机制。
InnoDB 的存储引擎
InnoDB 是 transactional-safe 的 MySQL 存储引擎。
InnoDB 存储引擎概述
InnoDB 的核心结构可以概括为后台线程、内存池和持久化文件。吞吐量与容量上限取决于硬件、配置、表结构和工作负载,不适合用脱离环境的固定数字描述。

后台线程包括
master thread

早期版本把大量周期性维护工作集中在 Master Thread 中。现代 InnoDB 已把 purge、page cleaner 和 I/O 等职责拆分给专门线程,因此旧书里的“每秒循环”和固定刷新数量只适合解释历史实现,不能当作 MySQL 8.4 的调度模型。
IO thread
InnoDB 使用异步 I/O 线程处理数据页的读写请求,避免后台任务在单次磁盘操作上同步阻塞。
purge thread
Purge 线程清理不再被活跃 ReadView 需要的旧记录版本,并回收相应的 undo 记录。
page cleaner thread
Page Cleaner 线程负责脏页刷新,根据 checkpoint 压力、脏页比例和 I/O 能力调节写回节奏。
内存
要懂得看内存要懂得看各种监控:


排查锁等待、事务、I/O 和缓冲池状态时,可以执行 SHOW ENGINE INNODB STATUS。下面保留一段历史输出作为字段示例;数值只代表采样时刻,不能直接用于容量结论。
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64Type Name Status InnoDB
===================================== 2022-03-05 16:04:44 0x70000dda3000 INNODB MONITOR OUTPUT
===================================== Per second averages calculated from the last 0 seconds
----------------- BACKGROUND THREAD
----------------- srv_master_thread loops: 6 srv_active, 0 srv_shutdown, 110008 srv_idle srv_master_thread log flush and writes:
0
---------- SEMAPHORES
---------- OS WAIT ARRAY INFO: reservation count 2 OS WAIT ARRAY INFO: signal count 2 RW-shared spins 0, rounds 0, OS waits 0 RW-excl spins
0, rounds 0, OS waits 0 RW-sx spins 0, rounds 0, OS waits 0 Spin
rounds per wait: 0.00 RW-shared, 0.00 RW-excl, 0.00 RW-sx
------------ TRANSACTIONS
------------ Trx id counter 6151 Purge done for trx's n:o < 6149 undo n:o < 0 state: running but idle History list length 0 LIST OF
TRANSACTIONS FOR EACH SESSION:
---TRANSACTION 421658550605264, not started 0 lock struct(s), heap size 1128, 0 row lock(s)
---TRANSACTION 421658550604472, not started 0 lock struct(s), heap size 1128, 0 row lock(s)
---TRANSACTION 421658550603680, not started 0 lock struct(s), heap size 1128, 0 row lock(s)
---TRANSACTION 421658550602888, not started 0 lock struct(s), heap size 1128, 0 row lock(s)
---TRANSACTION 421658550602096, not started 0 lock struct(s), heap size 1128, 0 row lock(s)
---TRANSACTION 421658550601304, not started 0 lock struct(s), heap size 1128, 0 row lock(s)
-------- FILE I/O
-------- I/O thread 0 state: waiting for i/o request (insert buffer thread) I/O thread 1 state: waiting for i/o request (log thread) I/O
thread 2 state: waiting for i/o request (read thread) I/O thread 3
state: waiting for i/o request (read thread) I/O thread 4 state:
waiting for i/o request (read thread) I/O thread 5 state: waiting for
i/o request (read thread) I/O thread 6 state: waiting for i/o request
(write thread) I/O thread 7 state: waiting for i/o request (write
thread) I/O thread 8 state: waiting for i/o request (write thread) I/O
thread 9 state: waiting for i/o request (write thread) Pending normal
aio reads: [0, 0, 0, 0] , aio writes: [0, 0, 0, 0] , ibuf aio reads:,
log i/o's:, sync i/o's: Pending flushes (fsync) log: 0; buffer pool: 0
937 OS file reads, 467 OS file writes, 58 OS fsyncs
0.00 reads/s, 0 avg bytes/read, 0.00 writes/s, 0.00 fsyncs/s
------------------------------------- INSERT BUFFER AND ADAPTIVE HASH INDEX
------------------------------------- Ibuf: size 1, free list len 0, seg size 2, 0 merges merged operations: insert 0, delete mark 0,
delete 0 discarded operations: insert 0, delete mark 0, delete 0 Hash
table size 34679, node heap has 0 buffer(s) Hash table size 34679,
node heap has 0 buffer(s) Hash table size 34679, node heap has 0
buffer(s) Hash table size 34679, node heap has 0 buffer(s) Hash table
size 34679, node heap has 0 buffer(s) Hash table size 34679, node heap
has 0 buffer(s) Hash table size 34679, node heap has 2 buffer(s) Hash
table size 34679, node heap has 6 buffer(s)
0.00 hash searches/s, 0.00 non-hash searches/s
--- LOG
--- Log sequence number 19606903 Log buffer assigned up to 19606903 Log buffer completed up to 19606903 Log written up to
19606903 Log flushed up to 19606903 Added dirty pages up to
19606903 Pages flushed up to 19606903 Last checkpoint at
19606903 23 log i/o's done, 0.00 log i/o's/second
---------------------- BUFFER POOL AND MEMORY
---------------------- Total large memory allocated 0 Dictionary memory allocated 390927 Buffer pool size 8192 # 注意:意味着总共有8192个页(通常是16k一页) Free buffers 0 # 注意:Free List 为 0
7040 Database pages 1144 Old database pages 402 Modified db pages # 注意:缓冲池里面有7040个数据(库)页,这就是 LRU list 的总长度
0 Pending reads 0 Pending writes: LRU 0, flush list 0, single
page 0 Pages made young 20, not young 0 # 注意:Made Young 意味着从 LRU 的队尾淘汰了一页,加入 new 里。这里 Made Young 发生了 20 次。
0.00 youngs/s, 0.00 non-youngs/s Pages read 914, created 233, written 351
0.00 reads/s, 0.00 creates/s, 0.00 writes/s No buffer pool page gets since the last printout Pages read ahead 0.00/s, evicted without
access 0.00/s, Random read ahead 0.00/s LRU len: 1144, unzip_LRU len:
0 I/O sum[0]:cur[0], unzip sum[0]:cur[0]
-------------- ROW OPERATIONS
-------------- 0 queries inside InnoDB, 0 queries in queue 0 read views open inside InnoDB Process ID=153, Main thread ID=0x70000d0ec000
, state=sleeping Number of rows inserted 16568, updated 0, deleted 0,
read 16568
0.00 inserts/s, 0.00 updates/s, 0.00 deletes/s, 0.00 reads/s Number of system rows inserted 0, updated 315, deleted 0, read 6557
0.00 inserts/s, 0.00 updates/s, 0.00 deletes/s, 0.00 reads/s
---------------------------- END OF INNODB MONITOR OUTPUT
============================
Per second averages calculated from ... 表示速率字段使用的采样窗口。LRU len 是普通 LRU 链表长度,unzip_LRU len 用于跟踪压缩页对应的解压页。大范围扫描可能把工作集带入 old 区并影响命中率,但不能用固定的 95% 阈值断言性能好坏,应结合物理读、延迟和负载阶段判断。
History list length 表示仍待 purge 的 undo log 链表长度,不等于 undo 文件数或事务数。该值持续增长通常意味着 purge 跟不上,或存在长期活跃的 ReadView。
缓冲池
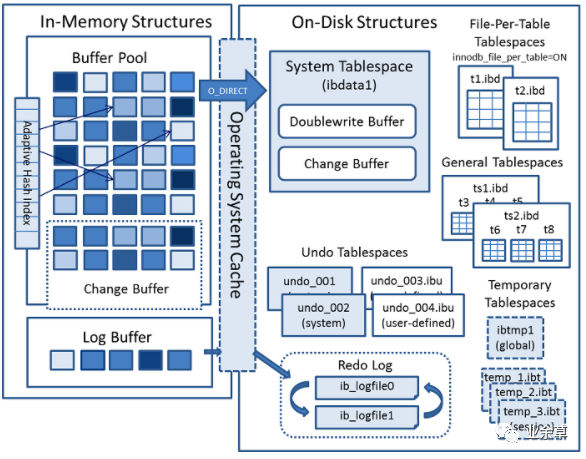
Buffer Pool 缓存表和索引页,使多数读写先在内存页上完成。页被修改后成为脏页,事务是否已持久化由 redo 决定,脏页何时写回数据文件则由后台刷新和 checkpoint 推进共同控制。这两条路径不能混为一谈。
innodb_buffer_pool_instances 用于把缓冲池划分为多个实例,以减少并发访问时的争用。旧版本的 innodb_additional_mem_pool_size 已不属于 MySQL 8.4 的内存模型,相关控制结构由 InnoDB 自行管理。
LRU List、Free List 和 Flush List

- Free List 管理尚未承载数据页的空闲缓冲块。读取新页时优先从这里分配。
- LRU List 管理已经驻留在缓冲池中的页。新读入页先进入 old 区,经再次访问后才可能进入 new 区,以降低大范围扫描对热点页的冲击。
- Flush List 按修改时对应的 LSN 组织脏页,供后台刷新和 checkpoint 推进使用。
同一个脏页既是已驻留页,因此属于 LRU List;又需要写回磁盘,因此也会被 Flush List 跟踪。Free List 管理的是尚未装入数据的缓冲块,不是另一类脏页。
redo log buffer
事务修改页时会生成 redo,并先写入 redo log buffer。redo 从内存写到操作系统,再持久化到存储设备;事务提交时需要完成到哪一步,由 innodb_flush_log_at_trx_commit 决定。Page Cleaner 负责刷新数据页,不负责把 redo log buffer 写入 redo 文件。
redo buffer 会在事务提交、周期性后台写出以及缓冲空间压力增大时被写出。日志写出和脏页刷新可以并行发生,但二者解决的问题不同:前者保护已提交修改,后者缩短恢复距离并释放可复用的 redo 空间。
checkpoint 技术

InnoDB 使用 WAL(Write-Ahead Logging):与某个数据页修改对应的 redo 必须先于该数据页写入持久化存储。事务提交是否要求 redo 立即 fsync,取决于持久化配置;这不意味着提交时必须把对应脏页写回表空间。
Checkpoint 记录一个已经能够由数据文件状态承接的日志位置,并推动较老的脏页写回。崩溃恢复从 checkpoint 附近开始扫描 redo,把已经持久化但尚未反映到数据文件中的修改重新应用。Checkpoint 不是把 redo “合并进”表空间,也不等同于一次全量刷脏。
LSN(Log Sequence Number)把 redo 生成、日志写出、页修改和 checkpoint 位置放在同一递增序列上。redo 容量紧张、脏页比例升高、后台周期任务以及正常关闭,都可能推动 checkpoint;具体刷新量由 InnoDB 根据 I/O 能力和当前负载调节。
InnoDB 关键特性
Change Buffer
Change Buffer 缓存非唯一辅助索引页的部分变更。当目标索引页不在 Buffer Pool 中时,InnoDB 可以先记录变更,等该页后来因读取或后台处理进入内存时再合并,从而减少随机读。唯一索引需要立即检查唯一性,聚簇索引又承载整行数据,因此不走这条路径。MySQL 8.4 官方文档
Change Buffer 的内容既有内存表示,也会持久化在系统表空间中,所以重启后仍可继续合并。它不是 LSM Tree,也不会替代 redo;所有索引页修改仍受 redo 和 checkpoint 机制保护。
MySQL 8.4 的 innodb_change_buffering 默认值是 none。是否启用应由存储介质、辅助索引写入比例和缓存命中情况决定,不能把旧版本默认开启时的经验直接套到 8.4。
Doublewrite Buffer
数据页写入可能在完成前中断,留下 torn page。InnoDB 刷新脏页时先把页副本写入 doublewrite 文件,再写入各自的数据文件;启动恢复若发现数据文件中的页损坏,可以先从 doublewrite 副本取得完整页,再应用 redo。MySQL 8.4 官方文档
MySQL 8.4 默认创建两个 doublewrite 文件。只要数据完整性重要,就应保持 innodb_doublewrite=ON。只有存储设备明确提供受支持的原子写能力,或执行可丢弃数据的基准测试时,关闭它才有合理前提。
自适应哈希索引(AHI)
AHI 根据 B+Tree 索引页的访问模式,为热点等值查找建立内存哈希入口。它由 InnoDB 自动创建和维护,适合重复度高的等值访问;写密集或并发争用明显的负载可能得不到收益。
MySQL 8.4 中 innodb_adaptive_hash_index 默认关闭。需要启用时,应以命中率、维护开销和争用指标为依据,而不是把它视为必开的通用加速项。MySQL 8.4 官方文档
异步 I/O 与邻接页刷新
InnoDB 使用异步 I/O 让后台读写不必串行等待。邻接页刷新主要用于降低旋转磁盘的寻道成本;SSD 上通常收益较小,可以结合 innodb_flush_neighbors 和实际设备特征进行测试。
启动、关闭与恢复
正常关闭会推进日志和脏页处理,崩溃启动则使用 redo 完成恢复。innodb_force_recovery 不是“关闭自动修复”的日常选项,而是数据库无法正常启动时用于抢救数据的应急模式。恢复级别越高,跳过的内部处理越多,造成永久损坏的风险也越高;应从 1 开始逐级尝试,只为导出数据而使用。MySQL 8.4 官方文档
文件
参数格式
1 | |
要注意有些参数不能被修改,或者只能在会话中更改。
binlog 格式
MySQL 8.4 默认使用 ROW 格式记录 binlog。它记录行变更结果,减少非确定性函数、触发器和并发执行顺序在复制端造成差异的风险;是否会发生丢失更新仍由事务隔离、锁和应用写法决定。
表空间

InnoDB 允许多张表使用共享表空间,也支持 file-per-table 和通用表空间。
innodb_file_per_table=ON 时,新建表通常拥有独立的 .ibd 文件,用来保存该表的数据和索引。系统表空间、undo 表空间、临时表空间和 redo 日志各自承担不同职责,不能把未进入 .ibd 的内容统称为“仍在默认表空间”。
redo log file
MySQL 8.4 把 redo 文件放在数据目录下的 #innodb_redo 目录中,文件使用 #ib_redoN 命名,备用文件带 _tmp 后缀。innodb_redo_log_capacity 控制总容量并支持在线调整;InnoDB 通常维持普通文件与备用文件合计 32 个,每个目标大小约为总容量的 1/32。MySQL 8.4 官方文档
早期版本常见的 ib_logfile0、ib_logfile1 和镜像日志组不再代表 8.4 的文件布局。redo 仍在有限容量内循环使用;当可复用空间不足时,InnoDB 必须加快脏页刷新和 checkpoint 推进。
redo block 的 512 字节布局不能直接推导出所有存储设备都提供原子写保证。日志完整性还依赖校验、写入协议以及底层存储对写入和刷新语义的实现。
表
总是存在主键
InnoDB 优先使用显式主键作为聚簇索引;没有主键时,选择第一个全部列均为 NOT NULL 的唯一索引;两者都没有时,生成隐藏的行 ID。聚簇索引的叶子记录保存整行数据,因此主键选择会影响辅助索引大小与插入局部性。
tablespace 的结构

tablespace 下分为 段 segment、区 extent 和页 page。
表空间内部按段、区和页组织。现代 MySQL 默认使用独立 undo 表空间;purge 清理旧版本记录,undo truncate 才负责回收可截断 undo 表空间的物理空间。
行
MySQL 8.4 的默认行格式是 DYNAMIC,由 innodb_default_row_format 控制;也可以通过 CREATE TABLE 或 ALTER TABLE 的 ROW_FORMAT 显式指定。MySQL 8.4 官方文档

hexdump -C -v mytest.ibd > /home/zhoujy/mytest.txt,找到 supremum 这一行。
左边的区是地址空间,每个地址空间间隔 16字节。
中间的空间是内容,16个格子,每个格子是2个16进制数,即一个字节
右边的空间是对内容的人类可读解释。
0000c070 73 75 70 72 65 6d 75 6d 03 02 02 01 00 00 00 10 |supremum…|
0000c080 00 25 00 00 00 03 b9 00 00 00 00 02 49 01 82 00 |.%…I…|
0000c090 00 01 4a 01 10 61 62 62 62 62 63 63 63 03 02 02 |…J…abbbbccc…|
0000c0a0 01 00 00 00 18 00 23 00 00 00 03 b9 01 00 00 00 |…#…|
0000c0b0 02 49 02 83 00 00 01 4b 01 10 61 65 65 65 65 66 |.I…K…aeeeef|
0000c0c0 66 66 03 01 06 00 00 20 ff a6 00 00 00 03 b9 02 |ff… …|
0000c0d0 00 00 00 02 49 03 84 00 00 01 4c 01 10 61 66 66 |…I…L…aff|
0000c0e0 66 00 00 00 00 00 00 00 00 00 00 00 00 00 00 00 |f…|
第一行数据:
03 02 02 01 /变长字段/ ---- 表中4个字段类型为varchar,而且没有NULL数据,并且每一个字段君小于255。
00 /NULL标志位,第一行没有null的数据/
00 00 10 00 25 /记录头信息,固定5个字节/
00 00 00 03 b9 00 /RowID,固定6个字节,表没有主键/
00 00 00 02 49 01 /事务ID,固定6个字节/
82 00 00 01 4a 01 10 /回滚指针,固定7个字节/
61 62 62 62 62 63 63 63 /列的数据/
解析 COMPACT 行记录时,需要先根据数据字典中的表结构解释变长字段长度列表和 NULL 标志,再定位固定 5 字节的记录头与隐藏字段。示例中的 03 02 02 01 依次描述四个 VARCHAR 字段的实际长度;具体顺序还要结合逆序存放规则和表定义判断,不能脱离元数据直接猜测。
溢出行问题

有些记录的字段太长了,一页装不下(一页中必须至少装两条记录),会导致页溢出(off page),有些数据被放在其他页里。
新版的 Barracuda 格式包括:Compressed 和 Dynamic。

InnoDB 数据页结构

InnoDB 管理数据库最小的磁盘单位是页。
- File Header(文件头)记录页在表空间中的位置、前后页指针等通用信息。
- Page Header(页头)记录 INDEX 页的槽数量、记录数量、空闲空间位置等元数据。
- Infimum 和 Supremum 是两条系统记录,分别作为页内记录链表的下界与上界。
- User Records 保存已经写入的行记录,记录之间通过页内指针保持逻辑顺序。
- Free Space 是尚未被记录占用的连续空间;删除产生的可复用记录空间还会由页内链表管理。
- Page Directory 是稀疏槽目录,用于先二分定位一组记录,再沿记录链表查找。
- File Trailer 保存校验和与页 LSN 的低位信息,用于检测页写入是否完整。
Page Directory
Page Directory(页目录)中存放了记录的相对位置(注意,这里存放的是页相对位置,而不是偏移量),有些时候这些记录指针称为Slots(槽)或者目录槽(Directory Slots)。与其他数据库系统不同的是,InnoDB并不是每个记录拥有一个槽,InnoDB存储引擎的槽是一个稀疏目录(sparse directory),即一个槽中可能属于(belong to)多个记录,最少属于4条记录,最多属于8条记录。
Slots 中的记录按键顺序存放,可以用二分查找定位记录指针。假设记录键为(i、d、c、b、e、g、l、h、f、j、k、a),且一个槽包含 4 条记录,则槽中的边界记录可能是(a、e、i)。
由于InnoDB存储引擎中Slots是稀疏目录,二叉查找的结果只是一个粗略的结果,所以InnoDB必须通过recorder header中的next_record来继续查找相关记录。同时,slots很好地解释了recorder header中的n_owned值的含义,即还有多少记录需要查找,因为这些记录并不包括在slots中。
B+Tree 索引先定位记录所在的页。页进入 Buffer Pool 后,InnoDB 再通过 Page Directory 二分定位相邻槽,并沿记录链表找到目标记录。后一段发生在内存中,成本通常远低于缺页时的存储 I/O。
这里的 slot 类似 Redis 的 Slot(不知道 Redis 是否受这个设计启发)。
字符集
在当代 InnoDB 里,如果使用了多字节字符集,则 CHAR(N) 指的是字符数而不是字节数。
约束
RDBMS 和 File System 之间的差别在于:RDBMS 支持格式、事务与约束(实体、参照、自定义)。
MySQL 支持:
- 数据类型
- 外键
- 触发器
- Default
MySQL 8.4 支持表级和列级 CHECK 约束,并默认执行约束检查。表达式结果为 FALSE 时拒绝写入,结果为 TRUE 或 UNKNOWN 时通过,因此禁止 NULL 仍需单独声明 NOT NULL。MySQL 8.4 官方文档
触发器
触发器由 BEFORE 或 AFTER 与 INSERT、UPDATE、DELETE 组合定义。MySQL 8.4 允许同一表在相同事件和时机上定义多个触发器,并可用 FOLLOWS 或 PRECEDES 控制顺序。MySQL 8.4 官方文档
视图
普通视图保存查询定义,本身不拥有独立表数据;查询视图时,优化器会根据视图算法和外层语句决定合并或物化中间结果。
物化视图
MySQL 8.4 没有原生 CREATE MATERIALIZED VIEW。需要预计算结果时,通常用普通表配合定时任务、触发器或增量计算维护;这类表能否写入取决于维护方案,不是数据库内置的只读对象。
分区表
MySQL 8.4 的表分区是水平分区:根据 RANGE、LIST、HASH 或 KEY 等规则把不同记录放入不同分区,不支持把同一表的不同列分到不同物理分区。MySQL 8.4 官方文档
分区只有在查询条件能触发 partition pruning、维护动作能受益于分区边界时才有价值。跨越大量分区的查询可能增加优化和访问成本,分区也不能替代合适的索引。
索引与算法
不恰当的索引设置可以使 iostat 里的磁盘利用率高达100%。
InnoDB 可创建 B+Tree 普通索引、FULLTEXT 全文索引和 SPATIAL 空间索引。USING HASH 不是 InnoDB 可创建的索引类型;自适应哈希索引是引擎内部的可选优化。MySQL 8.4 官方文档
聚簇索引的有序性是逻辑有序,不要求相邻页在磁盘上物理连续。页之间的链接和 B+Tree 路径共同支持范围访问,Buffer Pool 与预读再减少物理 I/O。

聚簇索引的非叶子节点上有指向其他节点的 pointer,叶子节点本身也是一个双链表。辅助索引上记录的索引值有时候被称作 bookmark。

辅助索引叶子记录保存主键值。查询未被辅助索引覆盖时,需要再回到聚簇索引取整行,称为回表。树高不能直接等价为物理 I/O 次数,因为根页和热点内部页通常已经缓存在 Buffer Pool 中。
索引管理

Fast Index Creation
早期 MySQL 执行部分索引 DDL 时,需要走完整的复制表流程:
- 按
ALTER TABLE后的结构创建临时表。 - 把原表中的数据导入到临时表。
- 删除原表。
- 把临时表重命名为原表名。
Fast Index Creation(FIC)是此后的一项过渡性改进:创建或删除辅助索引不再总是复制整张表,但操作期间仍可能阻塞写入,主键变更也可能需要重建表。理解现代版本时,应继续看下一节的 Online DDL 算法与锁级别,不能只套用 FIC 的历史规则。
Online DDL
MySQL 8.4 的 InnoDB Online DDL 会根据具体操作选择 INSTANT、INPLACE 或 COPY。支持 INSTANT 的变更只修改元数据,但仍可能短暂取得排他的元数据锁;INPLACE 也不代表所有阶段都无锁,更不代表一定无需重建数据。MySQL 8.4 官方文档
需要强制验证执行路径时,可以显式指定 ALGORITHM=INSTANT 或 ALGORITHM=INPLACE,让不支持的操作直接报错。大表变更还应评估元数据锁、临时空间、redo 生成量和复制延迟;gh-ost、pt-online-schema-change 等外部工具解决的是另一套在线迁移问题。
Cardinality
Cardinality 是优化器估算索引选择性的统计值。InnoDB 可以通过采样生成持久化统计,因此它是估算值而非精确计数;分布发生明显变化时可用 ANALYZE TABLE 重新采样,但仍应通过执行计划和实际行数验证估算质量。
索引选择
优化器会比较候选访问路径的成本,覆盖索引、回表次数、扫描范围、排序和连接顺序都会影响结果。范围查询和连接并不天然导致全表扫描;是否使用索引取决于选择性、统计信息和成本估算。
遇到索引选择异常时,应先检查 EXPLAIN ANALYZE、统计信息与数据分布。FORCE INDEX 会强约束访问路径,只适合在可复现证据表明优化器持续选错、且已经评估版本与数据变化风险时使用。
ICP 优化
Index Condition Pushdown(执行计划中常见 Using index condition)把部分条件下推到存储引擎,在回表前过滤不匹配的索引记录,从而减少聚簇索引访问。
全文检索
FULLTEXT 索引使用倒排结构支持自然语言、布尔模式等文本检索。它有分词、停用词和最小词长等限制,不等于任意子串搜索。
锁
理解 InnoDB 锁时,需要同时区分表级意向锁、记录锁、间隙锁和 Next-Key Lock;名称相似不代表锁定对象或冲突规则相同。
什么是锁
并发控制由锁、MVCC 和事务隔离共同完成。普通一致性读通常依赖快照,写操作和锁定读则需要对访问到的记录或范围加锁。
MySQL 对 LRU 列表的操作都是需要锁的。
Lock 和 Latch
Lock 保护事务可见的数据,生命周期通常跨越语句甚至整个事务;Latch 保护 InnoDB 内部内存结构,持有时间短,服务于线程间同步。两者的对象、持有者和死锁处理方式不同。
InnoDB 里的锁
锁的类型
- X Lock
- S Lock
InnoDB 存储引擎支持多颗粒度(grannular)锁定。把上锁对象看作一棵树,加锁要先在粗颗粒度上加锁,任意一部分的锁等待,都会让事务操作阻塞。

一致性非锁定读

普通 SELECT 在 READ COMMITTED 和 REPEATABLE READ 下通常执行一致性非锁定读,通过 MVCC 读取快照版本,不给扫描到的记录加行锁。RC 每次一致性读建立新快照;RR 通常复用事务中第一次一致性读建立的快照。MySQL 8.4 官方文档
锁定读
需要读取最新可用版本并保护后续修改条件时,使用锁定读:
SELECT ... FOR SHARESELECT ... FOR UPDATE
锁定读会等待相关记录上的冲突锁释放,并按照索引访问范围设置记录锁、间隙锁或 Next-Key Lock。它不使用一致性读的历史快照语义。MySQL 8.4 官方文档
外键与锁
InnoDB 要求外键列上存在可用索引;如果没有合适索引,建表或加约束时会自动创建。外键检查仍可能设置共享记录锁,并参与锁等待或死锁,不能把“自动建索引”理解为“不会死锁”。
锁的算法
- Record Lock
- Gap-Lock
- Next-Key-Lock
锁定范围由隔离级别、使用的索引、搜索条件和实际扫描范围共同决定。在默认 RR 下,唯一索引等值查询命中唯一记录时通常退化为记录锁;未命中、非唯一条件、只使用联合唯一索引前缀或执行范围扫描时,可能锁住相邻间隙。RC 通常关闭用于搜索和扫描的 gap locking,但外键检查与重复键检查等场景仍是例外。
解决 Phantom Problem
这本书把不可重复读窄化为 Phantom Problem,把 Phantom Problem 窄化为看不到原本看不到的行。
唯一性必须由 UNIQUE 约束保证,而不是依赖“先查再插”的应用层检查:
1 | |
“先查再插”在两个语句之间存在竞态窗口,即使使用锁定读,也必须明确事务边界、索引和隔离级别。数据库唯一约束才是最终防线;应用应捕获重复键错误,并对死锁或锁等待超时执行有界重试。
锁问题
脏页:缓冲池被修改但没有被持久化的页。
脏数据:事务对缓冲池中行记录的修改,并没有被提交。
如果读到了脏数据,即一个事务可以读到另外一个事务未提交的数据,违反了数据库的隔离性。
脏读可能发生在 READ UNCOMMITTED。InnoDB 默认隔离级别是 REPEATABLE READ。
如果可以的话,应该在数据库层面解决丢失更新和各种脏读写的问题。
阻塞
innodb 在很多情况下可以抛出异常,但遇到异常是应该提交事务还是回滚事务是需要专门配置的:
- innodb_lock_wait_timeout 等待时间到抛出异常
- innodb_rollback_on_timeout 遇到超时是否回滚
死锁
解决死锁最简单的方式就是把任何等待都转化为回滚(而不是等待),但这会降低并发事务完成数量。也可以通过等待超时再回滚的方式来处理(等待超时有可能是正在产生死锁还未检测出来,也可能没有遇到死锁,只是不想等超长操作完成了),这就是实践中大家选择的方案。
当前数据库普遍使用 wait-for-graph (基于锁的信息链表和事务等待链表构建)来进行死锁检测。


大部分的情况下,InnoDB 对异常的处理方法都是可配的,但一旦它检测到死锁,存储引擎会立刻回滚一个事务。
锁升级
Lock Escalation 是很多数据库需要考虑的情况。InnoDB 使用位图来管理锁。在 SQL Server里,大量加锁会增大开销,所以锁可能会升级(如用一个表锁代替1000个行锁),锁升级减少了管理锁的成本,但是降低了并发性。但 MySQL 里不存在这个问题。
小结
一个高性能、高并发的数据库应用必须建立在充分理解锁的基础上。
事务
事务把一组操作组织为一个提交或回滚单元。ACID 分别约束原子性、一致性、隔离性和持久性;这些性质由数据库、存储引擎、配置和应用共同实现。
认识事务
InnoDB 事务可以选择不同隔离级别。持久性强度还受 redo 刷盘配置和底层存储语义影响,不能只凭隔离级别判断事务是否有效。
事务的分类
扁平事务(Flat Transactions)

扁平事务(Flat Transaction)是事务类型中最简单的一种,但在实际生产环境中,这可能是使用最为频繁的事务。在扁平事务中,所有操作都处于同一层次,其由 BEGIN WORK开始,由COMMIT WORK或ROLLBACK WORK结束,其间的操作是原子的,要么都执行,要么都回滚。因此扁平事务是应用程序成为原子操作的基本组成模块。
带保存点的扁平事务(Flat Transactions with Savepoint)
扁平事务不能独立提交其中一部分。保存点允许用 SAVEPOINT 标记事务内位置,并通过 ROLLBACK TO SAVEPOINT 撤销之后的修改;这仍然是同一个事务,只有最外层 COMMIT 才产生持久提交。

链事务(Chained Transactions)

嵌套事务(Nested Transactions)
嵌套事务是一个层次结构框架:顶层事务控制子事务,子事务的局部提交只有在祖先事务最终提交后才生效。InnoDB 和 JDBC 都不原生提供这种完整语义;常见框架里的“嵌套事务”往往只是保存点模拟。

Moss对嵌套事务的定义: (1)嵌套事务是由若干事务组成的一棵树,子树既可以是嵌套事务,也可以是扁平事务。
(2)处在叶节点的事务是扁平事务。但是每个子事务从根到叶节点的距离可以是不同的。
(3)位于根节点的事务称为顶层事务,其他事务称为子事务。事务的前驱(predecessor)称为父事务,事务的下一层称为儿子事务。
(4)子事务既可以提交也可以回滚。但是它的提交操作并不马上生效,除非其父事务已经提交。因此可以推论出,任何子事物都在顶层事务提交后才真正的提交。
(5)树中的任意一个事务的回滚会引起它的所有子事务一同回滚,故子事务仅保留A、C、I特性,不具有D的特性。在Moss的理论中,高层的事务仅负责逻辑控制,叶子节点完成实际的工作。

分布式事务(Distributed Transactions)
通常是一个在分布式环境下运行的扁平事务,因此需要根据数据所在位置访问网络中的不同节点。
假设一个用户在ATM机进行银行的转账操作,例如持卡人从招商银行的储蓄卡转账10000元到工商银行的储蓄卡。在这种情况下,可以将ATM机视为节点A,招商银行的后台数据库视为节点B,工商银行的后台数据库视为C,这个转账的操作可分解为以下的步骤:
- 节点A发出转账命令
- 节点B执行储蓄卡中的余额值减去10000
- 节点C执行储蓄卡中的余额值加上10000
- 节点A通知用户操作完成或者节点A通知用户操作失败。
这里需要使用分布式事务,因为节点A不能通过调用一台数据库就完成任务。其需要访问网络中两个节点的数据库,而在每个节点的数据库执行的事务操作又都是扁平的。对于分布式事务,其同样需要满足ACID特性,要么都发生,要么都失效。对于上述的例子,如果2)、3)步中任何一个操作失败,都会导致整个分布式事务回滚。若非这样,结果会非常可怕。
小结
InnoDB 支持普通事务、保存点和 XA 分布式事务,但不原生支持完整的嵌套事务模型。保存点只能模拟同一事务内的局部回滚,不能提供独立子事务或并行提交语义。
事务的实现
redo 和 undo 分工不同。redo 记录页修改,支持崩溃后的前滚恢复;undo 保存回滚信息,并为一致性读重建旧版本。提交协议把两者与事务状态结合起来,才能同时满足原子性和持久性。
redo log
redo 的写入经历日志生成、写入 redo log buffer、写到操作系统以及持久化到设备几个阶段。事务提交需要完成到哪一步,由 innodb_flush_log_at_trx_commit 等配置决定;数据页不必在提交时同步写回。
MySQL 8.4 的 redo 文件位于 #innodb_redo,总容量由 innodb_redo_log_capacity 控制。容量有限,因此 checkpoint 必须持续推进,旧的日志区间才能安全复用。

redo 在事务执行过程中持续产生,binlog 主要在提交阶段进入提交流程。MySQL 使用内部 XA 和组提交协调两种日志,避免出现一边提交、另一边缺失的状态。
提交策略与大事务
innodb_flush_log_at_trx_commit=2 时,事务提交会把 redo 写到操作系统,但通常不要求每次提交都立即刷新到稳定存储。数据库进程崩溃而操作系统仍正常时,日志仍可能由操作系统写回;整机或存储故障则可能丢失最近一段事务。
把大量写入放进单个事务可以减少提交次数,但不能保证整个过程中只发生一次日志刷新。事务过大还会延长锁持有时间、扩大 undo 和恢复成本,并增加复制延迟。批量任务通常按业务可重试边界拆成有限大小的事务。
log block
redo log block 的长度为 512 字节。这个布局有利于日志组织和校验,但不能脱离设备、控制器与文件系统语义,直接宣称所有写入都具备原子性。

恢复
异常关闭后,InnoDB 从 checkpoint 标识的恢复起点附近扫描 redo,把已记录但尚未反映到数据文件中的修改重新应用。未提交事务留下的修改还需要通过 undo 回滚。恢复不是“回到 checkpoint”,而是从 checkpoint 出发重建可持久化的事务状态。
undo log
undo 保存行修改前的信息,支持事务回滚和一致性读。回滚恢复的是逻辑记录状态,不保证页的物理布局回到修改前;即使事务回滚,已经扩展的表空间文件也不会自动缩小。
undo 页自身的修改同样需要 redo 保护。事务提交后,仍可能有一致性读需要旧版本,因此相关 undo 不能立刻删除。
undo log 日志格式


purge 与 history list
一致性读先检查聚簇索引中的当前记录版本;如果该版本对快照不可见,再沿 undo 版本链重建更早版本。ReadView 保存的是事务可见性边界与活跃事务集合,不保存“已提交行版本列表”。
History list 组织等待 purge 的已提交 undo 记录。Purge 只有在旧版本不再被任何 ReadView 需要时才能清理它们,并会尽量批量处理同一 undo 页中的记录以减少随机 I/O。

group commit
Group commit 把多个事务的日志刷新合并成更少的 I/O,同时由提交协议维持 redo 与 binlog 的顺序关系。

MVCC 实现机制
MVCC(Multi-Version Concurrency Control)让普通一致性读通过快照选择记录版本,不给扫描到的记录加行锁,也不会读取其他事务尚未提交的修改。MySQL 8.4 官方文档

ReadView 的结构
从实现角度看,ReadView 需要表达以下信息。不同源码版本的字段名可能变化,理解时应以语义为主:
| 概念 | 常见源码字段 | 说明 |
|---|---|---|
| 创建者事务 | m_creator_trx_id |
当前事务自己的修改对自己可见 |
| 活跃读写事务集合 | m_ids |
创建快照时需要排除的事务 ID |
| 最小活跃事务边界 | m_up_limit_id |
小于此边界的版本通常在快照建立前已经完成 |
| 尚未分配的事务边界 | m_low_limit_id |
不小于此边界的事务 ID 属于快照建立之后 |
这些字段属于实现细节。快照可以看到建立前已提交的修改,也能看到本事务此前完成的修改。其他事务在快照建立后提交或仍未提交的修改不可见。
版本链的遍历规则
聚簇索引记录的隐藏字段 DB_TRX_ID 标识最后修改它的事务。教学上可以把可见性判断概括为:
- 修改来自当前事务时,版本可见。
- 事务 ID 小于最小活跃边界时,版本通常可见。
- 事务 ID 不小于尚未分配边界时,版本不可见。
- 位于两个边界之间时,若事务仍在活跃集合中则不可见,否则可见。
当前版本不可见时,InnoDB 沿 undo 指针继续检查更早版本,直到找到可见版本或到达版本链末端。
RC 和 RR 的快照时机
| 隔离级别 | ReadView 创建时机 | 效果 |
|---|---|---|
READ COMMITTED |
每次一致性非锁定读建立新快照 | 后一次读取可以看到期间新提交的修改,因此可能不可重复读 |
REPEATABLE READ |
通常由第一次一致性非锁定读建立快照,后续一致性读复用 | 同一事务中的一致性读保持同一快照 |
START TRANSACTION WITH CONSISTENT SNAPSHOT 可以在事务开始阶段建立快照。锁定读、UPDATE 和 DELETE 不使用历史快照读取规则。
快照读与当前读
| 读类型 | 说明 | 语句示例 |
|---|---|---|
| 快照读 | 通过 MVCC 读取快照可见版本,不加行锁 | SELECT * FROM t WHERE id = 1 |
| 当前读 | 读取最新可用版本,并按访问范围加锁 | SELECT ... FOR SHARE、SELECT ... FOR UPDATE、UPDATE、DELETE |
在 RR 下,快照读避免普通一致性读中的不可重复读;需要保护范围内不存在新插入记录时,锁定读依赖 Next-Key Lock。两种读取方式不能混用同一套可见性解释。
事务的隔离级别
InnoDB 支持 READ UNCOMMITTED、READ COMMITTED、REPEATABLE READ 和 SERIALIZABLE。隔离级别越高,通常允许的并发现象越少,但实际锁范围和性能还取决于 SQL、索引与访问顺序。
REPEATABLE READ 不等同于 SERIALIZABLE。前者使用一致性快照与范围锁实现默认隔离语义;后者会把普通 SELECT 进一步转向共享锁语义,约束更强。在 RC 下,用于普通搜索和扫描的 gap locking 通常关闭,但外键检查和重复键检查等场景仍可能使用间隙锁。
分布式事务
MySQL 分布式事务
InnoDB 支持 XA 事务。此处的分布式允许多个独立的数据源(transactional resources)参与到一个全局的事务中。

XA 使用两阶段提交:事务管理器先让每个分支执行 XA PREPARE,只有所有分支都准备成功,才进入 XA COMMIT;任一分支失败则执行 XA ROLLBACK。应用代码不应自行拼装一个没有故障恢复、超时处理和悬挂事务清理能力的“简化版协调器”。生产环境通常由成熟的事务管理器或中间件负责协调,并通过 XA RECOVER 处理待决事务。13
内部 XA 事务
MySQL 在服务层的 binlog 与 InnoDB 之间采用内部 XA 协议,使事务提交结果能够同时反映在 redo log 与 binlog 中。这是复制与崩溃恢复保持一致的基础,不等于业务跨库 XA。

不好的事务习惯
在循环中提交事务
逐行提交会放大日志刷盘和网络往返开销,也会让失败后的恢复边界变得零散。批处理任务应按可恢复的业务边界分批提交,并记录进度;批次大小需要结合锁持有时间、redo 生成量和失败重试成本确定。
使用自动提交
autocommit=1 适合彼此独立的单条语句。多条语句必须作为一个原子单元时,应显式使用 START TRANSACTION、COMMIT 和 ROLLBACK,并把事务范围控制在必要区间。不要仅为“统一风格”全局关闭自动提交。
正确处理回滚
语句报错不代表整个事务已经自动回滚。应用必须检查数据库返回的错误,并根据错误类型决定重试、回滚当前事务或终止任务。连接断开时,服务端会回滚未提交事务,但应用仍需保留足够的日志和幂等信息,才能判断业务动作是否需要重放。
长事务
长事务会长期保留旧版本、推高 undo history、延迟 purge,并延长锁持有和故障回滚时间。可拆分的离线任务应使用带进度记录的 mini-batch;必须保持全局原子性的业务不能机械拆分,应先缩小扫描范围、稳定访问顺序并评估资源上限。
InnoDB vs MyISAM 对比
InnoDB 和 MyISAM 是 MySQL 中最常用的两种存储引擎。InnoDB 是 MySQL 5.5.5 之后的默认存储引擎,而 MyISAM 在早期版本中是默认引擎。
选择合适的存储引擎需要根据应用场景、性能需求、数据一致性要求等多方面因素综合考虑。
主要特性对比
| 特性 | InnoDB | MyISAM |
|---|---|---|
| 事务支持 | 支持 ACID 事务 | 不支持事务 |
| 锁粒度 | 行级锁 | 表级锁 |
| 外键约束 | 支持 | 不支持 |
| 崩溃后的处理 | 自动恢复已提交事务并回滚未提交事务 | 可能需要检查或修复表 |
| 并发控制 | 行锁、MVCC 与必要的范围锁 | 表锁 |
| 全文索引 | 支持,但行为和限制需按版本验证 | 支持 |
| 空间索引 | 支持 | 支持 |
COUNT(*) |
无过滤条件时通常需要扫描索引 | 无过滤条件且没有并发写入语义要求时可直接读取保存的行数 |
适用场景
InnoDB 适用场景
- 需要事务支持的应用(金融、订单、支付等)
- 高并发读写的场景
- 数据一致性要求高的场景
- 需要外键约束的应用
- 需要崩溃恢复能力的场景
MyISAM 适用场景
MyISAM 主要用于维护遗留系统,或少量明确接受表锁、无事务和有限崩溃恢复能力的只读或可重建数据。博客、论坛等业务类型本身不是选择 MyISAM 的理由;只要存在并发写入、数据一致性或在线维护要求,就应优先使用 InnoDB。两种引擎都支持空间索引,具体限制应按目标版本核对。14
迁移建议
对于新建项目,建议直接使用 InnoDB 存储引擎。对于现有使用 MyISAM 的项目,可以根据实际需求评估是否需要迁移到 InnoDB。
迁移到 InnoDB 的注意事项:
- 约束与事务边界:确认应用是否依赖 MyISAM 忽略外键或部分写入的历史行为
- 自增主键:检查批量插入、回滚与复制场景下的自增值使用方式
- 全文与空间索引:按目标版本验证语法、数据类型和查询结果
- 容量与性能:用真实数据比较索引大小、写放大、缓存命中率与延迟
- 切换与回退:准备校验、停写窗口或在线迁移方案,并保留可验证的回退路径